PyPI привлекает из американского Google около 153 000 посетителей в месяц, и все благодаря простой странице для каждого пакета Python, названной ровно так, как его ищут программисты.
В каталоге PyPI (Python Package Index) программисты берут пакеты, то есть готовые дополнения к языку Python. У каждого пакета там своя страница.
Мы прогнали PyPI через все наши SEO-инструменты и выяснили, за счет чего эти страницы выигрывают и как PyPI следит, чтобы многочисленные старые копии не путались под ногами.
Ниже 9 уроков, которые можно перенять, и то, что повторить не выйдет.
Дайте каждому пакету свою страницу
Начали мы с нашего инструмента «Проверка органического трафика». Он оценивает органический трафик сайта, то есть людей, которые находят его в Google сами, без рекламы.
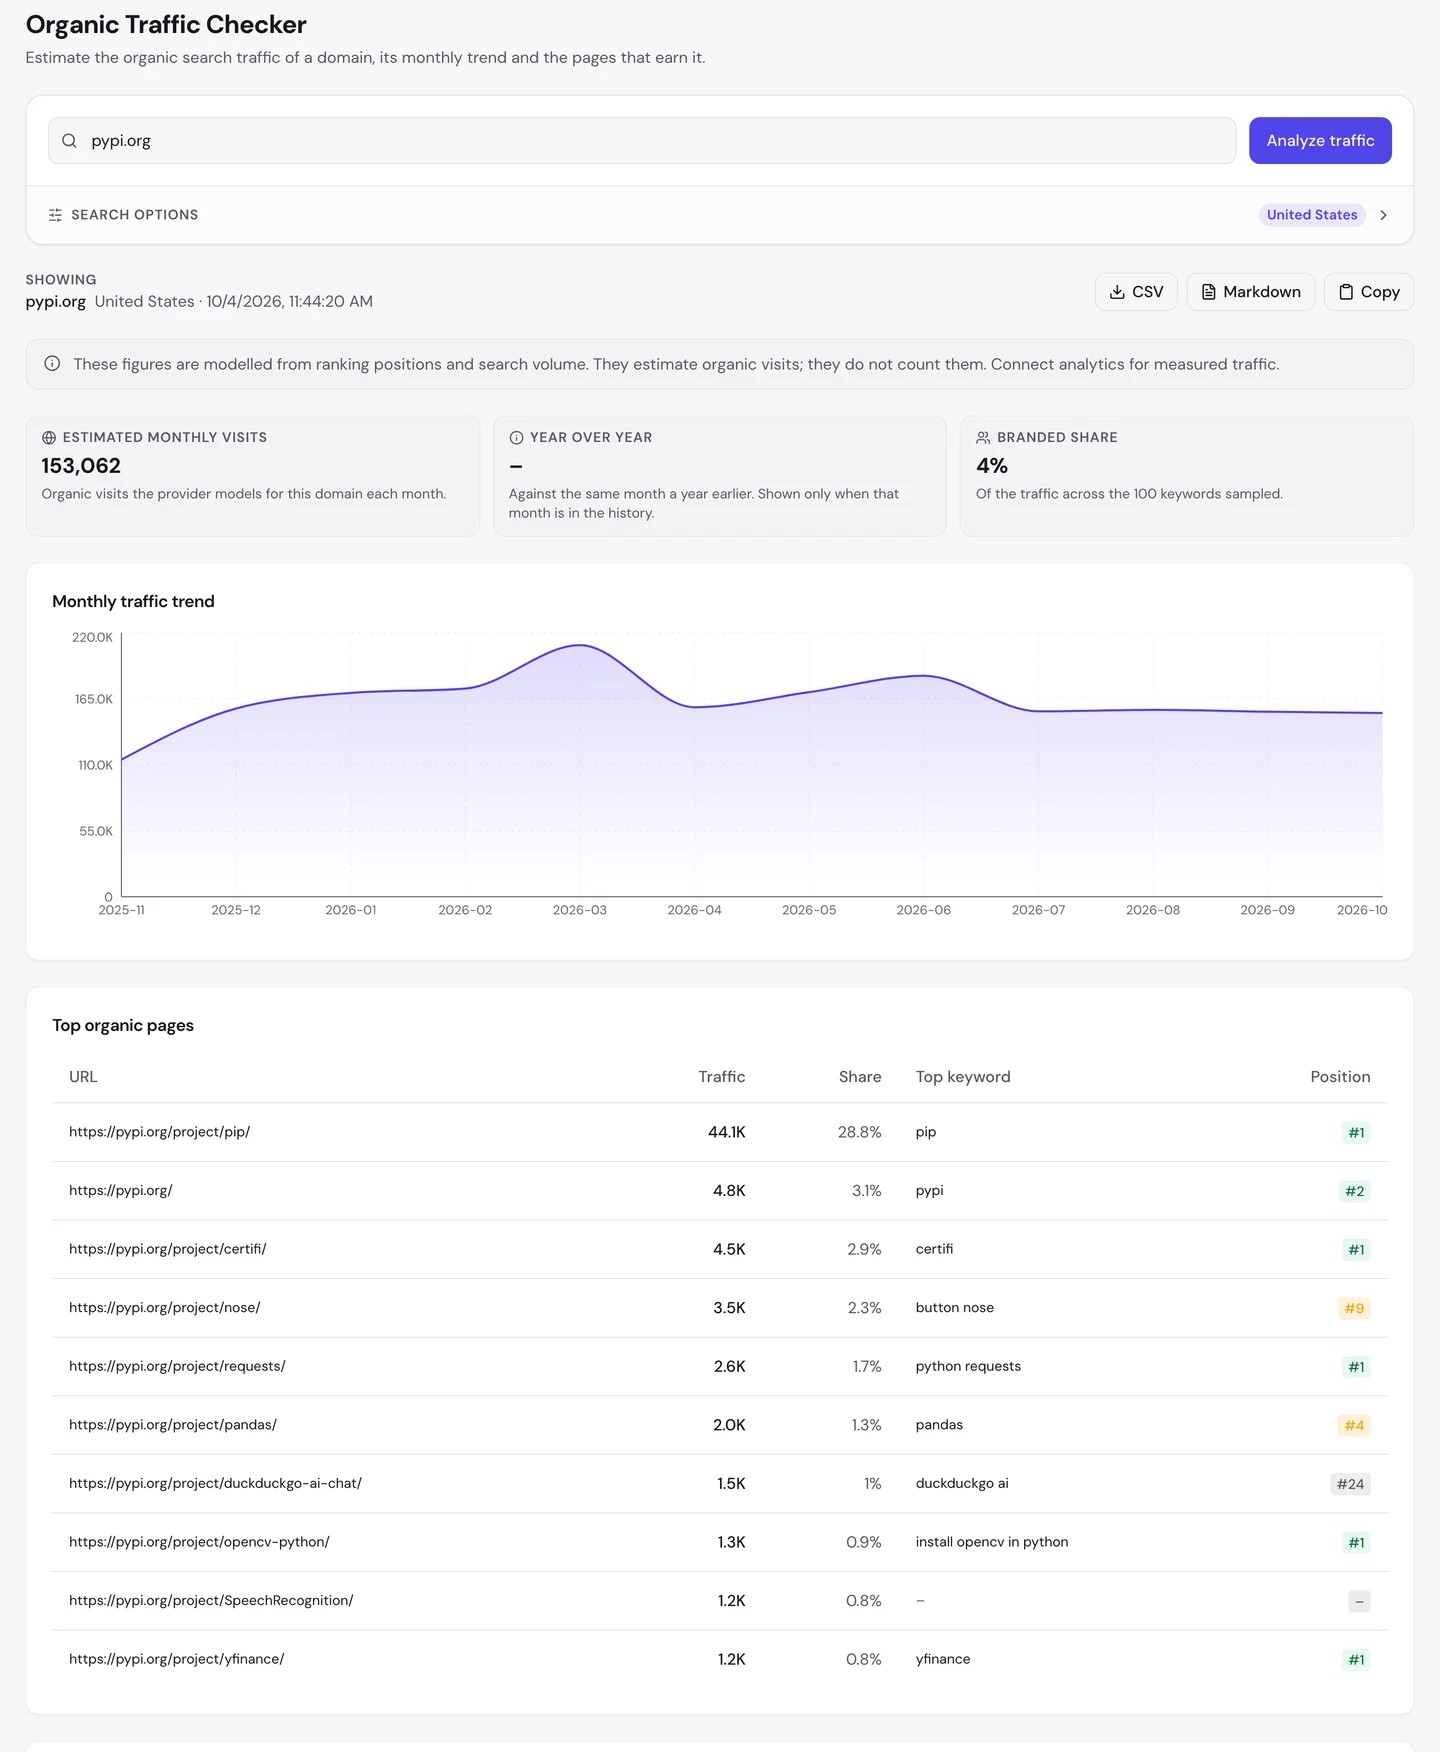
У pypi.org это около 153 тыс. посещений в месяц из США. И только 4% из них приходится на людей, которые вводили само название PyPI.
Выходит, примерно 24 из 25 посетителей вообще не искали PyPI. Они ввели название пакета, и Google отправил их на его страницу.
Особенно выделяется одна страница, pip. Она приносит около 44 тыс. посещений, почти 1 из каждых 3.
С помощью pip программисты устанавливают пакеты. Вот его страница.
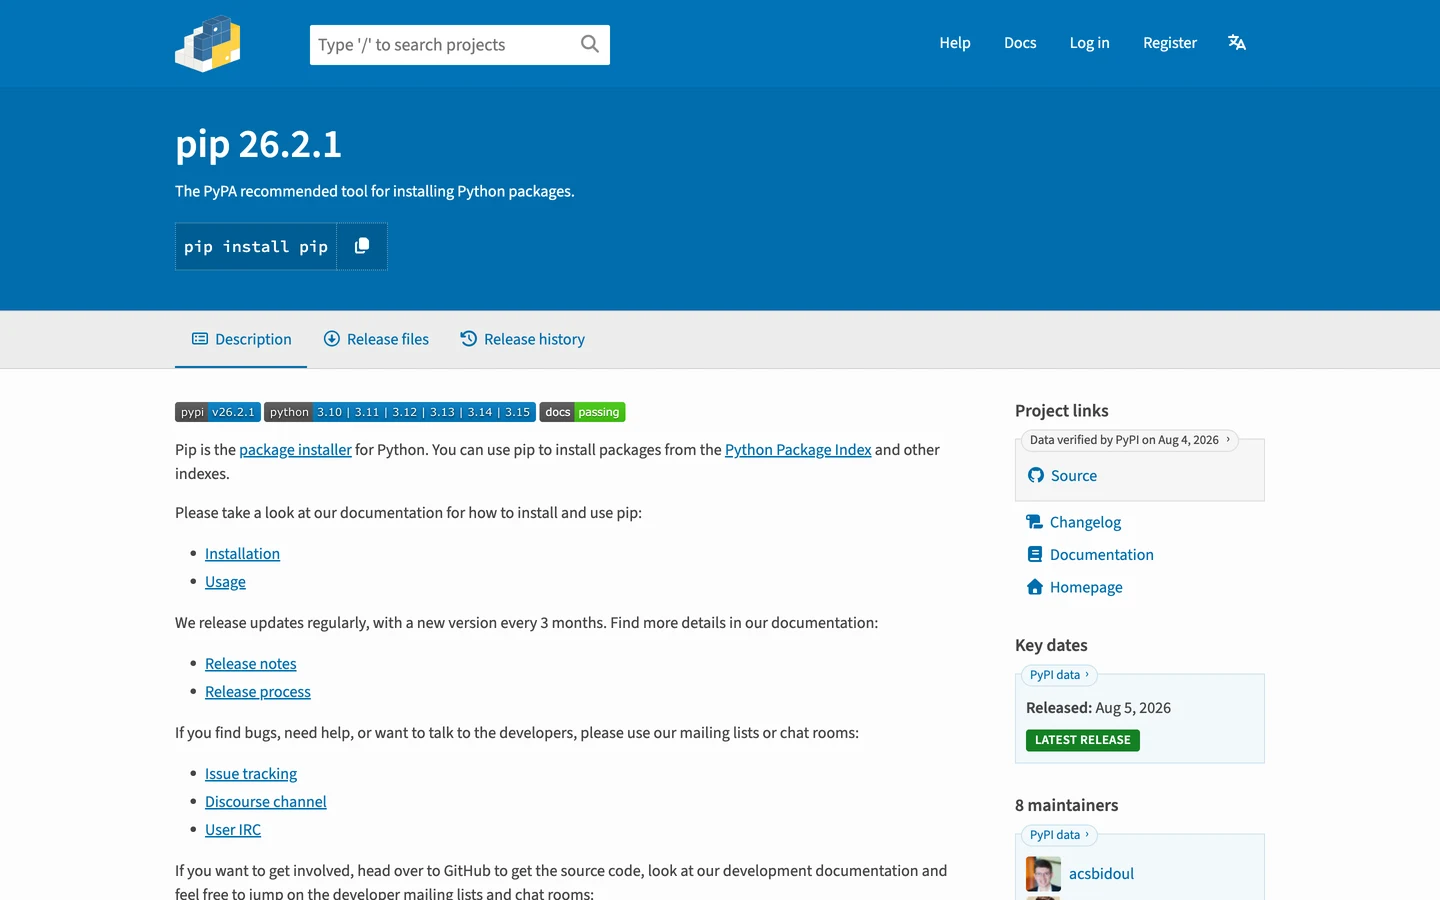
На ней есть название, описание в одну строку и команда, которую нужно скопировать для установки. Если вы пришли установить пакет, больше ничего и не нужно.
Вкладка Traffic (трафик) в нашем инструменте «Аудит сайта» показывает картину по всему миру, а не только по США.
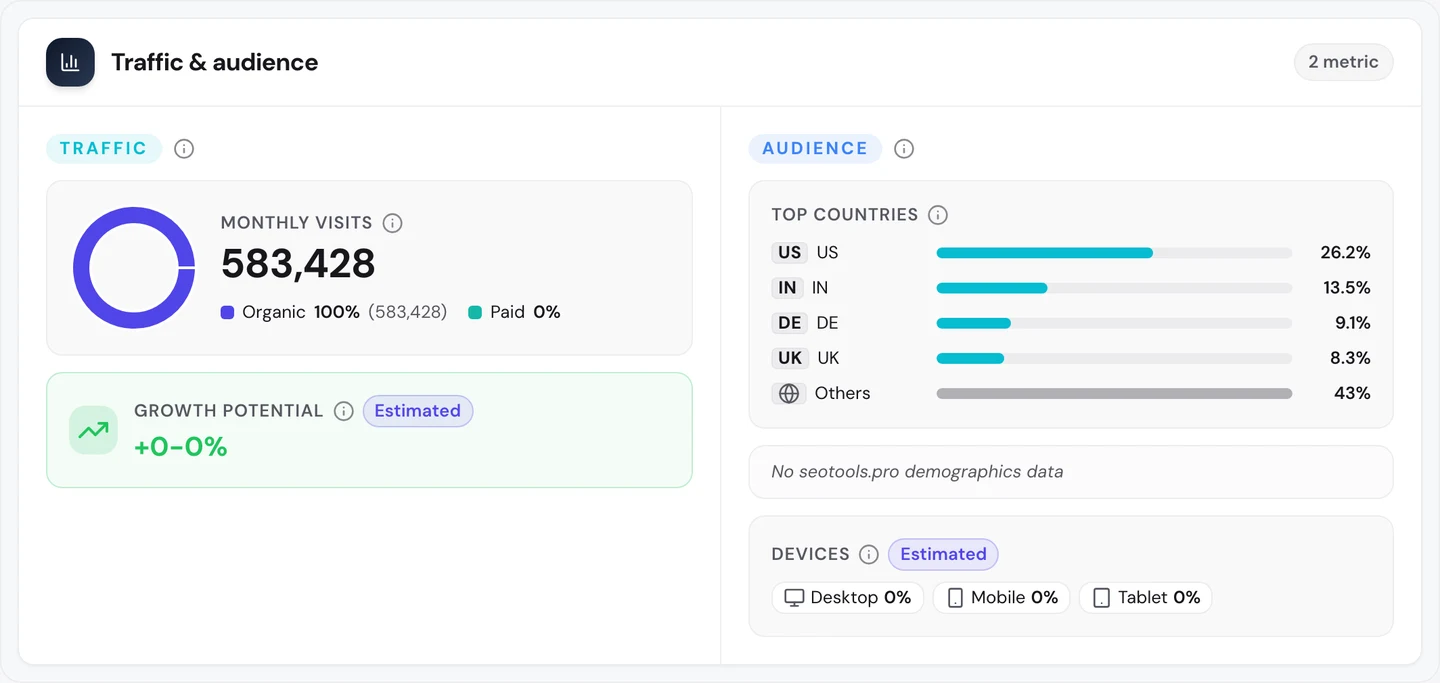
По всему миру PyPI привлекает около 580 тыс. посещений из поиска в месяц и не платит ни за одно из них. Из США приходит примерно 1 из 4, а следом идет Индия.
Docker Hub, который мы тоже разбирали, устроен так же: у каждой программы там своя страница.
Так что дайте каждому своему продукту отдельную страницу с его названием. А потом посмотрите в нашем инструменте «Проверка органического трафика», какие из ваших страниц приносят посещения.
Назовите страницу так, как ее ищут
Вкладка Keywords (ключевые слова) в нашем аудите показывает запросы, по которым сайт попадает в выдачу. Ключевым словом называют любой запрос, который люди вводят в поиск. На вкладке видно ваше место по каждому такому запросу и сколько посещений он приносит.
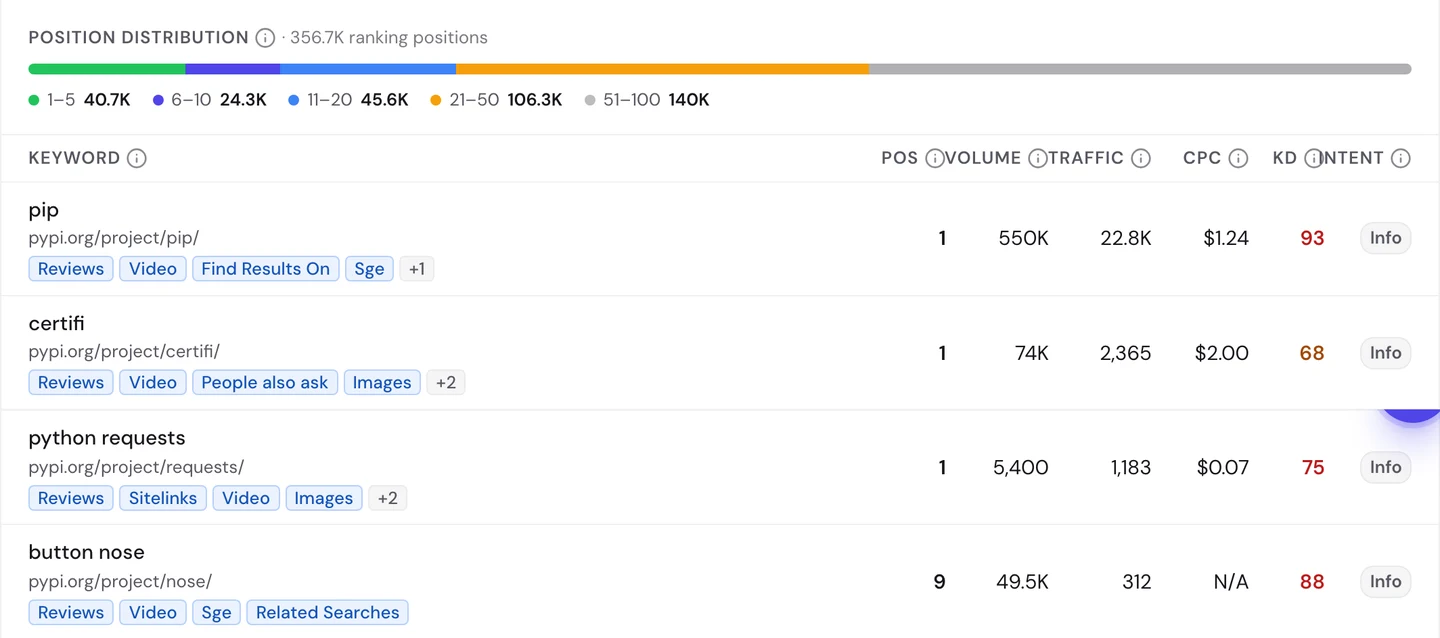
Посмотрите на первую строку. Человек вводит «pip», и страница pip на PyPI оказывается первой в выдаче.
Этот запрос вводят около 550 тыс. раз в месяц. Страница выигрывает, потому что ее название и адрес слово в слово совпадают с тем, что вы ввели.
Так же и с certifi, пакетом, который помогает Python проверять защищенные сайты. Он тоже на первом месте по собственному названию.
Страница requests стоит на первом месте по запросу «python requests». С помощью пакета requests ваш код общается с сайтами.
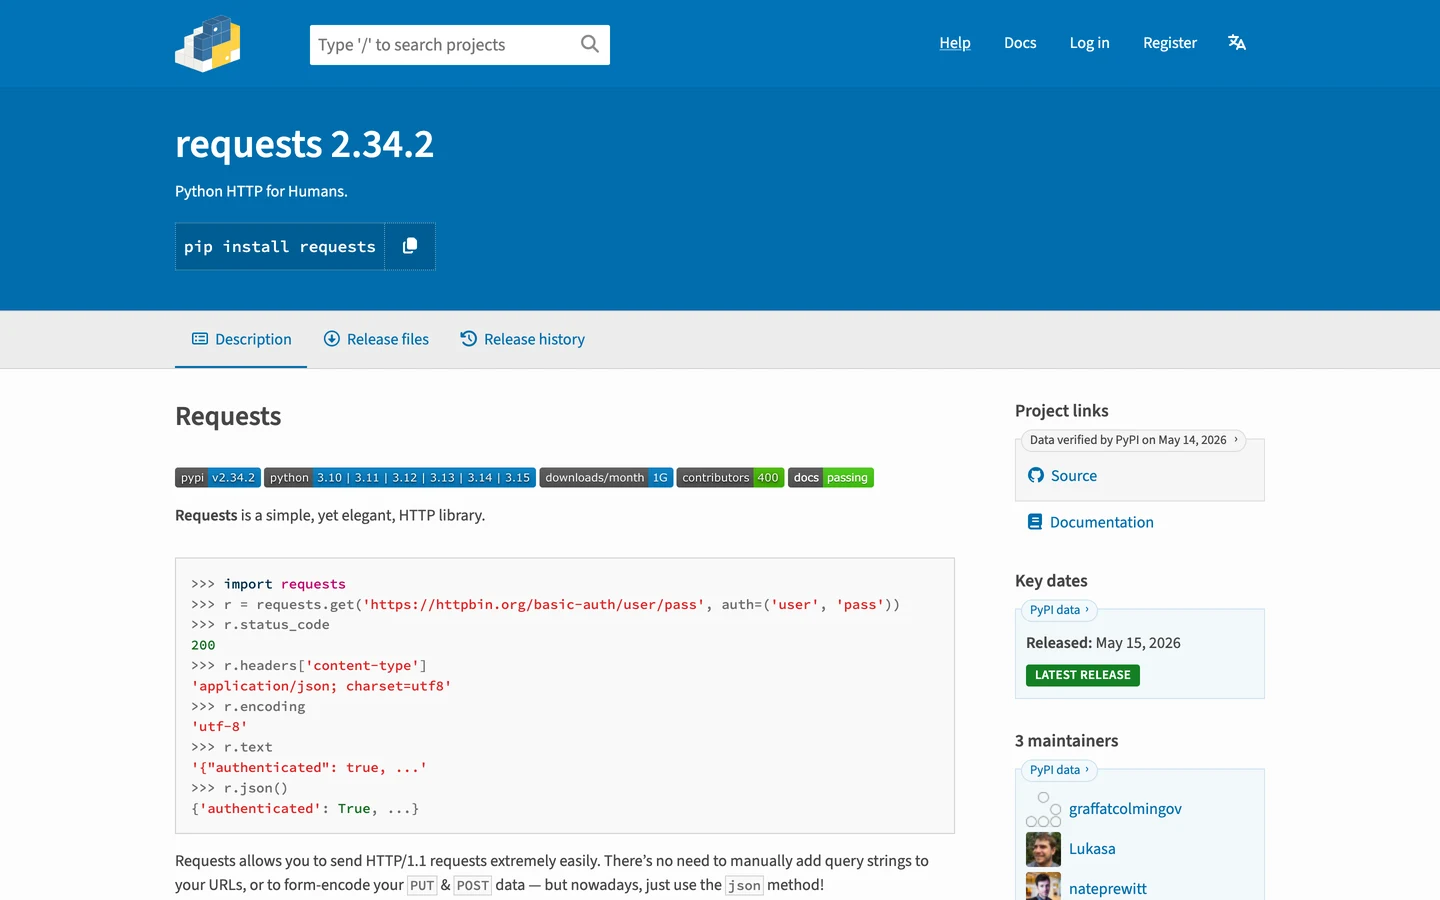
Она устроена точно так же, как страница pip. Все страницы пакетов собраны по одному шаблону, то есть по общему для всех макету.
Наш инструмент «Проверка органического трафика» нашел и другие такие примеры. Страница opencv-python на первом месте по запросу «install opencv in python», а yfinance лидирует по собственному названию.
Но у совпадения по названию есть и обратная сторона. Страница nose, старого пакета для тестирования, стоит на 9-м месте по запросу «button nose».
Этот запрос вводят около 50 тыс. раз в месяц. Людям был нужен милый курносый носик, а не кусок кода.
Если у вас сайт для программистов, дальше стоит почитать наш разбор PHP.net, официального сайта еще одного языка программирования.
Так что называйте каждую страницу точным словом, которое вводят люди, и проверяйте, по каким запросам она на самом деле выигрывает. Наш инструмент «Исследование ключевых слов» покажет, какими словами люди ищут.
Пишите заголовки и описания полнее
Попасть высоко в выдачу значит сделать только полдела. Когда вы уже на странице результатов, кликнут ли по вам, решают заголовок и описание.
Наше бесплатное расширение для браузера показывает, как устроена страница. Откройте ее, нажмите на значок seotools.pro, и рядом появится панель с 35 SEO-проверками.
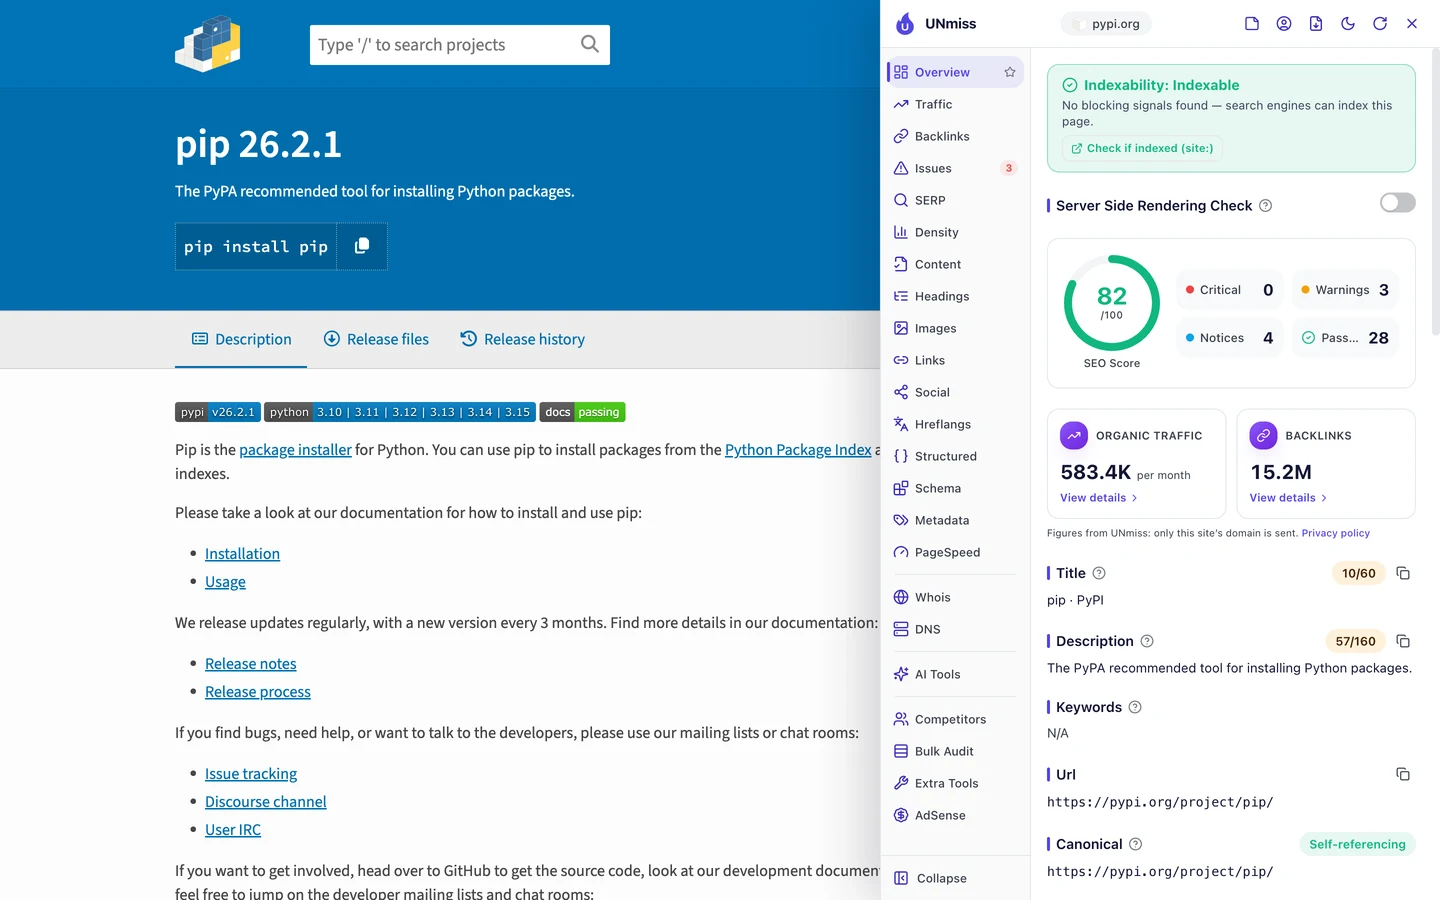
Страница pip набирает 82 балла из 100. Ее заголовок «pip · PyPI» состоит всего из 10 символов.
В описании коротко сказано, о чем страница, и Google может показать его под вашим заголовком. У pip это одна строка, которую написали создатели пакета: «The PyPA recommended tool for installing Python packages.»
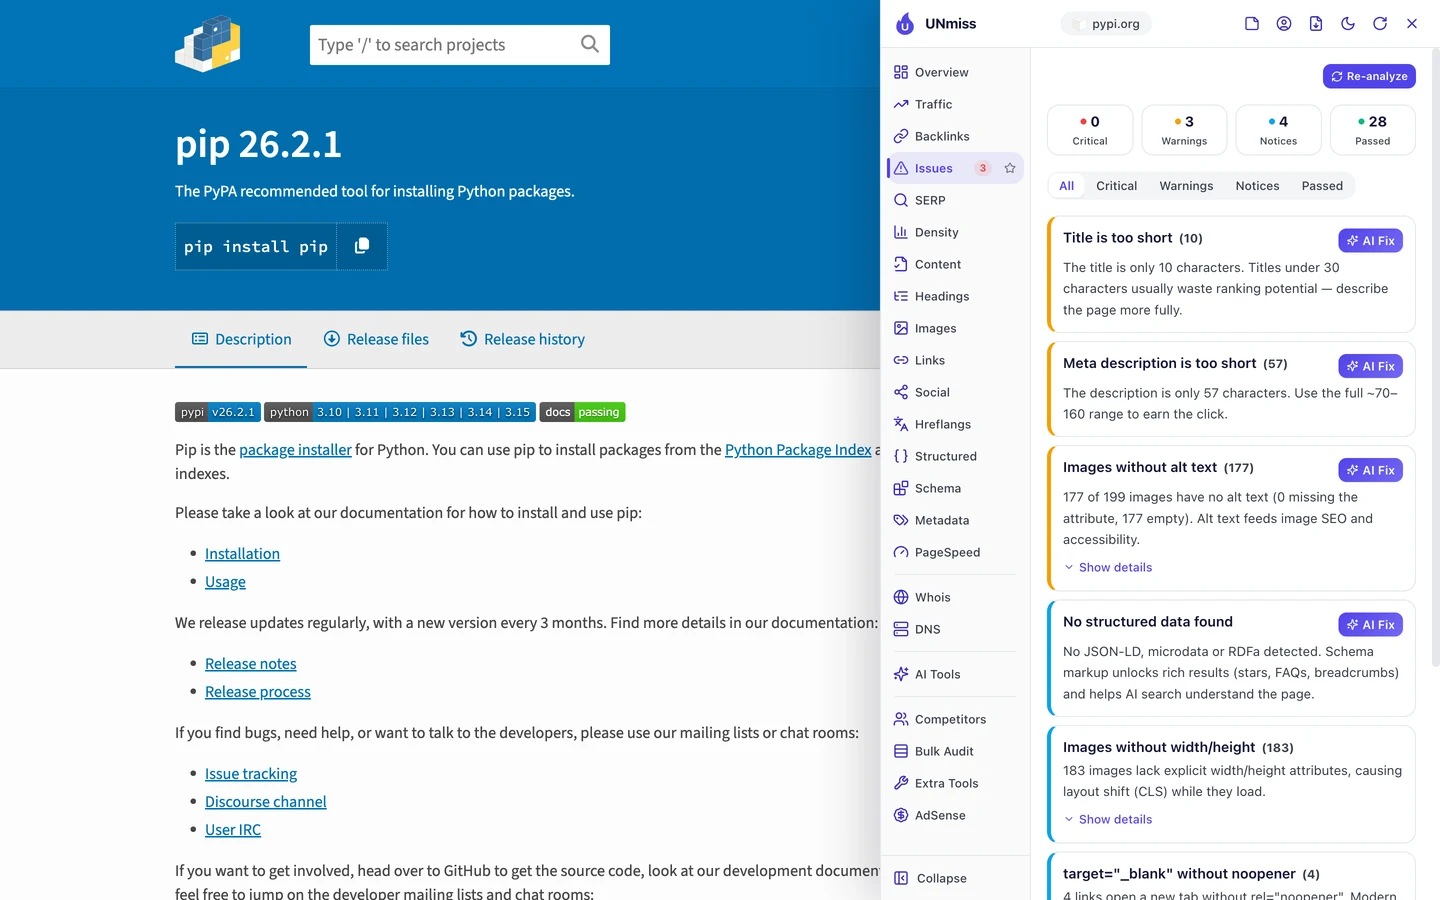
На вкладке Issues (проблемы) оба пункта стоят на самом верху. В заголовке можно было бы сказать, что делает pip, а в описание поместится еще 100 символов.
Теперь сравните со страницей requests. Шаблон у нее тот же.
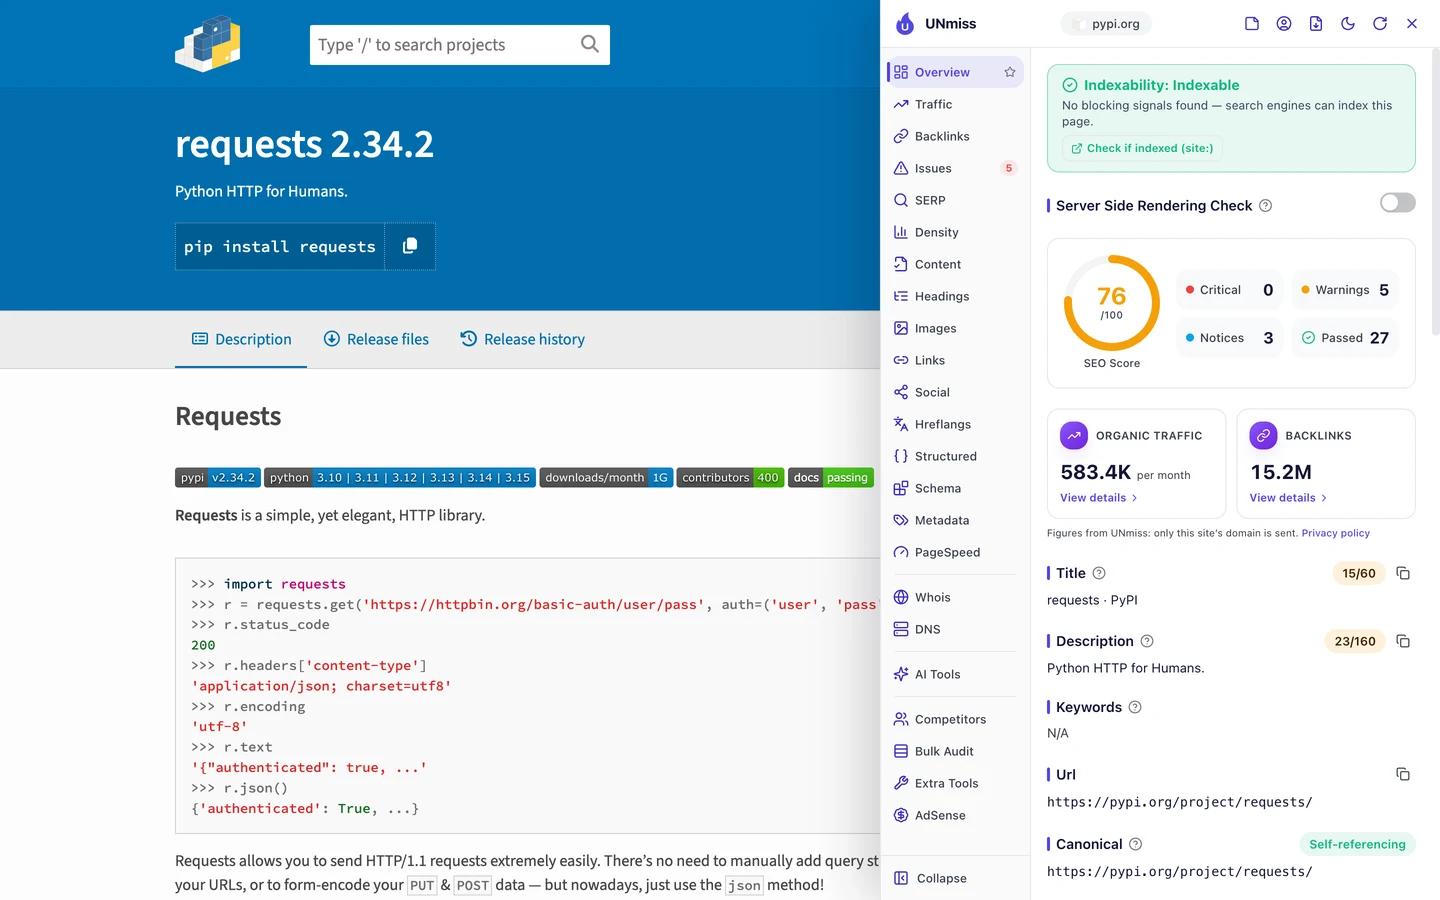
Она набирает 76 баллов. Ее описание «Python HTTP for Humans.» звучит как забавный девиз, но в нем всего 23 символа, хотя Google может показать около 160.
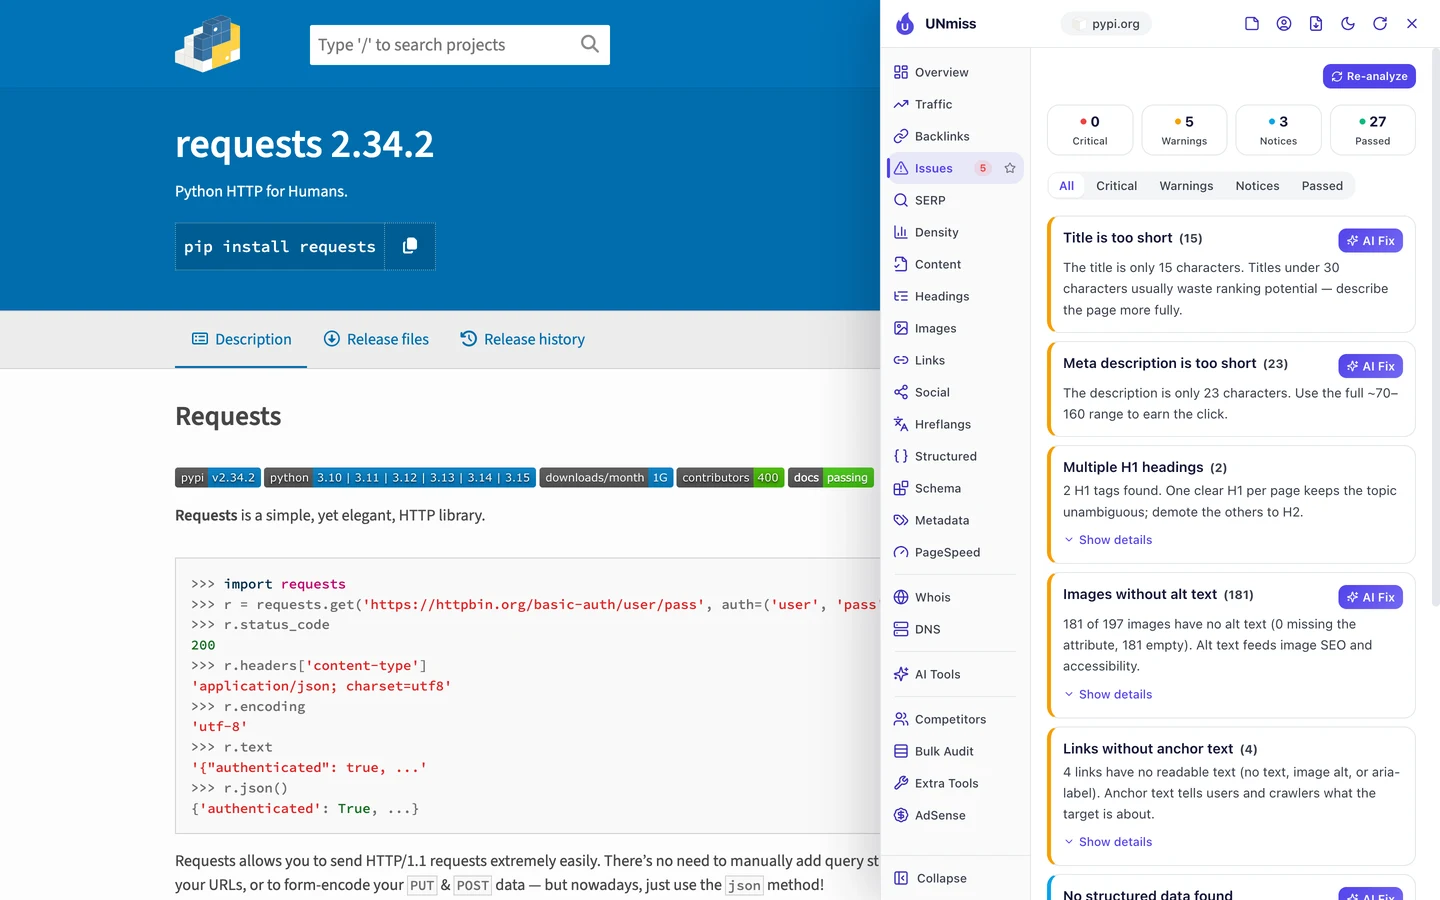
А еще на ней 2 тега H1. Тегом H1 размечают главный заголовок страницы, и такой заголовок должен быть один.
Здесь название пакета стоит в одном H1, а вторым, похоже, стал заголовок «Requests» в начале описания. Эту часть пишут создатели пакета, так что шаблон не может полностью ее контролировать.
В этом и подвох, когда описание каждый автор пишет сам. Одни пишут полное предложение, а другие ограничиваются девизом.
Так что не пускайте заголовки и описания на самотек. Добавьте в заголовок, что делает страница, задайте минимальную длину описания и посмотрите, как они будут выглядеть, в нашем генераторе метатегов.
Опишите каждый пакет кодом
Структурированными данными называют код, который подсказывает Google, что за страница перед ним: товар, руководство или программа. Вкладка Structured (структурированные данные) в расширении ищет такой код.
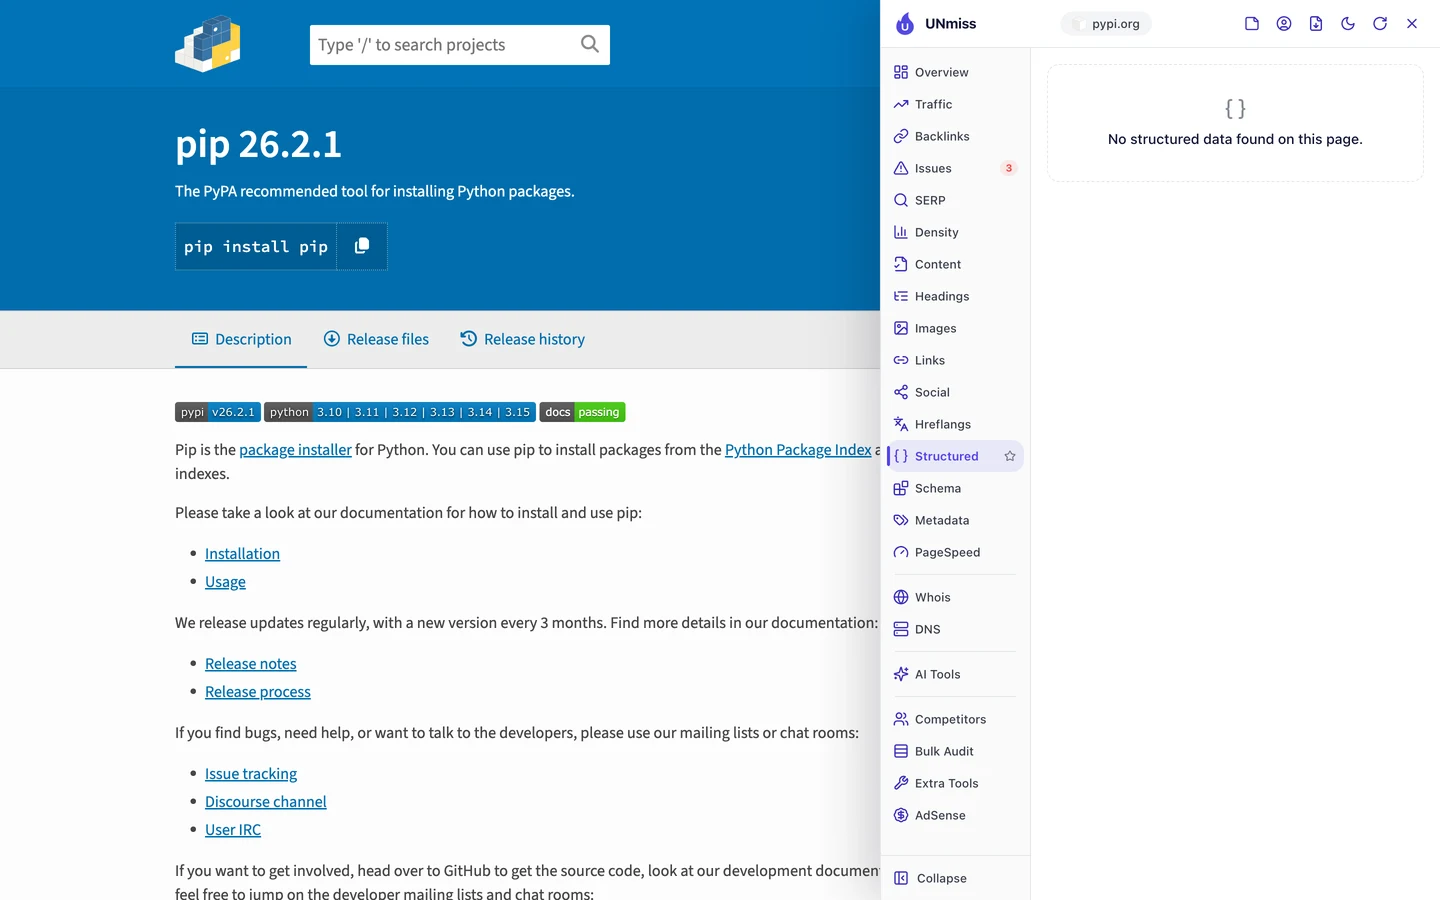
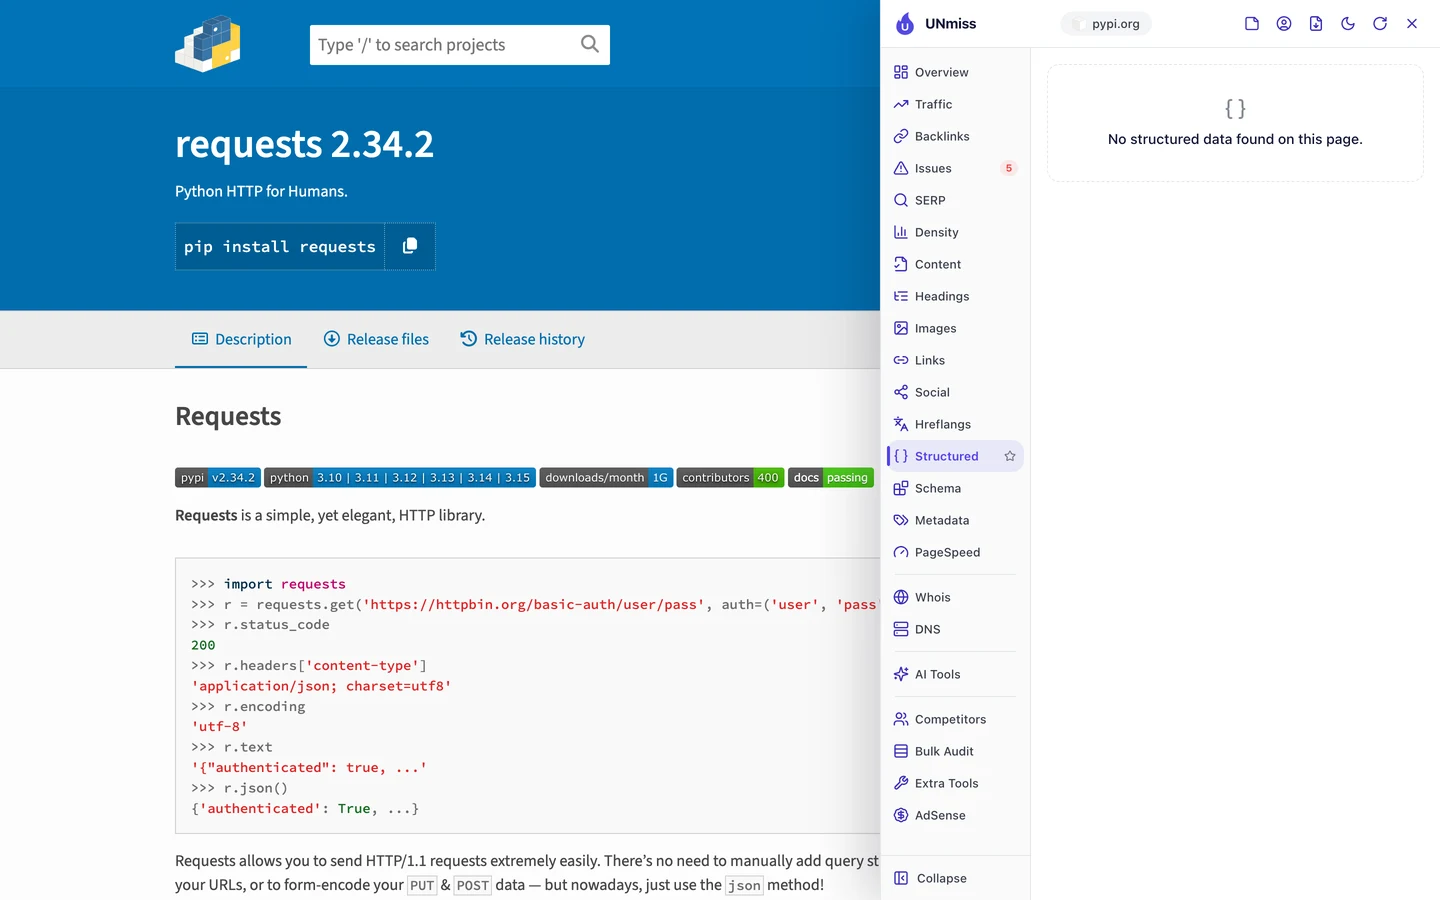
Ни на той, ни на другой странице их нет. А ведь на каждой указаны версия, дата выхода и люди, которые поддерживают пакет.
Все это можно было бы записать кодом, который Google читает напрямую. Чего не хватает, показывает вкладка Content (контент).
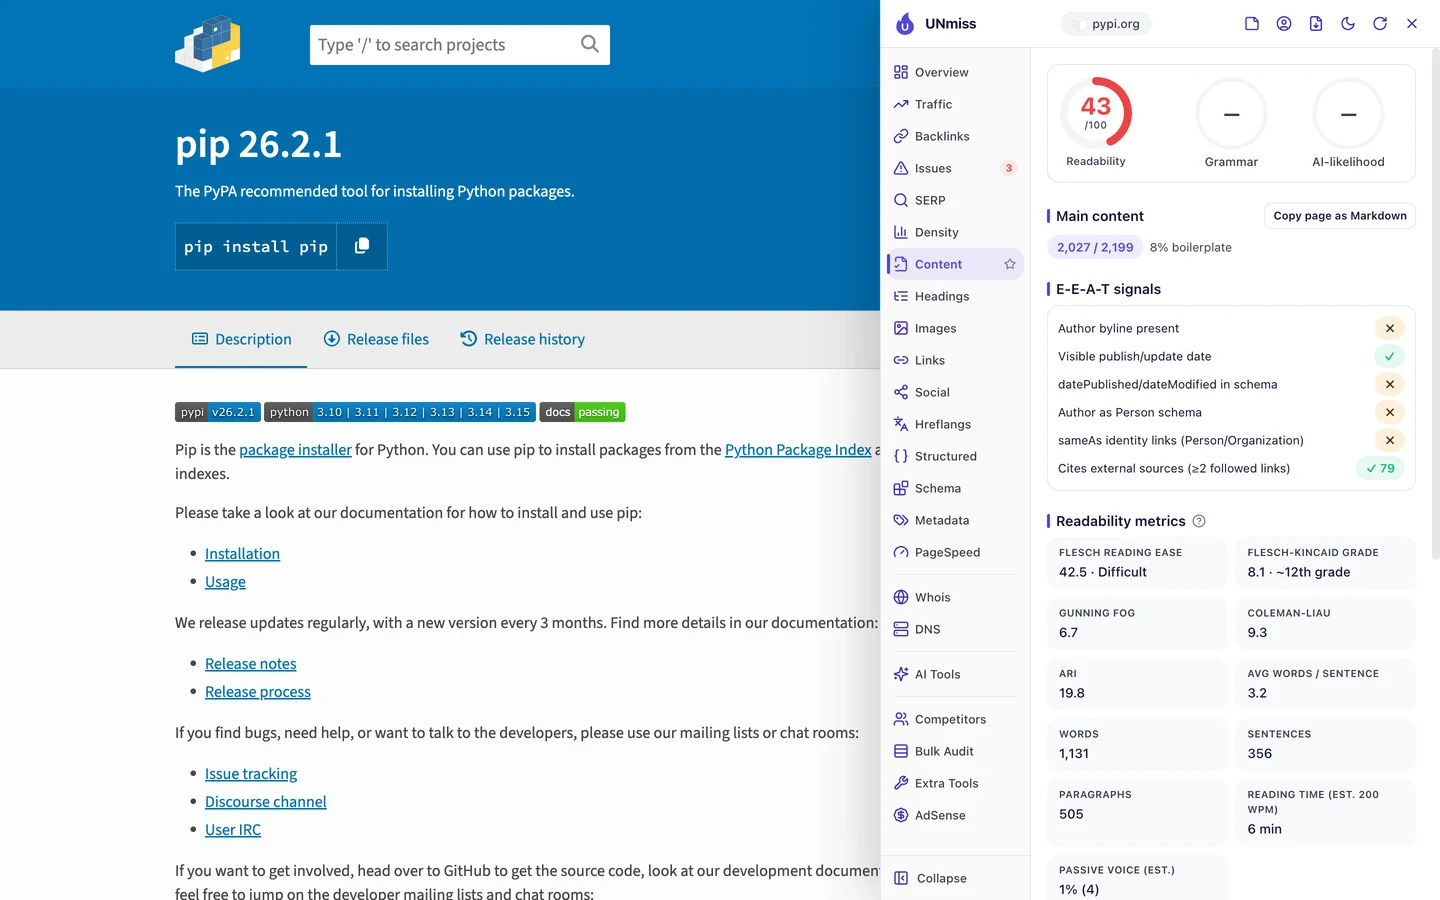
На странице pip видна дата выхода, и на ней много ссылок на внешние источники. Но в коде нет ни даты, ни автора.
Без такого кода Google приходится угадывать эти факты по самой странице. Часто у него получается, но вы полагаетесь на удачу.
Тот же код помогает и ИИ-инструментам. Многие программисты теперь спрашивают у ChatGPT или Claude, какой пакет выбрать, поэтому мы проверили, каким ИИ-краулерам разрешено читать PyPI.
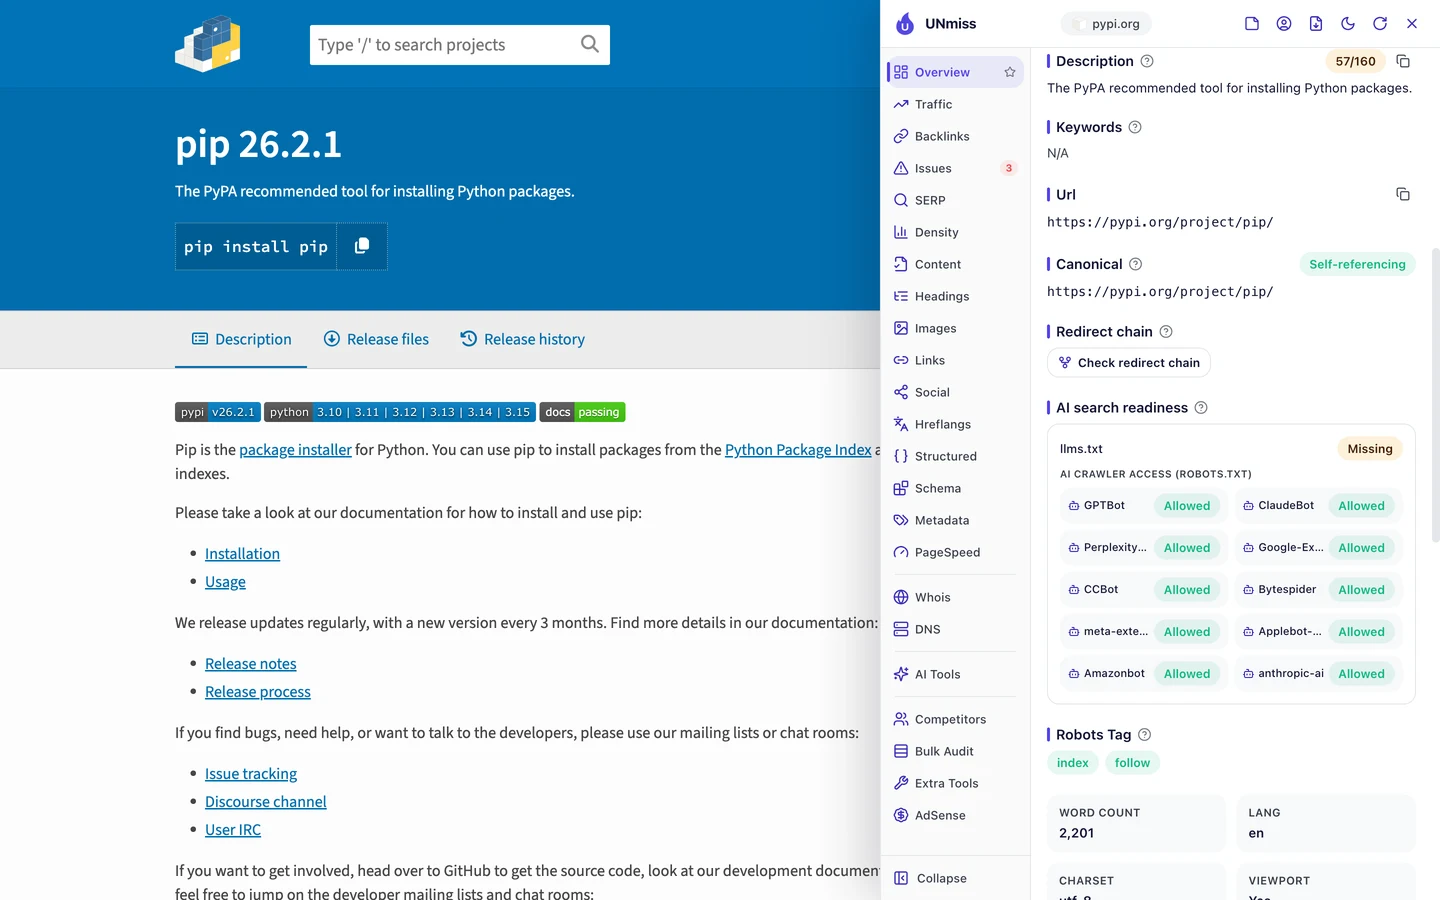
Краулером называют программу, которая обходит страницы так же, как Google. Правила для краулеров лежат в файле robots.txt: там написано, что им можно читать.
PyPI пускает всех 10 ИИ-краулеров, которых проверяет расширение. Но у него нет llms.txt, короткого файла, который рассказывает о сайте ИИ-инструментам.
MDN, сайт с документацией для программистов, который мы тоже разбирали, стоит изучить, если вам важны ответы ИИ.
Составьте собственные правила для краулеров в нашем генераторе robots.txt. А потом проверьте в нашем инструменте «Проверка видимости в ИИ», упоминают ли вас ИИ-инструменты.
Так что добавьте код, который сообщает, что это за страница, какой версии она посвящена и когда ее меняли. Наш Генератор разметки Schema напишет его за вас.
Сделайте аудит того, что видят боты
Расширение проверяет страницы по одной. А наш «Аудит сайта» отправляет своего краулера сразу по сотням страниц, так что видно, какие проблемы повторяются.
Он проверил 250 страниц на PyPI. Сайт набрал 79 баллов из 100, по меркам отчета это «удовлетворительно».
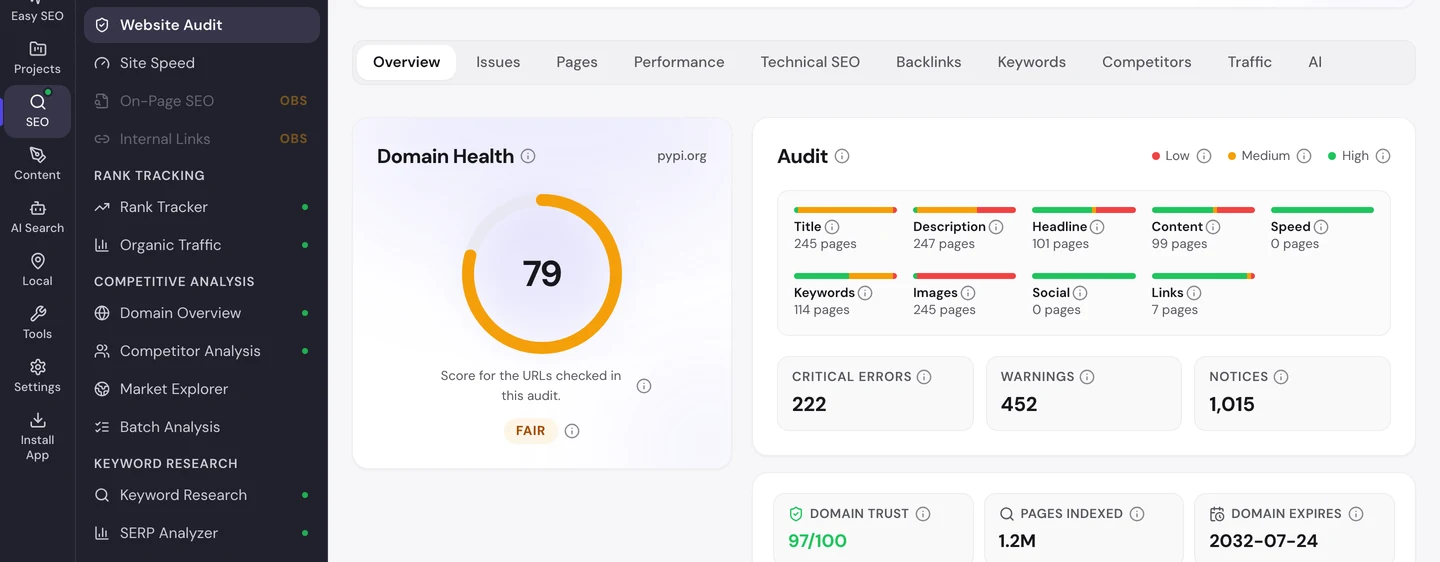
Еще он показывает около 1,2 млн проиндексированных страниц, то есть попавших в список Google. Вкладка Issues (проблемы) сортирует найденные ошибки по важности.
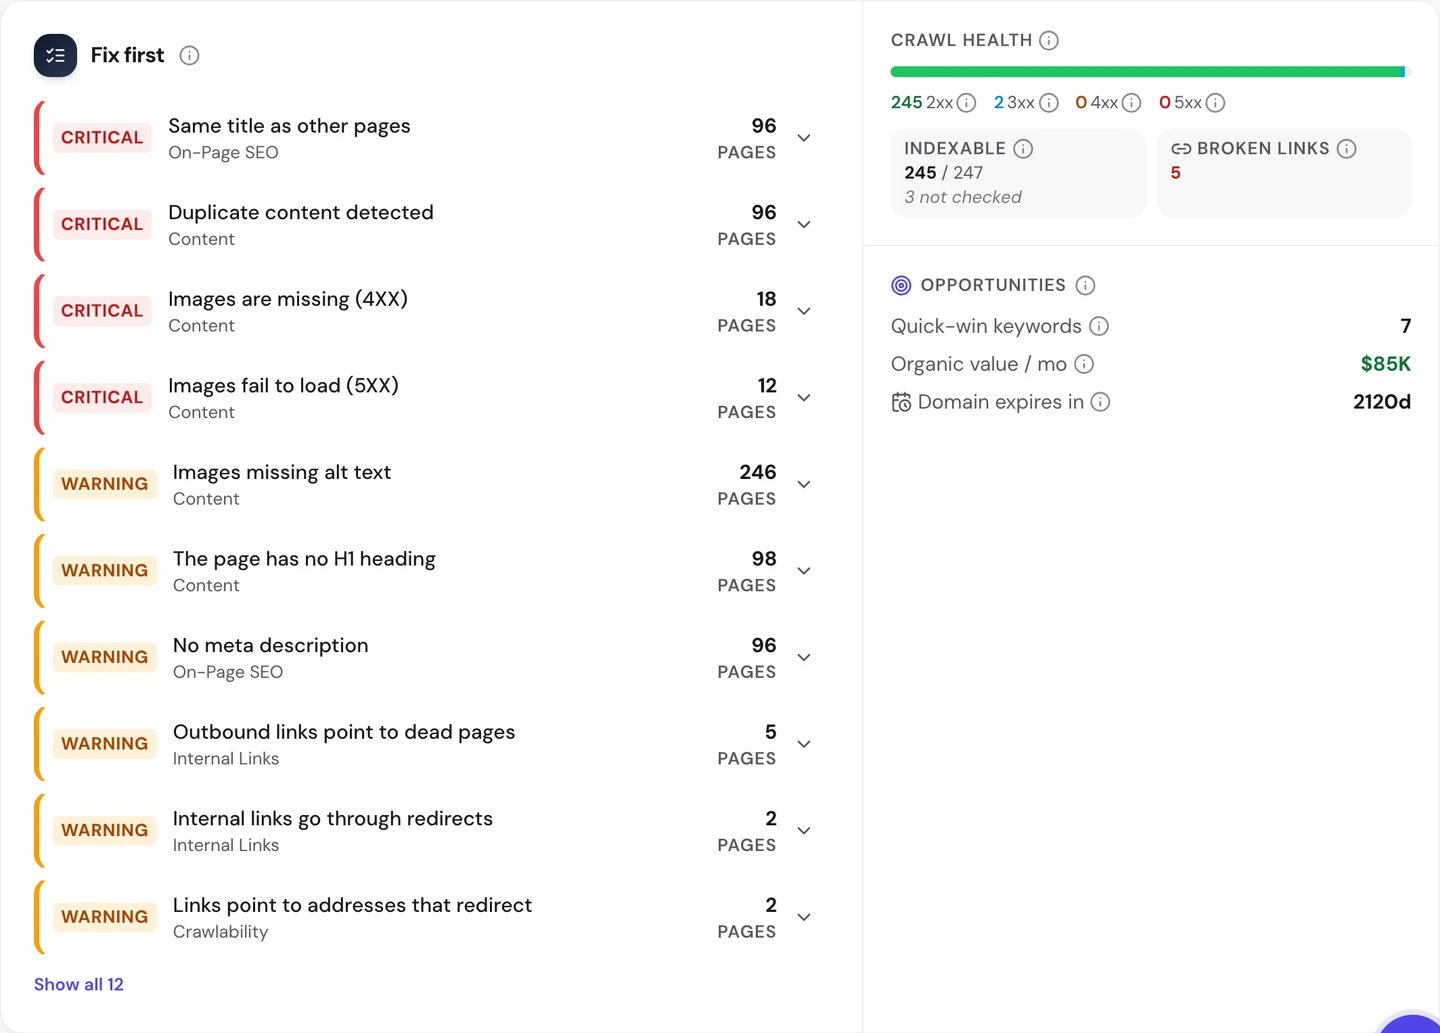
Первые 2 ошибки в списке: одинаковый заголовок и одинаковый контент на 96 страницах. Ниже идут 96 страниц без описания и 98 без H1.
Звучит плохо, но только пока вы не посмотрите, что на этих страницах написано. У всех 96 заголовок «Client Challenge».
Так выглядит проверка на бота: страница, которая убеждается, что к ней пришел человек, а не программа, которая копирует сайт. Нашему краулеру вместо страницы пакета показали эту проверку.
Так что большинство этих ошибок PyPI не допускал. Просто проверку на бота посчитали 96 раз.
Проверки на ботов защищают популярный сайт от скраперов, то есть программ, которые копируют страницы пачками. Риск в том, что заодно они могут остановить и Google.
Страницы PyPI стоят на первом месте по своим названиям, так что Google эту проверку явно проходит. Open Library, которую мы тоже разбирали, точно так же показывает незнакомым посетителям проверку на бота.
Вкладка Technical SEO (техническое SEO) показывает, какие страницы Google может проиндексировать.
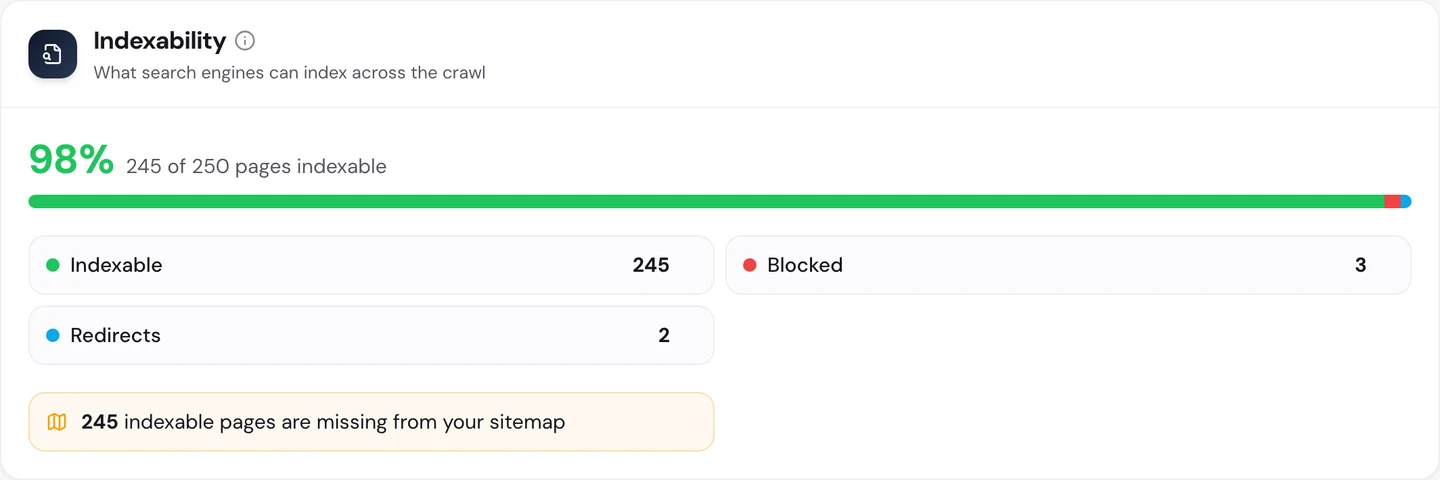
Почти все страницы можно проиндексировать, и это отлично. Но 245 из них нет в карте сайта, то есть в файле, где для Google перечислены все страницы.
В основном это страницы старых версий, которые вам, возможно, и не нужны в карте сайта. И все же стоит проверить, что главная страница каждого пакета там есть.
Ломать голову, что исправлять первым, вам не придется. Вкладка AI (ИИ) в аудите составляет план: короткую сводку, разбор каждой проблемы с советом, как ее исправить, и список задач на ближайшие 3 месяца.
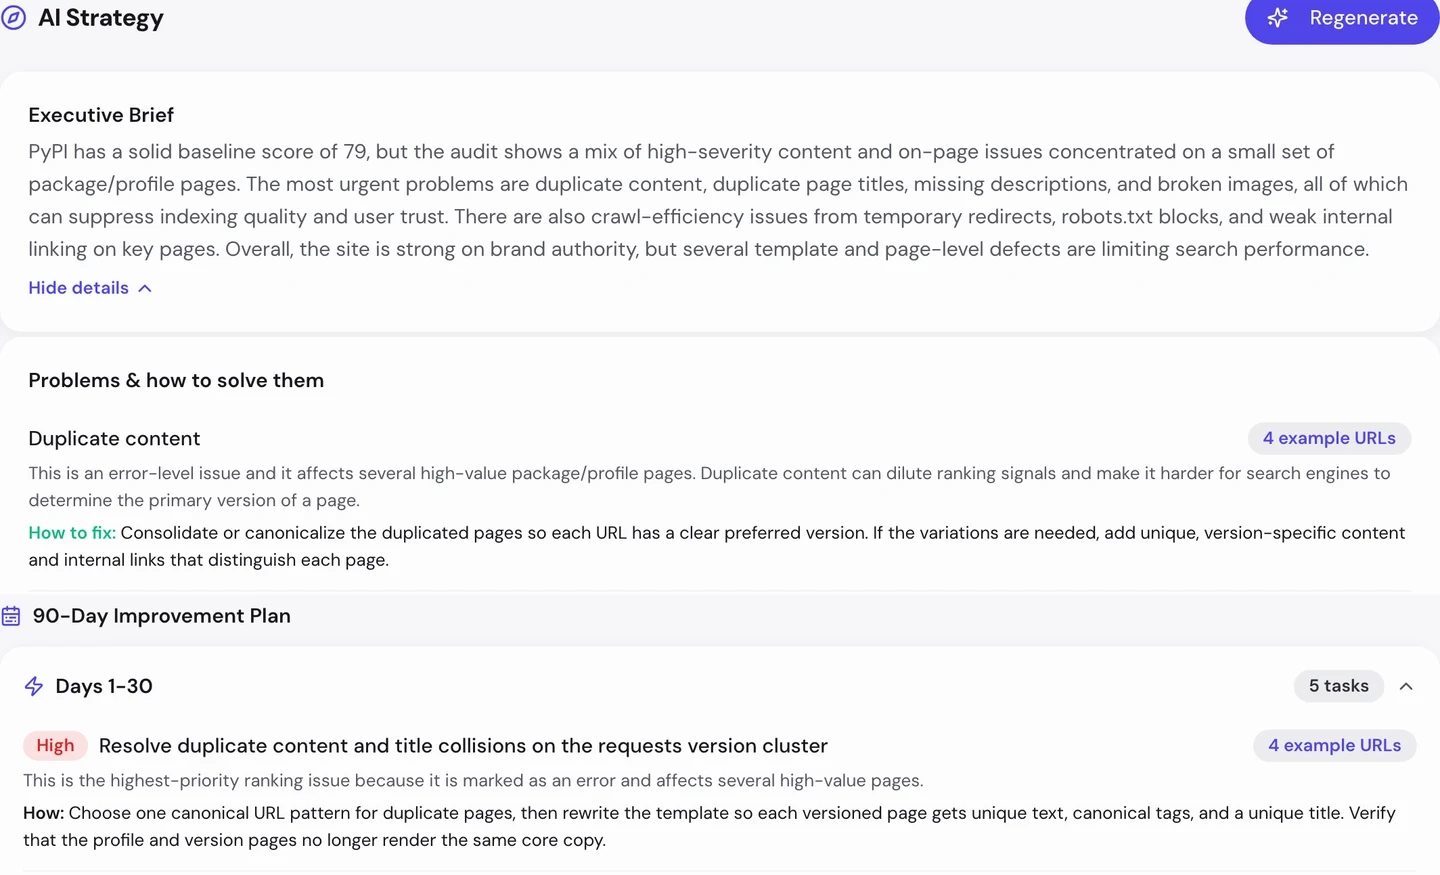
План опирается на те же цифры, поэтому тоже учитывает страницы с проверкой на бота. Но его первая задача вполне по делу: множество страниц со старыми версиями requests.
Так что запустите наш Аудит сайта, а потом откройте страницы, на которые приходятся самые серьезные ошибки. Если у них у всех общий заголовок вроде «Client Challenge», сначала посмотрите на них глазами Google, а уже потом что-то исправляйте.
Направьте старые версии на основную
Каждый раз, когда пакет обновляется, PyPI оставляет страницу старой версии. Как это выглядит, показывает карточка Duplicates (дубли) в аудите.
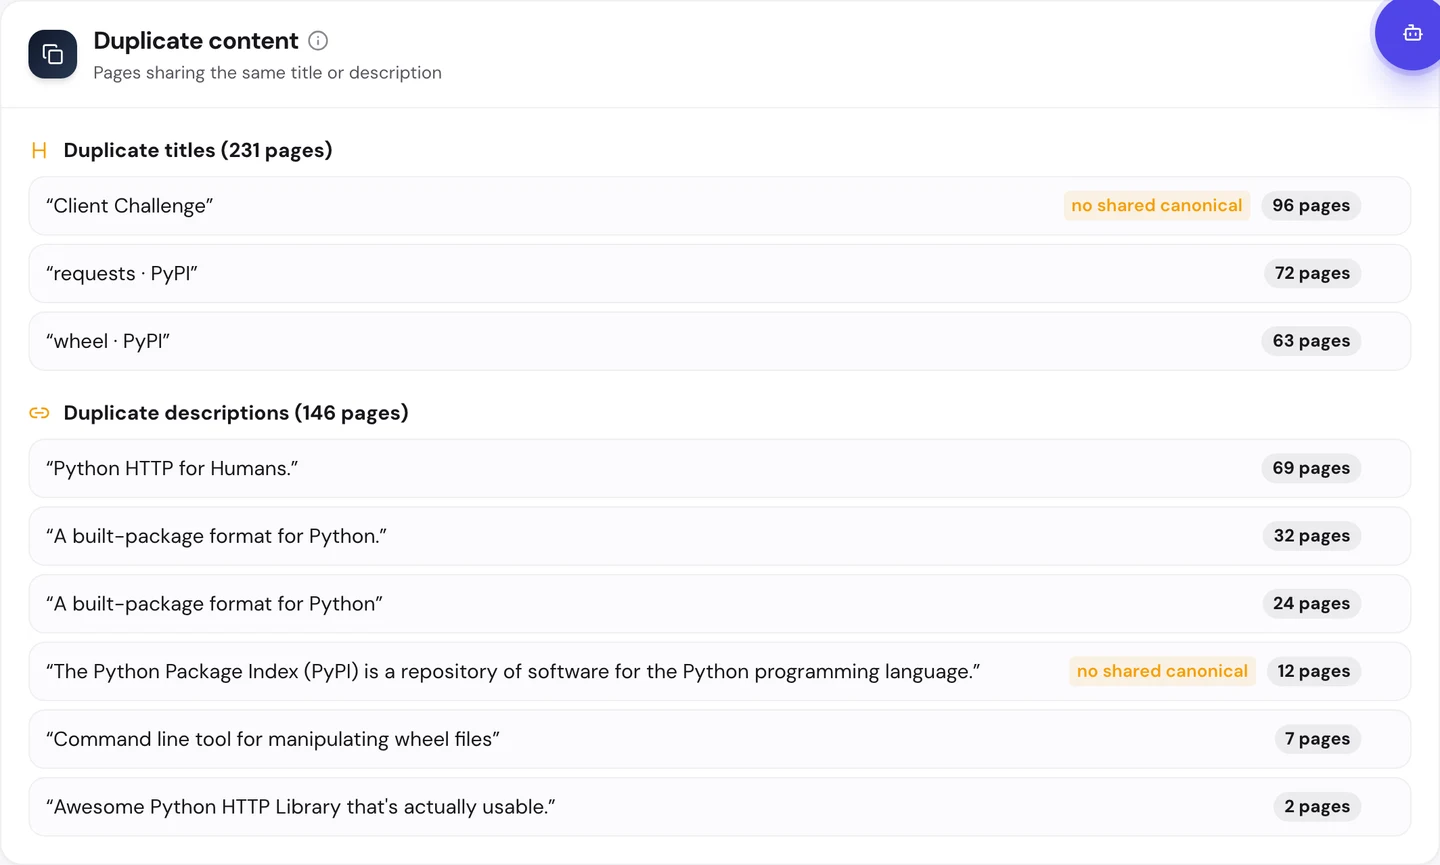
Заголовок «requests · PyPI» стоит на 72 страницах. А описание «Python HTTP for Humans.» на 69.
Перед нами страница requests и ее старые версии, и у каждой свой адрес. У пакета wheel, формата для распространения кода на Python, та же история на 63 страницах.
В глазах Google это множество похожих друг на друга страниц. Будь вы на его месте, какую из них вы бы поставили в выдачу?
PyPI решает этот вопрос с помощью тега canonical, который сообщает Google, какой адрес считать основным. Список страниц в нашем аудите показывает, что каждая старая страница requests и wheel, до которой мы добрались, указывает на основную страницу пакета.
Посмотрите на карточку еще раз. Пометка «No shared canonical» стоит рядом с проверкой на бота, но не рядом с requests или wheel.
Вот почему основная страница requests по-прежнему на первом месте, хотя у нее десятки двойников. Старые страницы остаются доступны всем, кому они нужны, а Google знает, что отправлять людей нужно на основную.
Другой вариант называется noindex: этот тег просит Google не включать страницу в выдачу. Используйте его, если не хотите, чтобы старая версия вообще появлялась в поиске.
Так что если вы храните старые версии, укажите в каждой основную страницу с помощью тега canonical. А потом запустите наш Аудит сайта и проверьте, что так сделано на каждой копии.
PyPI хранит страницу для каждой старой версии, и каждая из них подсказывает Google, какая страница основная. Мы находим похожие друг на друга страницы на вашем сайте, решаем, какая из них должна быть в выдаче, и настраиваем теги, чтобы Google не ошибся.
- Находим страницы с одинаковыми заголовками или описаниями
- Настраиваем canonical и noindex для старых страниц и почти точных копий
- Проверяем защиту от ботов, чтобы Google видел настоящую страницу
- SEO и GEO, чтобы вас цитировали и в ответах ИИ
Держите страницы простыми и быстрыми
У старых и основных страниц есть еще кое-что общее. Они легкие, поэтому быстро загружаются.
Вкладка Performance (производительность) в аудите показывает Core Web Vitals. Так называют 3 проверки Google: как быстро страница загружается, как быстро она реагирует на действия и не прыгает ли содержимое. Измеряют их на устройствах реальных посетителей.
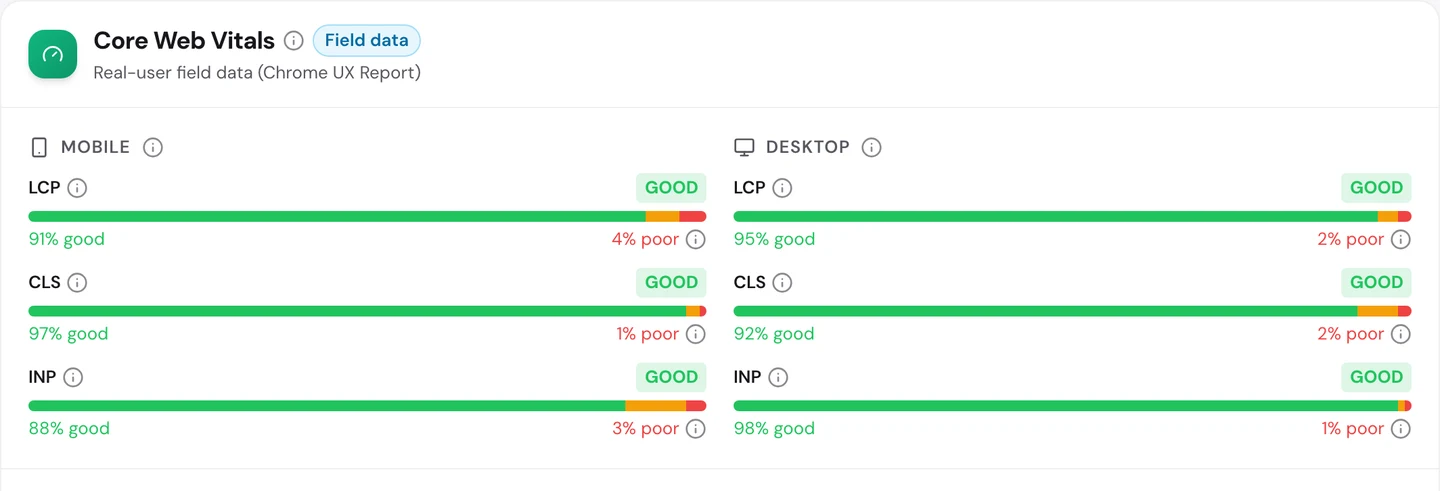
PyPI проходит все 6 проверок. На телефонах основной контент быстро загружается примерно в 9 из 10 посещений.
Страницы быстро реагируют на нажатия и не прыгают, пока загружаются.
А еще аудит выяснил, что текст лежит прямо в коде каждой страницы, так что не нужно ждать, пока его соберут скрипты. Простые страницы легко держать быстрыми.
Так что делайте самые посещаемые типы страниц простыми и проверяйте их на телефоне. Наш инструмент Site Speed покажет, что тормозит каждую страницу.
Следите, на какие страницы ссылаются
Быстрые страницы помогают, но ссылки по-прежнему очень много значат. Обратная ссылка ведет на ваш сайт с другого сайта, и Google считает каждую такую ссылку чем-то вроде голоса доверия.
Вкладка Backlinks (обратные ссылки) в нашем аудите показывает те же данные, что и наш Анализатор обратных ссылок.
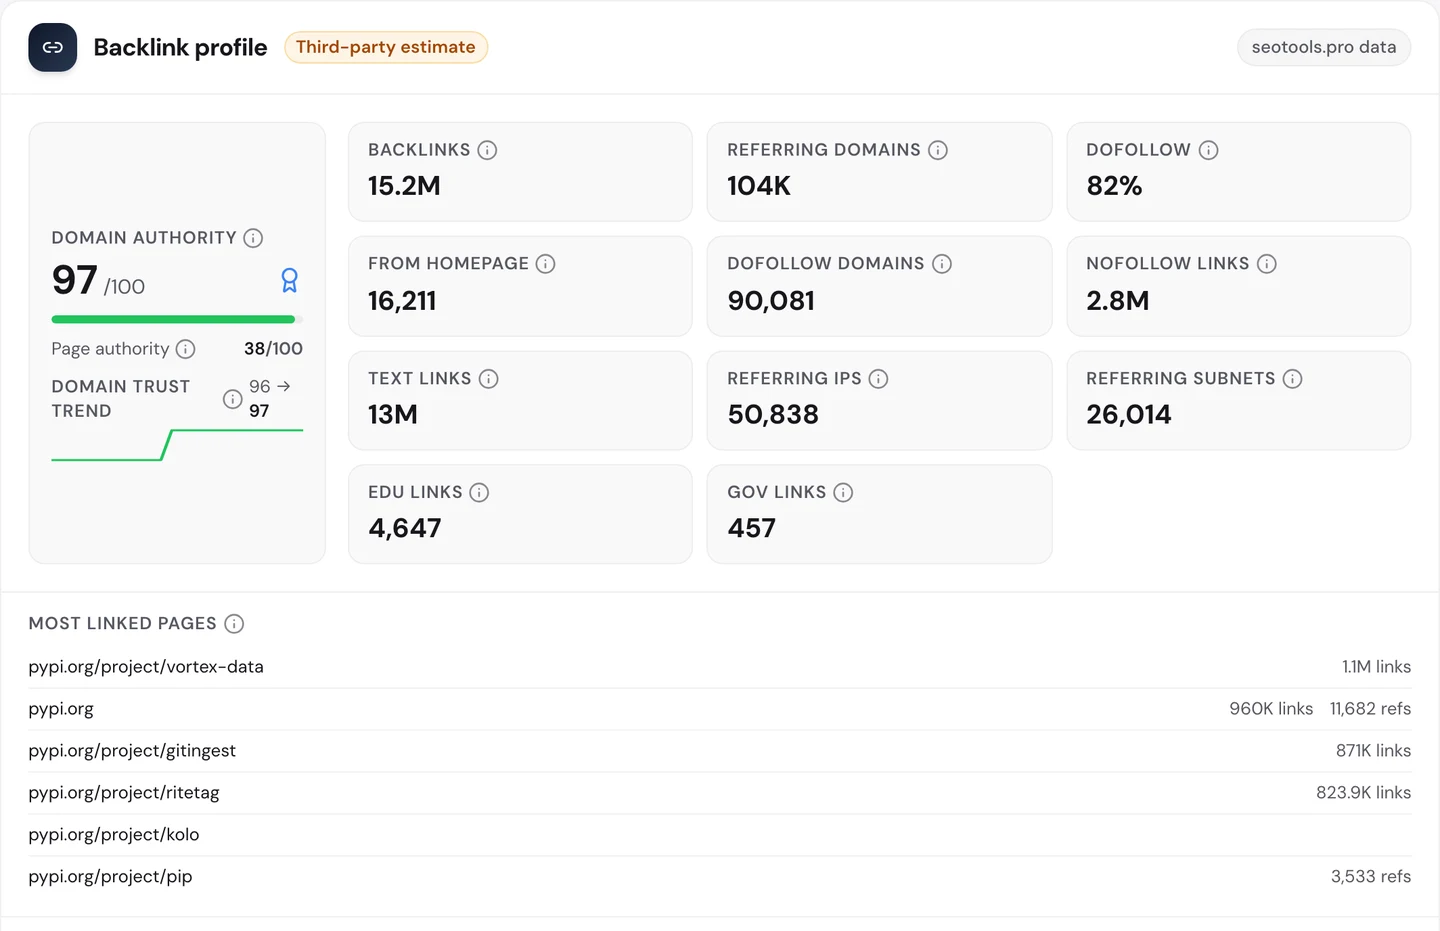
На PyPI ведут около 15 млн ссылок примерно со 104 тыс. ссылающихся доменов, то есть отдельных сайтов. Его Domain Authority, то есть наша оценка силы ссылок сайта по шкале от 0 до 100, равен 97.
Теперь посмотрите, на какие страницы ссылаются чаще всего. Наверное, вы ждете, что первыми окажутся pip или главная.
А на деле список возглавляет небольшой пакет vortex-data, у него около 1,1 млн ссылок. Следом идут еще несколько небольших пакетов, и у каждого ссылок намного больше, чем у pip.
А pip, самая посещаемая страница, оказалась в самом низу этого списка. Ее сила не в количестве ссылок, а в том, что на нее ссылаются около 3500 разных сайтов.
Такие огромные числа ссылок часто получаются, когда один сайт ставит ссылку на каждой своей странице. На них стоит взглянуть, но они не всегда значат так много, как кажется.
Так что каждый месяц проверяйте в нашем «Анализаторе обратных ссылок», на какие ваши страницы ссылаются чаще всего. Считайте сайты, которые ссылаются на страницу, а не сами ссылки, и следите, чтобы лучшим страницам доставалась их доля.
Найдите запросы, где вы почти в топе
При таком количестве ссылок PyPI, казалось бы, должен стоять в Google высоко. Наш Обзор домена показывает, где он стоит на самом деле.
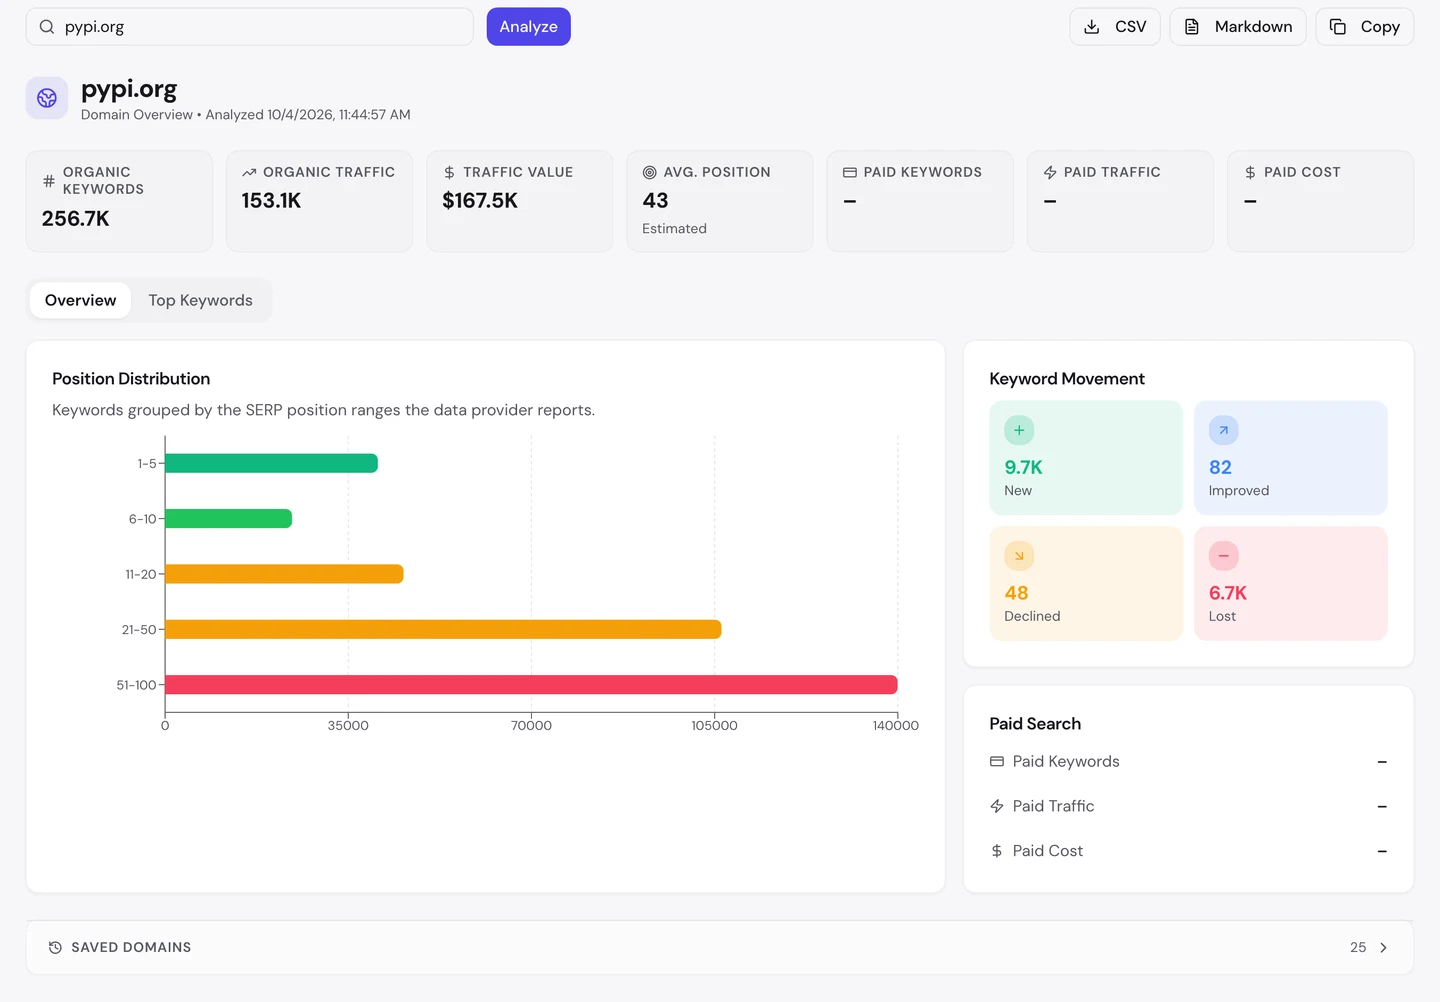
PyPI попадает в выдачу примерно по 257 тыс. запросов. Стоимость его трафика, то есть сколько пришлось бы заплатить за эти посещения в рекламе Google, составляет около 168 тыс. $ в месяц.
Но в среднем он стоит на 43-м месте, а это 5-я страница Google. Самый длинный столбец на графике приходится на места с 51 по 100, где почти никто не кликает.
Хорошие новости ждут на вкладке Keywords, которую вы уже видели. Около 46 тыс. запросов стоят на 2-й странице и совсем чуть-чуть не дотягивают до топ-10.
Если вы в таком же положении, начните с них: здесь победы даются быстрее всего. А вкладка Competitors (конкуренты) покажет, кто выигрывает запросы, которые не достаются вам.
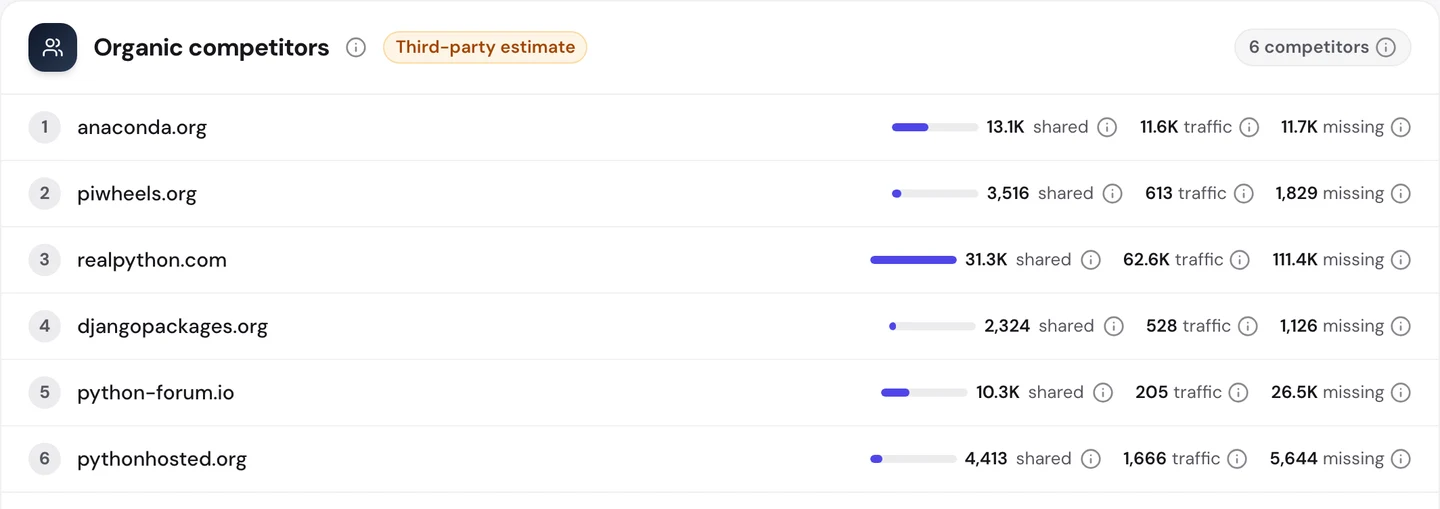
Первым идет Anaconda, еще одно место, где берут пакеты Python. А больше всего общих запросов, около 31 тыс., у Real Python, сайта с уроками по Python.
Теперь посмотрите на столбец «missing» (недостающие). Там собраны запросы, по которым конкурент попадает в выдачу, а PyPI нет, и у одного только Real Python их около 111 тыс.
В основном там запросы вида «как сделать», на которые список пакетов не ответит. Этот столбец подсказывает, какая страница вам нужна, чтобы их выиграть.
Если вы учите людей, дальше стоит почитать про freeCodeCamp, бесплатную школу программирования, которую мы тоже разбирали.
Так что найдите свои запросы на 2-й странице, в первую очередь улучшите эти страницы и следите, как они поднимаются, в нашем Rank Tracker. А узнать, с кем у вас общие запросы, поможет наш Анализ конкурентов.
Одна страница, pip, приносит 29% поискового трафика PyPI из США. Наш Organic Traffic Checker показывает ваши посещения за месяц, их динамику и страницы, которые их приносят, так что сразу видно, о каких страницах заботиться в первую очередь.
- Тот же отчет, которым мы измерили трафик PyPI
- Трафик, доля и главный запрос каждой популярной страницы
- Проверяйте и домены конкурентов
Что повторить не получится
Сначала о том, чего не скопировать: именно с PyPI pip скачивает пакеты. Об этом прямо в первой строке говорит сама страница pip.
На него ссылаются школы, государственные сайты и еще около 104 тыс. сайтов. За этим стоят годы доверия, которое не купишь.
Теперь несколько честных замечаний о цифрах, которые вам стоит знать.
Все цифры актуальны на 4 октября 2026 года. Цифра 153 тыс. учитывает только поиск Google в США.
Цифра 580 тыс. взята из вкладки Traffic в аудите, и она учитывает весь мир. Поэтому эти 2 числа так сильно расходятся.
Все эти цифры приблизительные. Никто, кроме самого PyPI, не знает точного числа посещений, поэтому инструменты рассчитывают его по позициям и частоте запросов.
Наш краулер проверил 250 страниц, а для такого огромного сайта это лишь небольшая выборка. Он глубоко зашел в старые версии requests и wheel, так что картина по всему сайту вышла немного перекошенной.
А 96 из этих страниц оказались проверкой на бота «Client Challenge». Ошибки на них мы не стали ставить PyPI в вину.
Еще аудит отметил изображения, которые не загружаются. Многие картинки на страницах пакетов оказываются маленькими значками с других сайтов, и проверить каждый мы не смогли, поэтому не стали их учитывать.
Одно число, которое стоит запомнить
4%.
Такая доля посещений PyPI из поиска в США приходится на людей, которые вводили его название. Все остальные вводили название пакета, например pip или requests.
Они попадали на простую страницу ровно с таким названием и командой для установки наверху. Никаких хитрых текстов и длинных руководств.
В этом и урок для любого сайта, где много продуктов. Давайте каждой странице название того, что нужно людям, а старые копии пусть указывают на основную.
Какие ваши страницы находят люди, которые даже не знают вашего названия? Проверьте их так, как это сделал бы Google.
Любую из этих проверок вы можете запустить на своем сайте и на сайтах конкурентов и сами увидеть такие же цифры.
Частые вопросы
Стоит ли хранить страницы старых версий продукта?
Храните их, если они еще кому-то нужны, например старые инструкции или прошлые релизы. В каждой укажите основную страницу с помощью тега canonical, чтобы Google знал, какую из них ставить в выдачу.
Хватит ли тега canonical, или нужен еще и noindex?
Обычно тега canonical хватает. Google считает его серьезной подсказкой, а не жестким правилом, поэтому время от времени проверяйте, что в выдаче по-прежнему основная страница. Не ставьте оба тега на одну страницу, ведь они противоречат друг другу.
Может ли проверка на бота навредить позициям в Google?
Только если она останавливает Google. Большинство таких проверок пропускают известных поисковых краулеров, но одна неверная настройка может их заблокировать. Проверяйте ключевые страницы после любых изменений в правилах для ботов.
Как увидеть свою страницу глазами Google?
Воспользуйтесь инструментом URL Inspection (проверка URL) в Google Search Console. Он показывает страницу ровно такой, какой ее получил Google, так что вы заметите проверку на бота или пропавший заголовок до того, как потеряете посетителей.
Что писать в заголовке страницы программы?
Начните с точного названия, которое ищут люди. Потом в паре слов добавьте, что программа делает, а в конце, если хватит места, название вашего сайта.
Какие структурированные данные подходят для страницы пакета или программы?
Разметка SoftwareApplication может описать название, версию и тип программы. Подойдет и разметка Breadcrumb (навигационная цепочка), а еще можно указать дату выхода, чтобы Google не пришлось ее угадывать.
Нужен ли мне файл llms.txt?
Он не обязателен, и пока его читают не все ИИ-инструменты. Зато написать его недолго, а ИИ-инструменты получат короткую карту самых важных страниц вашего сайта.
Как скоро новые заголовки и описания появятся в Google?
Обычно от нескольких дней до пары недель, в зависимости от того, как часто Google заходит на ваши страницы. Популярные страницы обновляются первыми. Google все равно может переписать описание, если решит, что под запрос лучше подходит другая строка.