ClinicalTrials.gov привлекает из американского Google около 166 000 посещений в месяц, хотя в исходном коде страниц с исследованиями нет ни строчки их текста.
На ClinicalTrials.gov правительство США публикует список медицинских исследований. У каждого исследования своя страница, а собирает ее код прямо у вас в браузере.
Мы прогнали сайт через свои SEO-инструменты. Наш «Аудит сайта» не смог прочитать ни одной страницы, и причина этого станет уроком для любого сайта, устроенного так же.
Ниже 9 уроков, которые можно перенять, и то, чего повторить не выйдет.
Дайте каждому исследованию страницу
Начали мы с нашего инструмента «Проверка органического трафика». Он оценивает органический трафик сайта, то есть людей, которые находят его в Google сами, без рекламы.
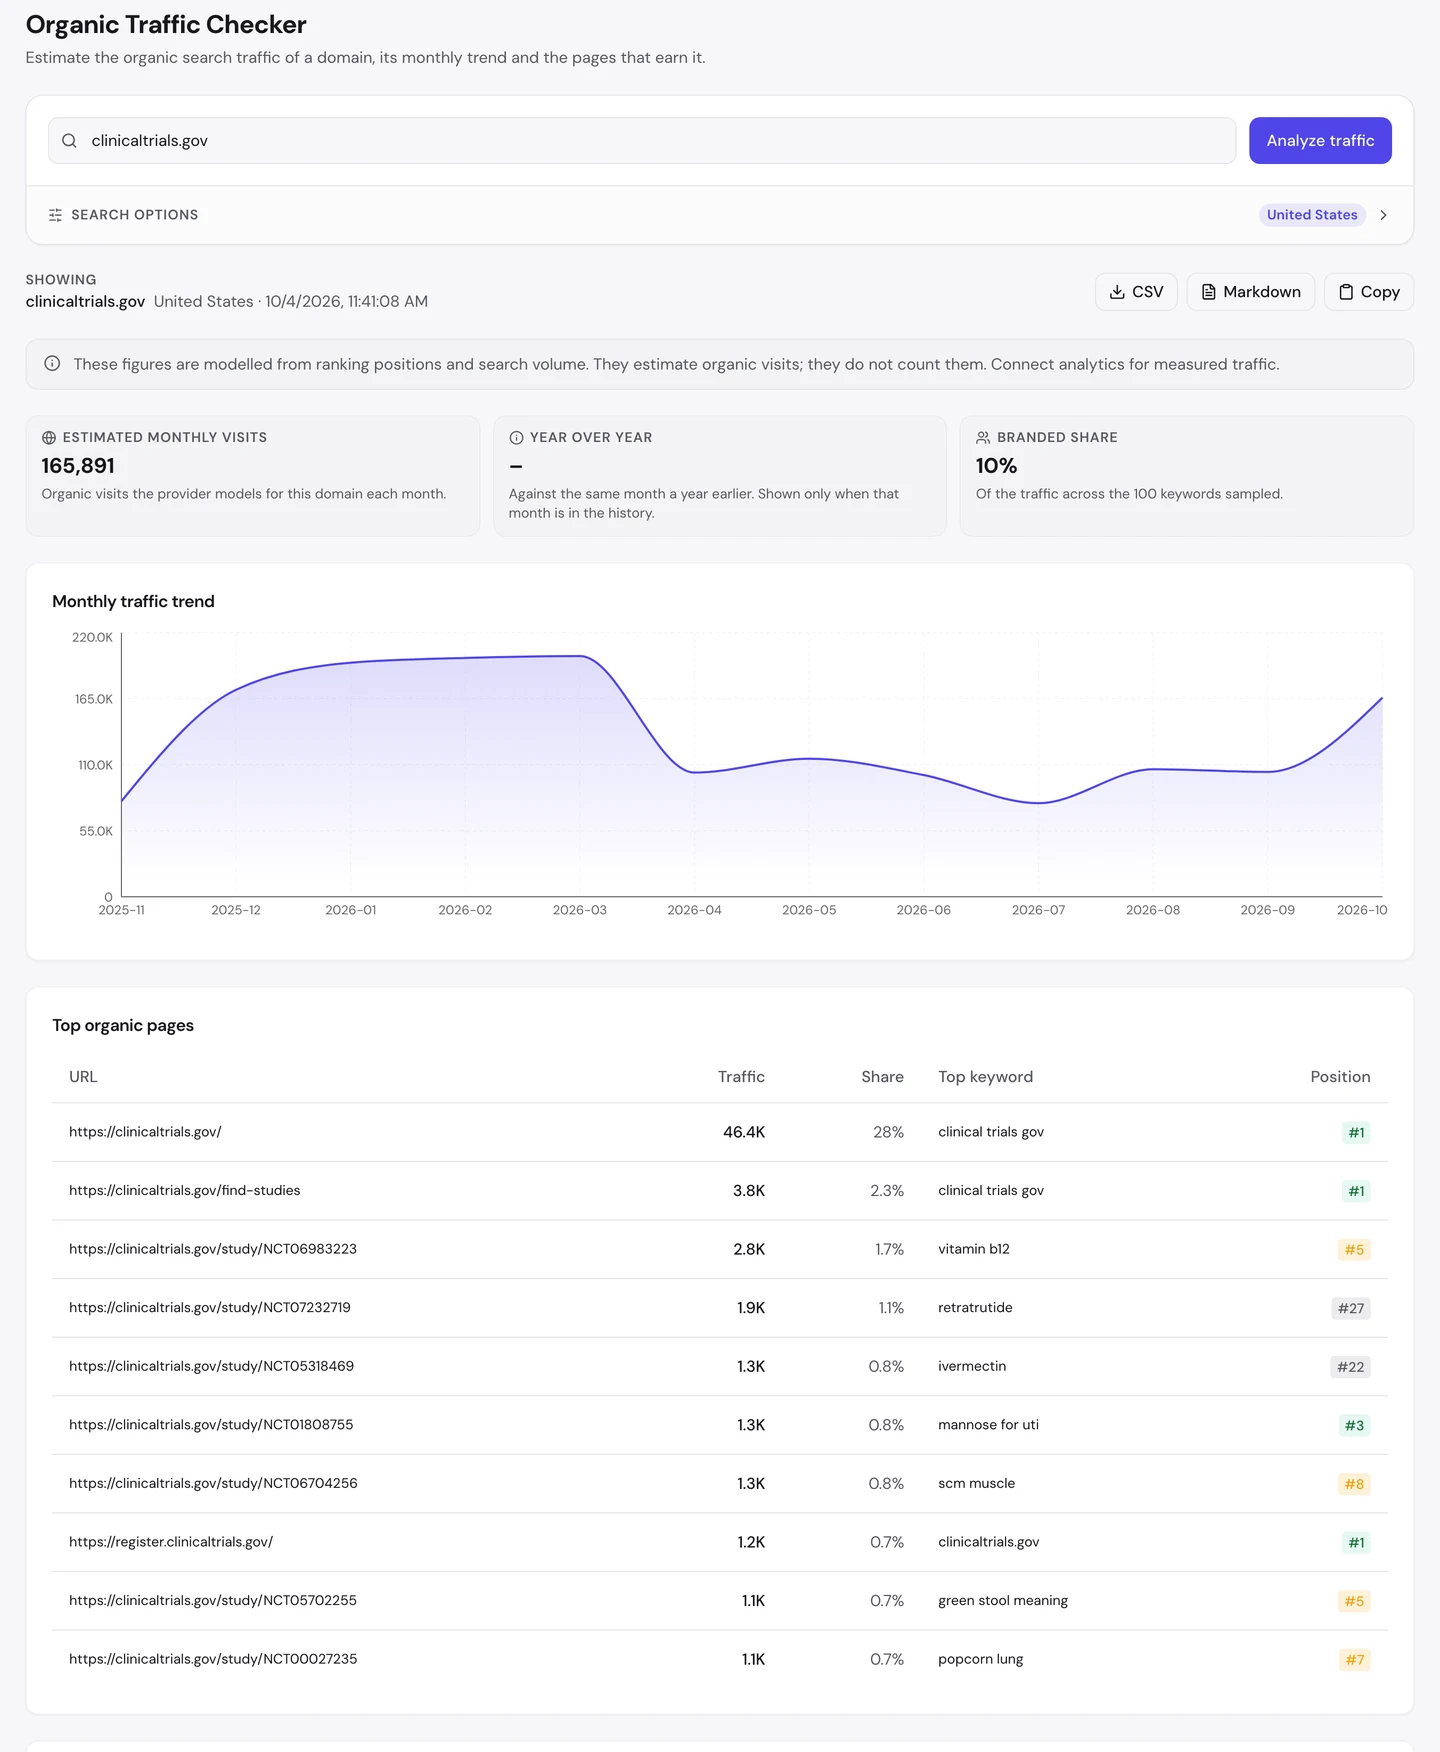
Это около 166 тыс. посещений в месяц из США. И лишь 10% из них приходят от людей, которые ищут сайт по названию.
Главная собирает больше четверти этих посещений. А теперь посмотрите на остальные страницы из топ-10.
Среди них 7 страниц отдельных исследований. И каждая приводит на сайт свой поток посетителей.
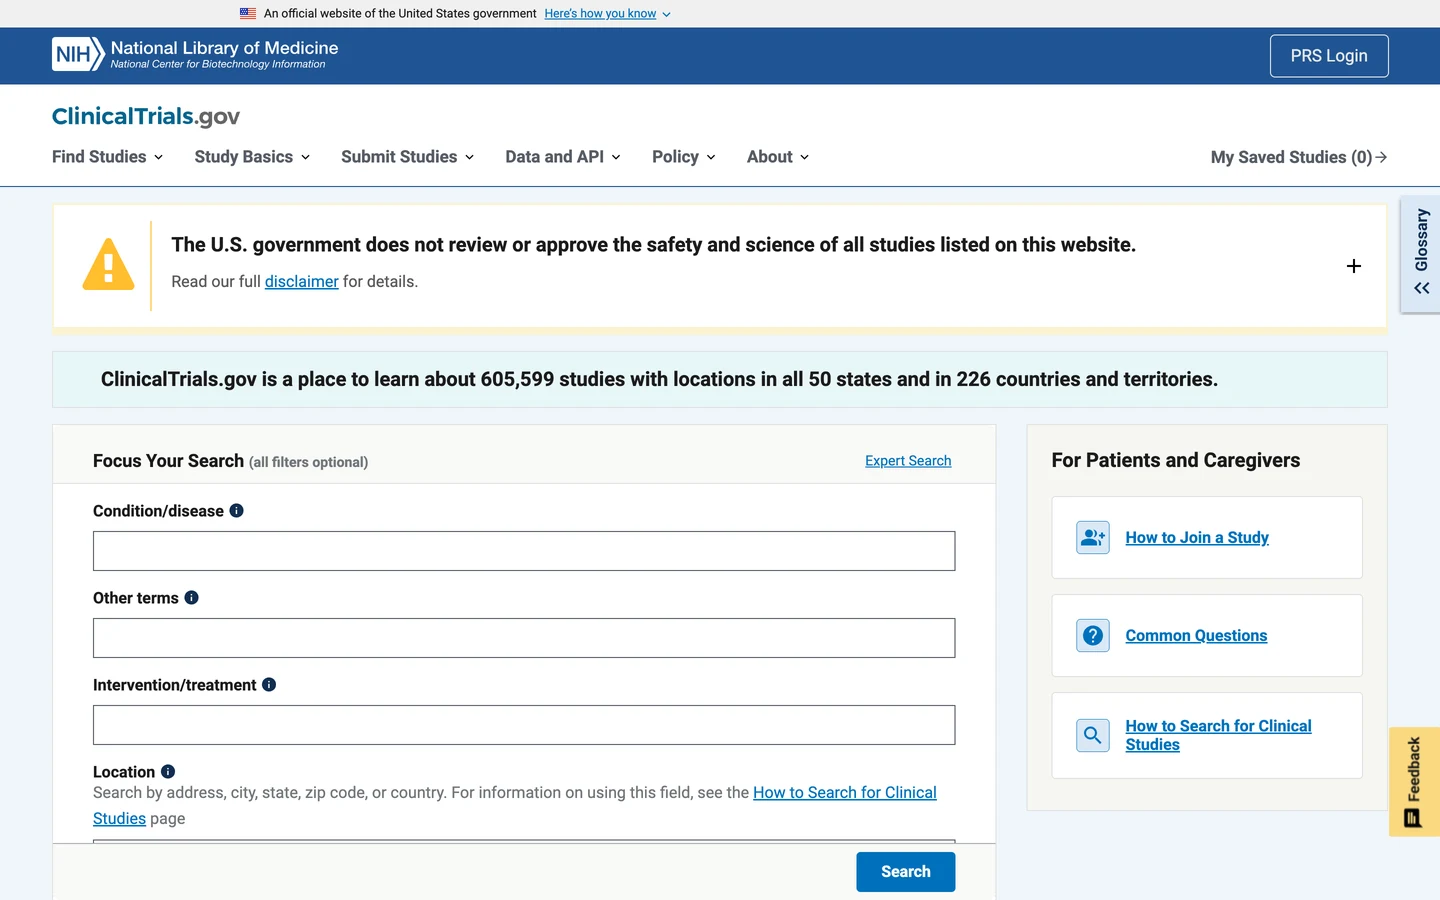
Главная сообщает, что на сайте около 606 тыс. исследований. У каждого из них свой адрес, а значит, каждое может появиться в Google.
На этом все и держится. Когда на одну тему приходится одна страница, Google точно знает, куда вас отправить.
Docker Hub, который мы тоже разбирали, дает свою страницу каждой программе. PHP.net, еще один наш разбор, делает то же самое для каждой функции.
Так что дайте каждому своему товару или услуге свою страницу и свой адрес. А потом посмотрите в нашем инструменте «Проверка органического трафика», какие страницы приносят посетителей.
Говорите словами пациентов
Теперь посмотрите, по каким запросам выигрывают эти страницы. Там нет ни кодов, ни длинных научных названий.
Одна страница исследования занимает 7-е место по запросу «popcorn lung», так называют одну болезнь легких. Другая стоит на 5-м месте по запросу «green stool meaning».
Третья занимает 3-е место по запросу «mannose for uti». Речь о маннозе, добавке, которую ищут при воспалении мочевого пузыря. Вы бы никогда не подумали, что на такой вопрос ответит научное исследование.
Это обычные житейские вопросы. И большинство людей, которые их вводят, скорее всего, вовсе не ищут клиническое исследование.
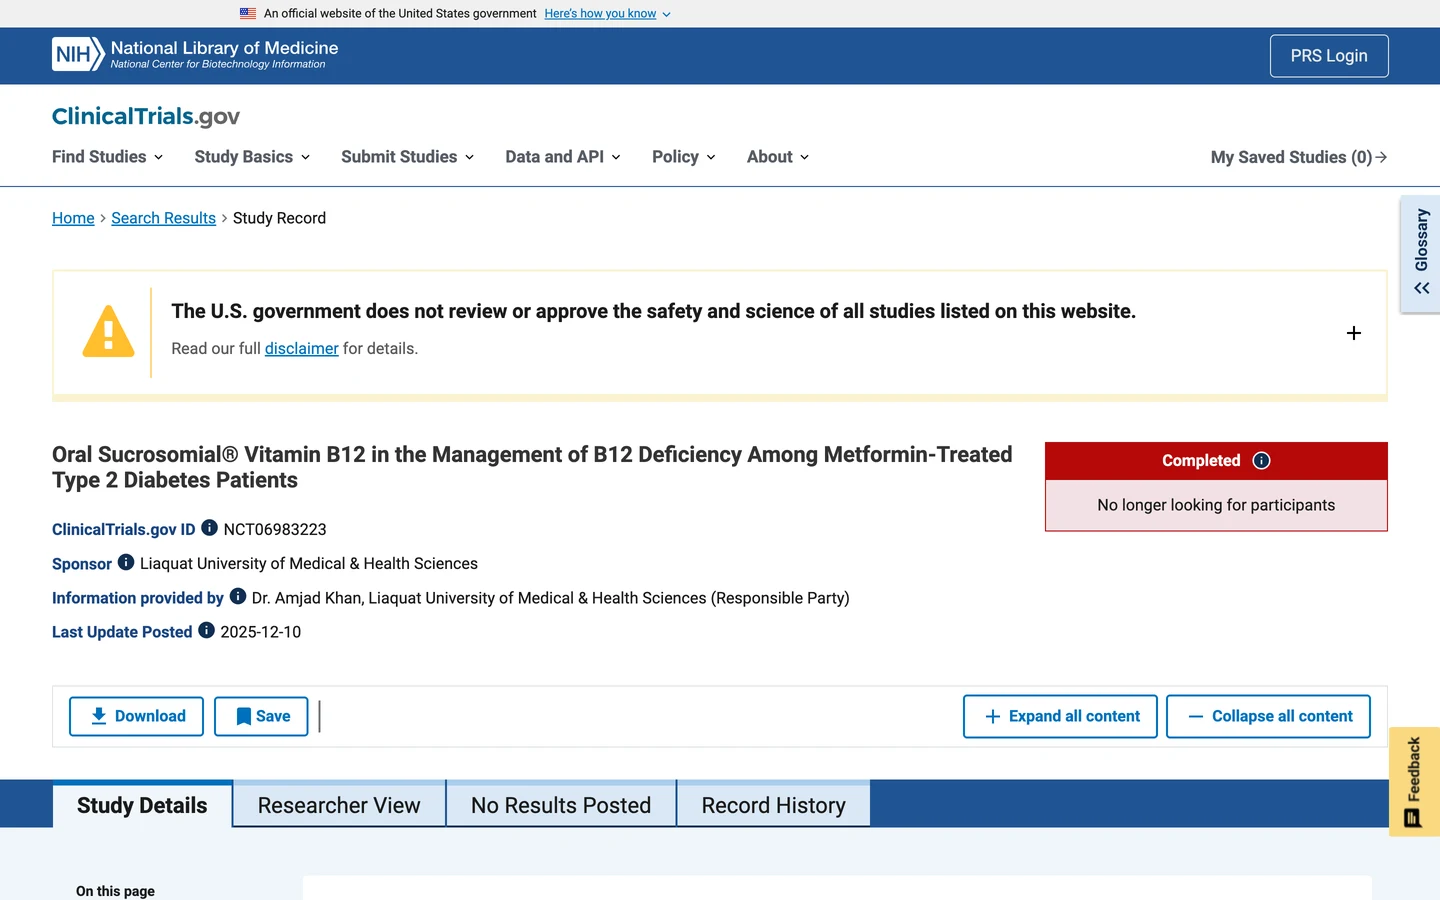
Эта страница рассказывает об исследовании добавки с витамином B12 для людей с диабетом. Она стоит на 5-м месте по простому запросу «vitamin b12».
Одна эта страница приводит около 2,8 тыс. посещений в месяц. Google увидел в ее заголовке и тексте те же слова, что вы вводите в поиск, и связал одно с другим.
Healthline, сайт о здоровье, который мы тоже разбирали, целиком построен вокруг таких запросов.
Это можно делать сознательно. Узнайте, какими простыми словами пользуются люди, и вынесите их в заголовок, подзаголовки и первые строки.
Так что выясните с помощью нашего инструмента «Исследование ключевых слов», как люди на самом деле ищут информацию по вашей теме. И пишите их словами, а не названиями, принятыми у вас в компании.
Проведите аудит глазами краулера
Дальше мы запустили наш Аудит сайта. Он отправляет на сайт краулера, то есть программу, которая обходит сайт так же, как Google, и проверяет сразу сотни страниц.
Мы попросили обойти 250 страниц. А еще дали ему карту сайта, то есть файл со списком страниц для Google.
Отчет пришел пустым. В нем было написано: «Нам не удалось прочитать ни одной страницы этого сайта».
Тогда мы стали разбираться, почему так. Мы запросили страницу исследования о витамине B12 самым простым способом, как это делает краулер.
Мы даже выдавали себя за Googlebot и GPTBot, краулеров Google и OpenAI. И каждый раз получали одну и ту же страницу.
Вот что пришло в ответ. Мы оставили только главные строки. Весь файл весит около 94 КБ, но важно именно это.
<title>ClinicalTrials.gov</title>
<meta name="description" content>
…
<app-root></app-root>
…
В заголовке только название сайта, а описание пустое. Нет ни названия исследования, ни его текста, ни главного заголовка.
Читатель увидел бы там только несколько кнопок словаря терминов и заметку для «study record managers», то есть для тех, кто ведет записи об исследованиях. И все.
Видите пустой тег «app-root»? Это коробка, куда потом закладывают исследование.
Эту коробку после загрузки страницы заполняет JavaScript, то есть код, который работает в вашем браузере. А пока этого не случилось, исходный HTML, первый код от сервера, остается пустой оболочкой.
Ваш браузер этот код выполняет, поэтому вы видите исследование целиком. Наше бесплатное расширение для браузера читает страницу точно так же.
Откройте страницу, нажмите на значок seotools.pro, и рядом появится панель. Вкладка Content (контент) считает слова на странице.
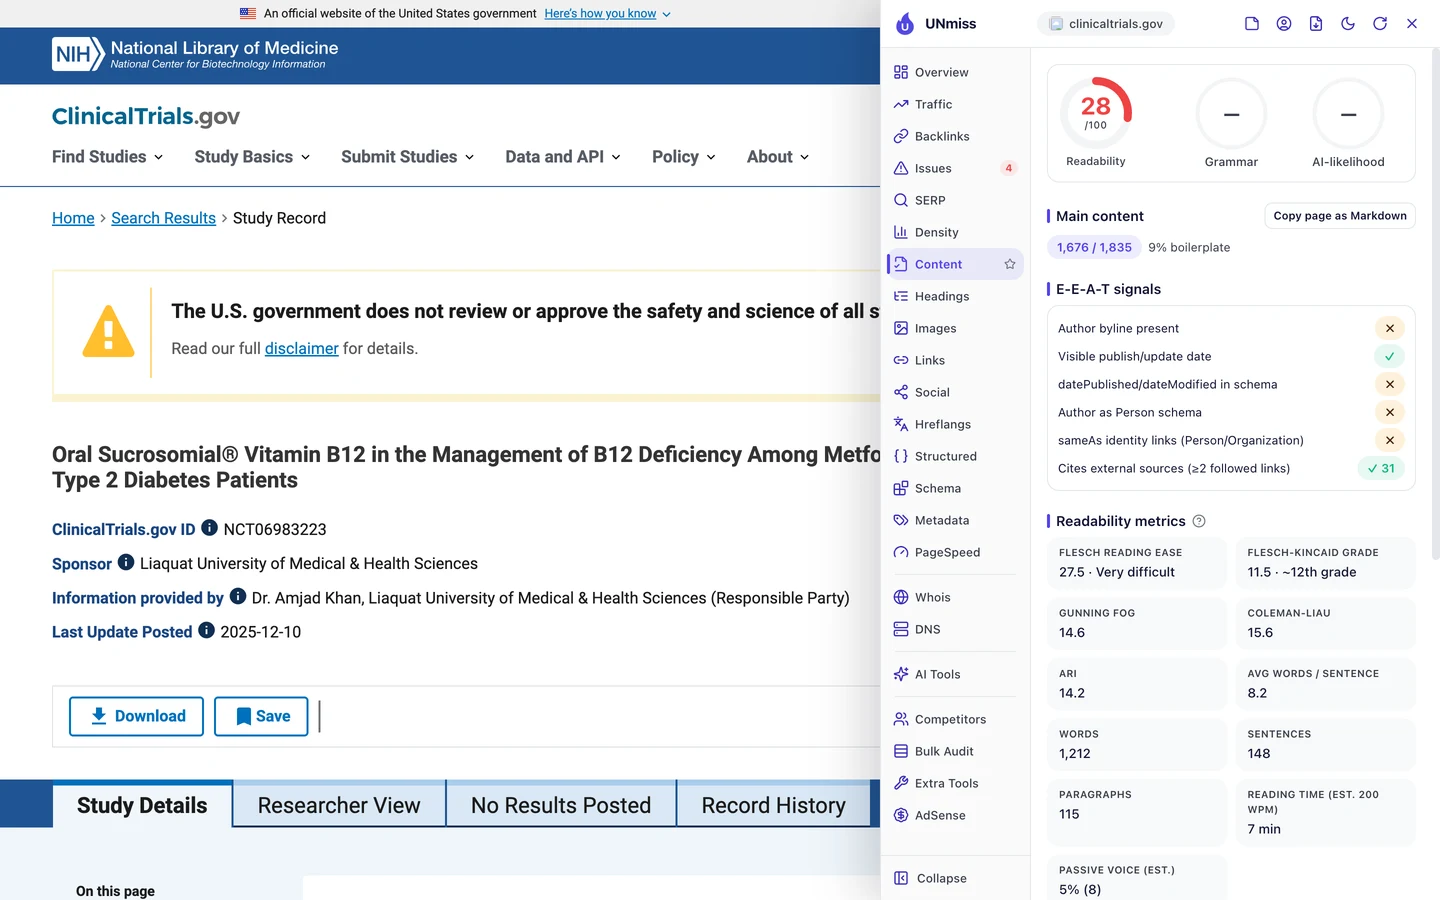
В браузере расширение находит около 1 700 слов основного контента. А в исходном HTML мы не нашли ни одного из этих слов.
Вот почему наш аудит вернулся ни с чем. Он, как и многие краулеры, читает исходный HTML, поэтому все страницы показались ему пустыми.
А теперь о том, что полезно вам. Если наш аудит не может прочитать ваши страницы, то и простой краулер не сможет.
Так что запустите наш Аудит сайта на своем сайте. Если отчет придет пустым или у ваших страниц не окажется ни заголовка, ни текста, проверьте, что на самом деле лежит в вашем исходном HTML.
Страницы исследований ClinicalTrials.gov доходят до краулеров без текста самих исследований. Мы проверим, что на самом деле лежит в вашем исходном HTML, и перенесем туда ваш текст, чтобы его могли прочитать Google и ИИ-инструменты.
- Проверяем ваши страницы так, как их получают краулеры
- Настраиваем пререндеринг или серверный рендеринг для ключевых страниц
- Исправляем заголовки, описания и подзаголовки в ваших шаблонах
- SEO и GEO, чтобы вас цитировали и в ответах ИИ
Поместите основной текст в HTML
Почему же тогда страницы исследований все равно в топе? Потому что Google выполняет JavaScript.
Он загружает страницу так же, как браузер, часто чуть позже, и уже потом читает исследование. Так отдельные исследования и попадают в топ-10.
Многие другие краулеры ждать не станут. Большинство ИИ-краулеров не выполняют JavaScript, поэтому читают исходный HTML и идут дальше.
Для них каждая страница исследования выглядит как та пустая оболочка выше. И ведь сайт их пускает.
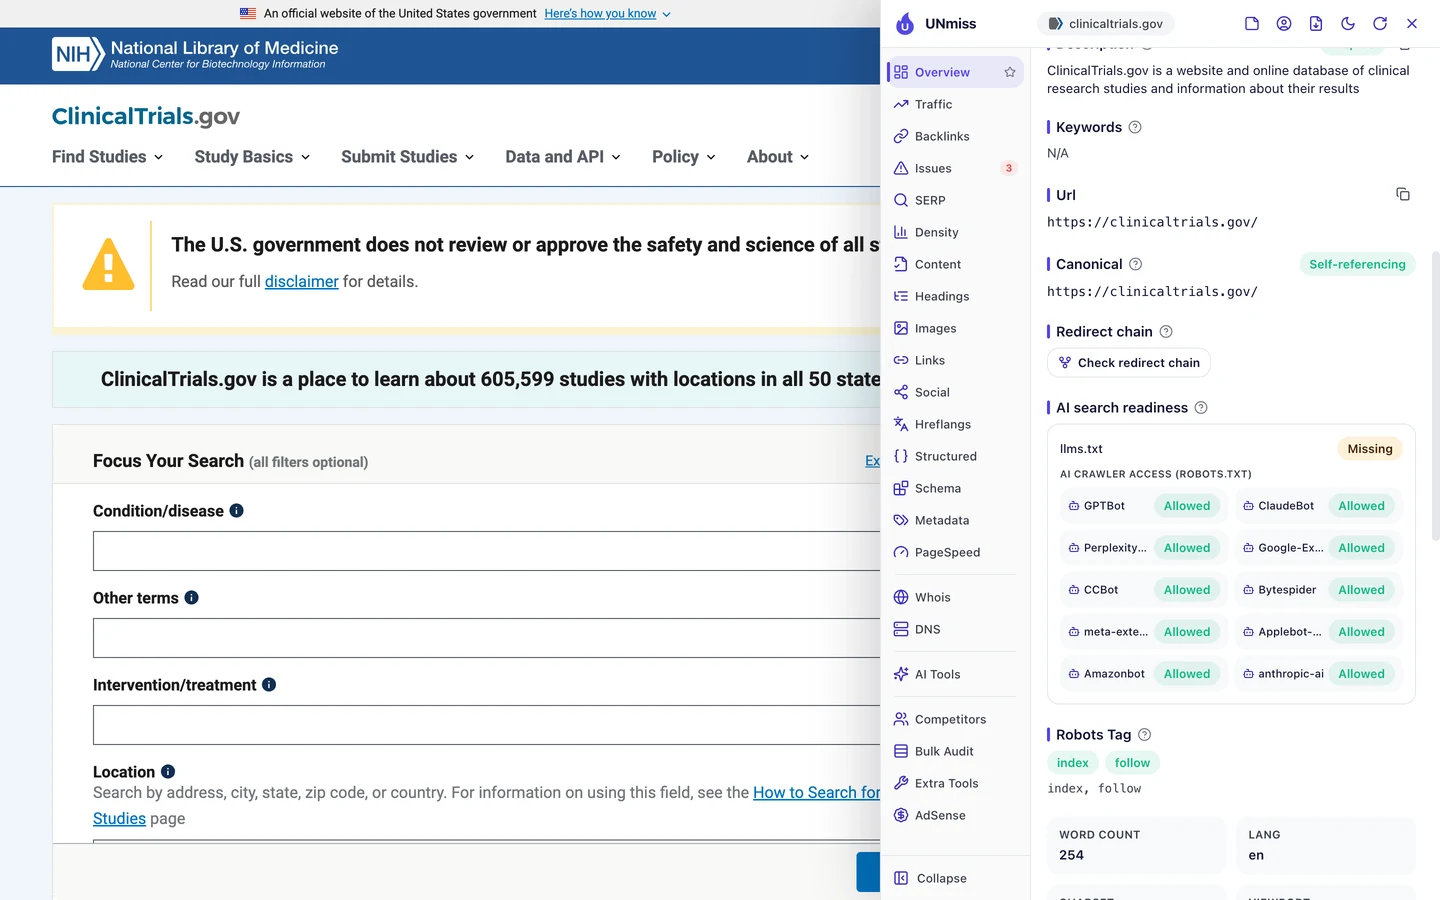
Правила лежат в robots.txt, файле, где написано, что краулерам можно читать. Здесь открыт доступ всем 10 ИИ-краулерам, которых проверяет расширение.
Но войти еще не значит прочитать. ИИ-краулер, который пропускает JavaScript, заходит и видит пустую комнату.
А еще у сайта нет llms.txt, короткого файла, который объясняет ИИ-инструментам, что это за сайт. Как крупные сайты пользуются такими файлами, мы разбирали в нашем исследовании llms.txt.
А каких ИИ-краулеров пускают крупные сайты, мы смотрели в нашем исследовании robots.txt.
Кое-что в robots.txt этого сайта сделано правильно. Файл закрывает страницы с результатами поиска, которых может быть бесконечно много, поэтому краулеры тратят время на настоящие исследования.
Пустую оболочку лечат так: текст отправляют вместе со страницей. При серверном рендеринге вся страница собирается на сервере еще до отправки.
При пререндеринге готовая копия каждой страницы сохраняется заранее. В обоих случаях название и текст исследования оказываются в исходном HTML для любого краулера, а не только для Google.
Так что проследите, чтобы основной текст приходил прямо в HTML. Потом проверьте правила для краулеров в нашем генераторе robots.txt, а в инструменте «Проверка видимости в ИИ» узнайте, упоминают ли вас ИИ-инструменты.
Сократите заголовки до сути
Когда текст уже в HTML, пора заняться заголовком. Это та самая синяя ссылка, которую вы видите в Google.
Вкладка Overview (обзор) в расширении показывает заголовок открытой страницы и оценку из 100 баллов.
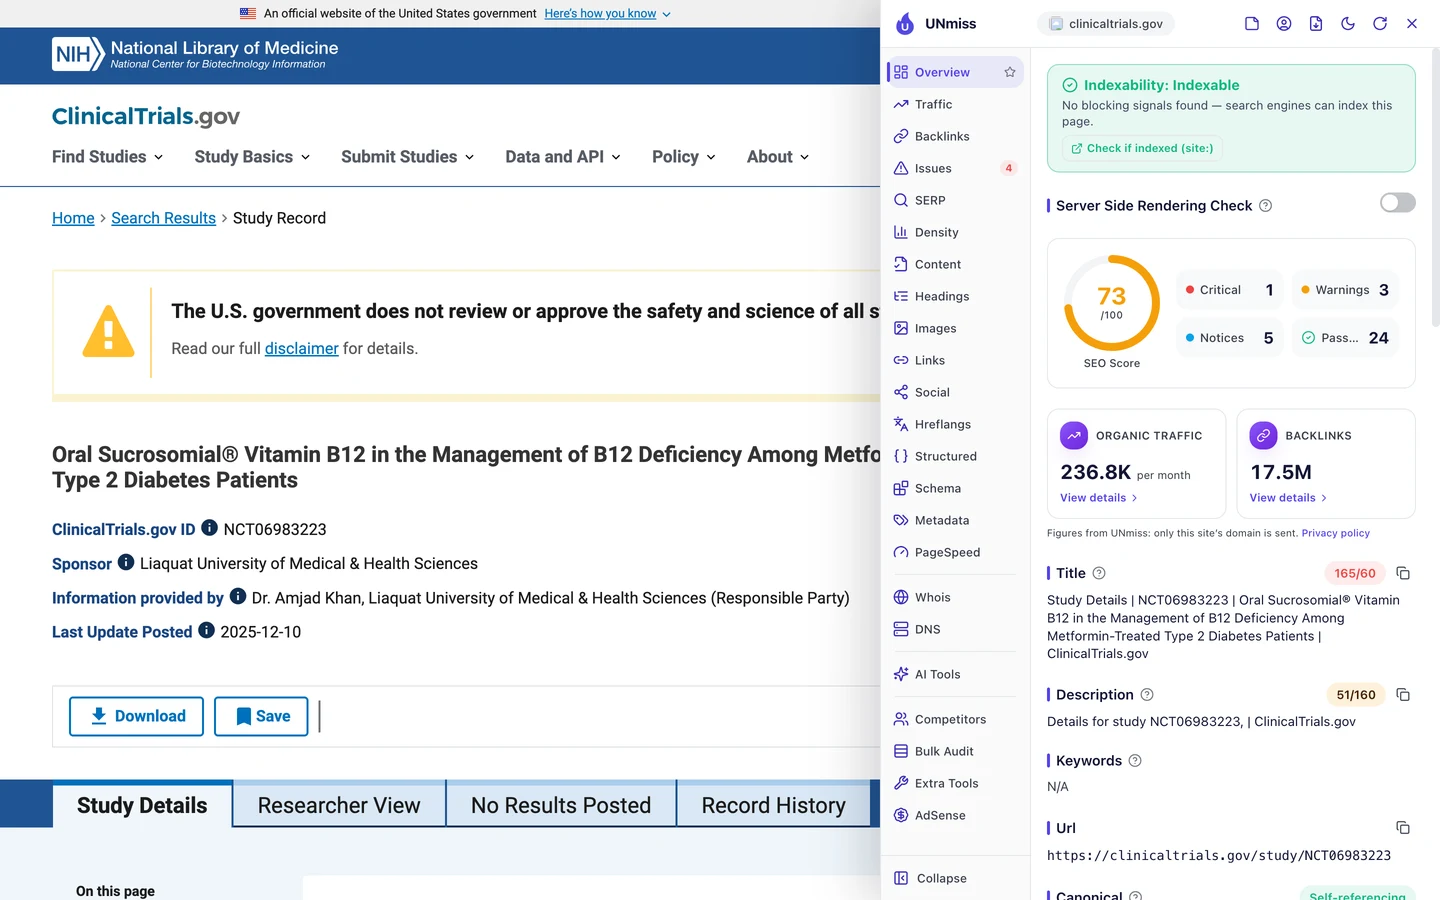
Страница о витамине B12 набирает 73 балла. Ее заголовок занимает 165 символов.
Он начинается с «Study Details» и кода исследования. А слова, которые вы бы искали, идут только после них.
Обычно Google обрезает заголовки примерно на 60 символах. Поэтому в поиске люди видят код и начало длинного научного названия, а остальное пропадает.
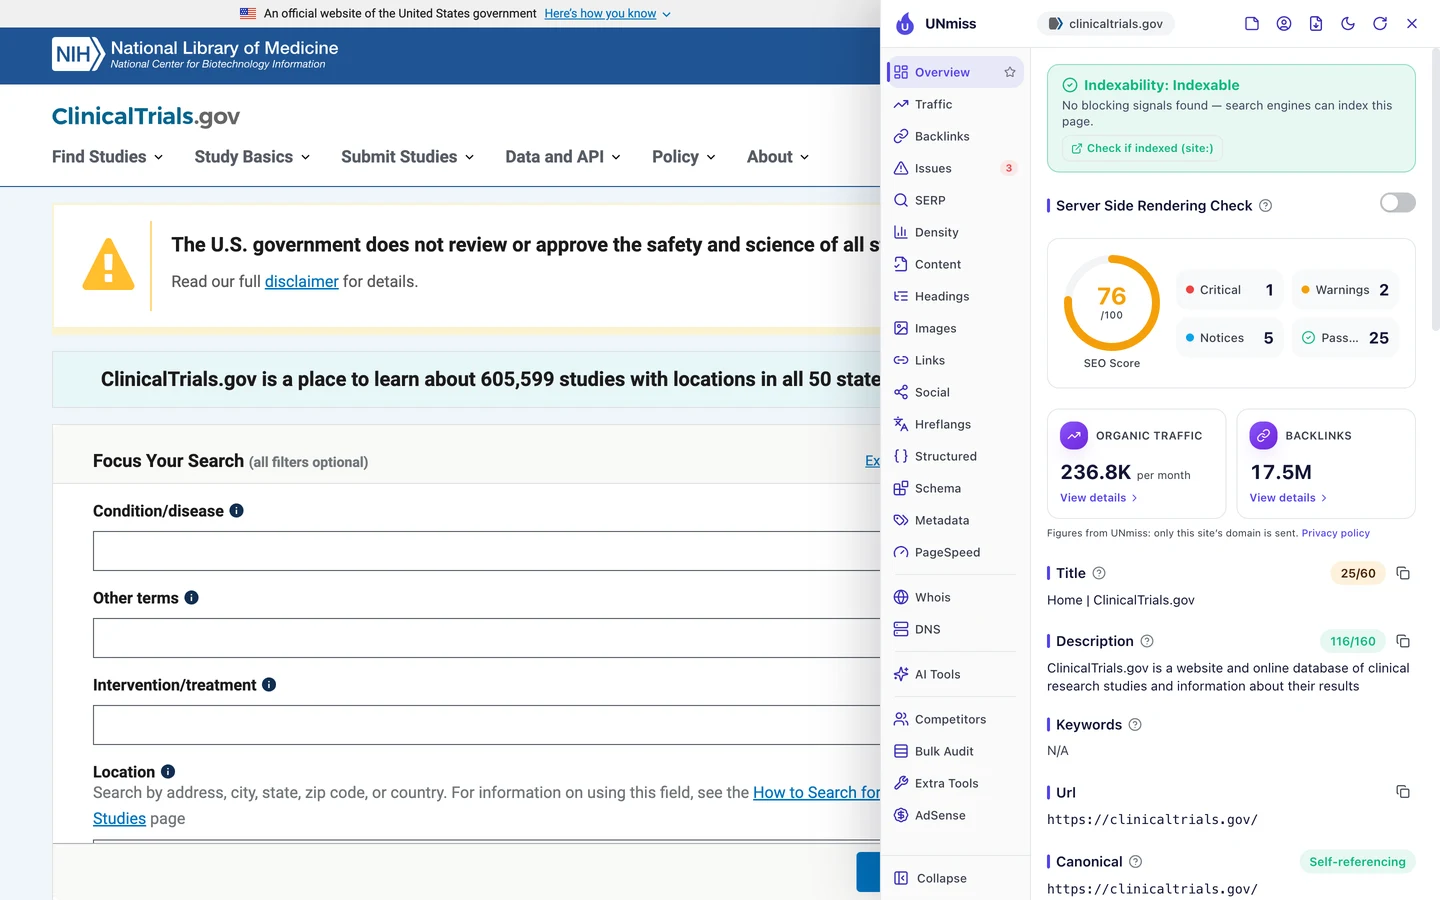
У главной обратная проблема. Ее заголовок, «Home | ClinicalTrials.gov», занимает всего 25 символов.
По запросам с названием сайта она все равно побеждает. Но в заголовке ни слова о поиске исследований, а ведь именно за этим приходят новые посетители.
Заголовок получше начинался бы с темы, например «Vitamin B12 for Diabetes Patients on Metformin», а уже потом шло бы название сайта. Вы бы сразу поняли, о чем страница.
Так что ставьте в начало слова, по которым ищут люди, а длину заголовка держите около 60 символов. Посмотреть, как ваш заголовок выглядит в Google, можно в нашем Симулятор SERPе.
Пишите осмысленные описания
Описанием называют короткую выжимку, которую Google может показать под вашим заголовком. На странице о витамине B12 в нем написано: «Details for study NCT06983223, | ClinicalTrials.gov».
Это 51 символ, да еще и с лишней запятой перед чертой. Похоже на шаблон, который ждал здесь еще одного слова, но так его и не получил.
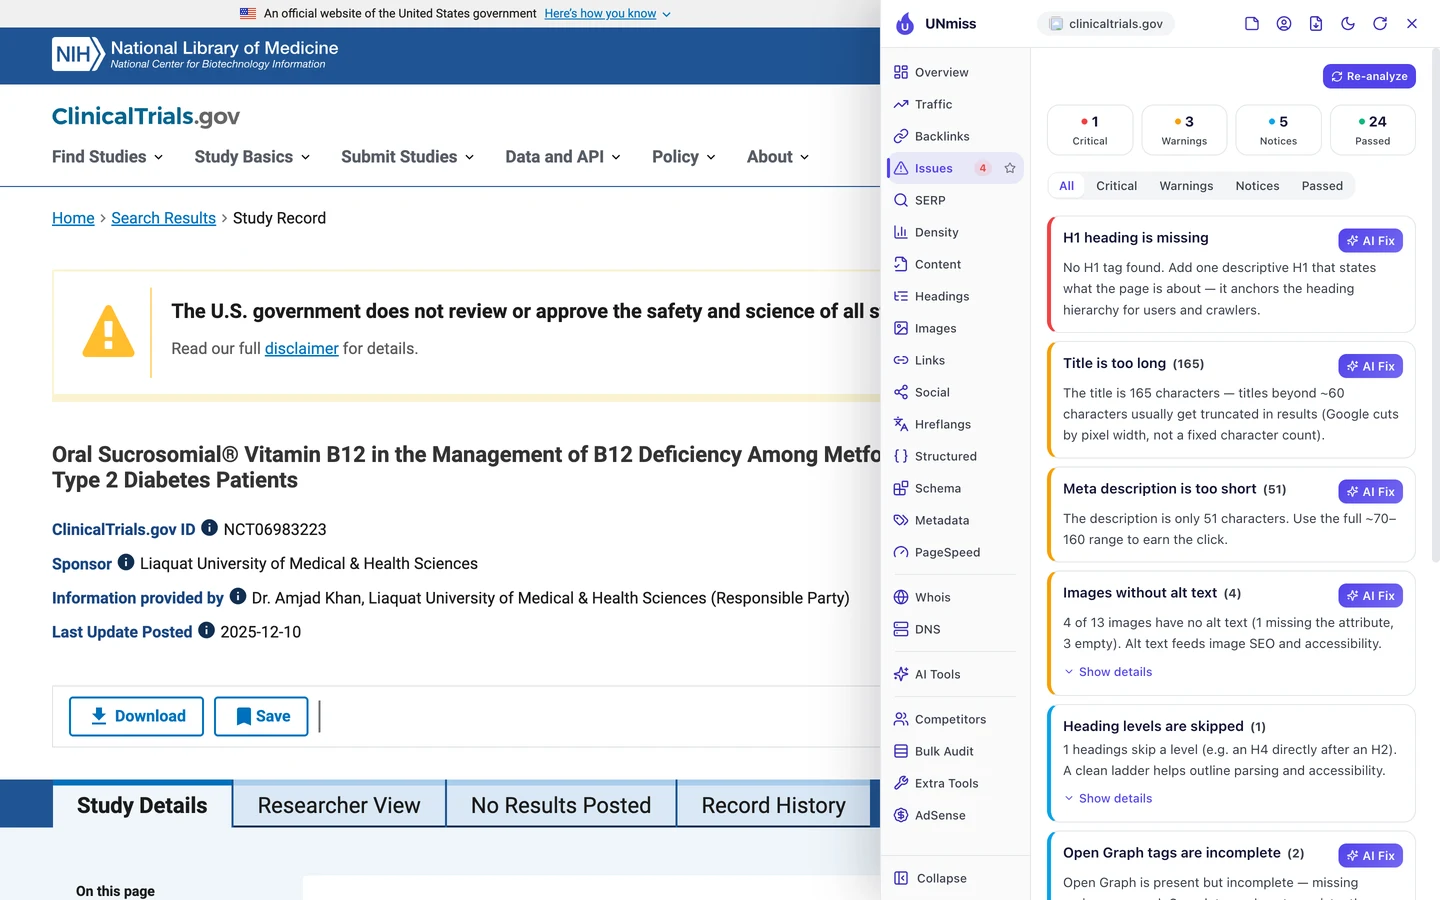
Вкладка Issues (проблемы) отмечает, что описание слишком короткое. Google может показать примерно до 160 символов, а здесь занята лишь треть.
Скорее всего, за каждой страницей исследования стоит такой же шаблон. Значит, одна правка в нем может улучшить их все разом.
Хороший шаблон подставляет настоящие данные: болезнь, способ лечения и то, набирает ли исследование еще участников.
Так что собирайте шаблон описания из фактов конкретной страницы, а не из готовой фразы. Проверить свое описание можно в нашем генераторе метатегов.
Добавьте H1 на каждую страницу
Взгляните еще раз на верх списка Issues. Единственная критическая проблема в нем: нет H1, то есть тега главного заголовка страницы.
На странице исследования есть крупное жирное название. Но в коде оно не размечено как H1.
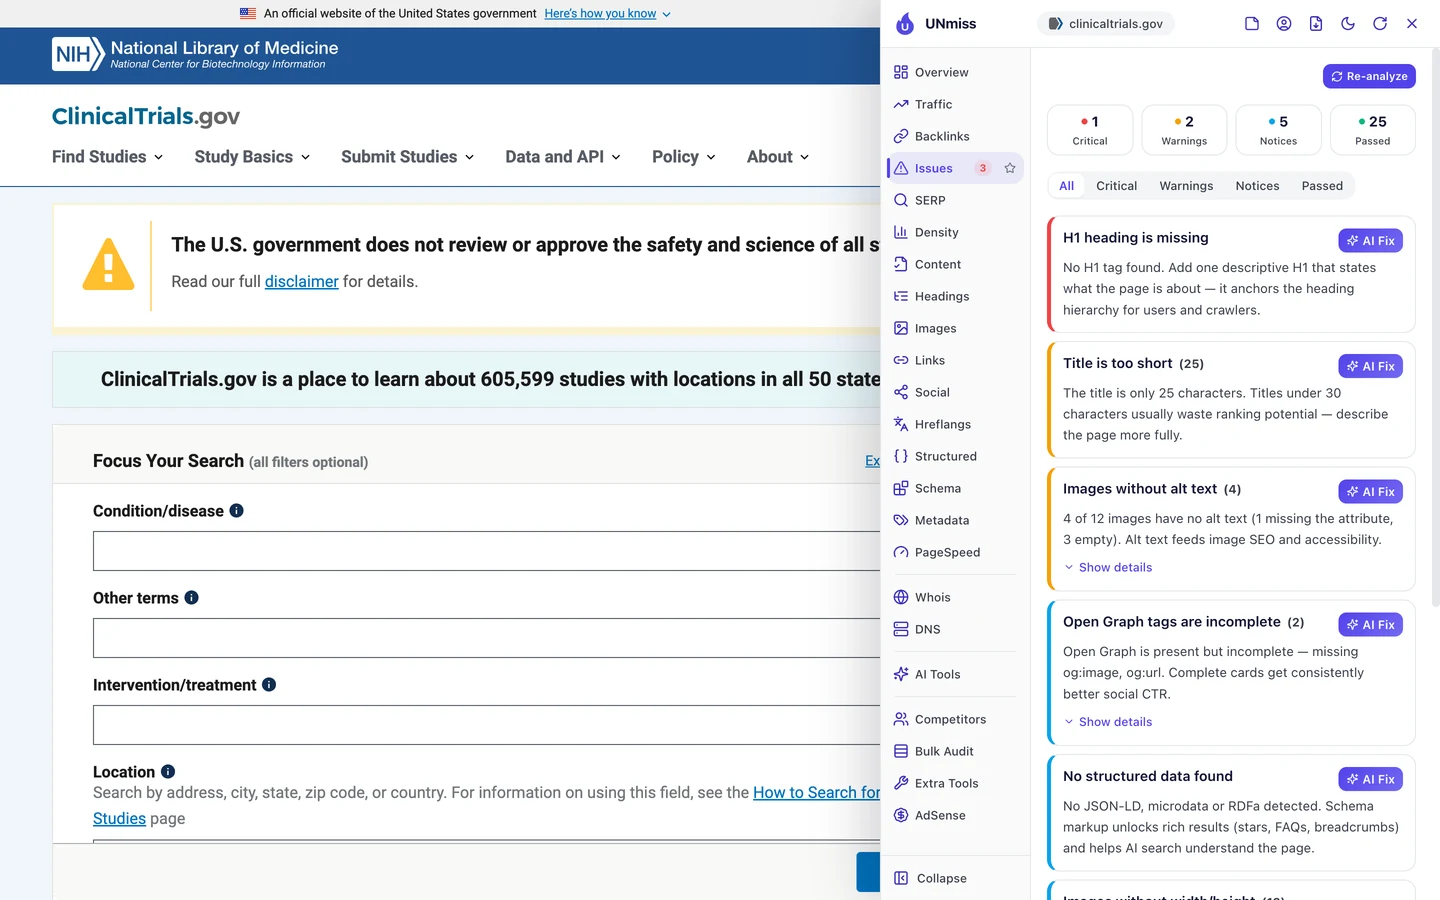
У главной тот же пробел. На обеих страницах единственная критическая проблема в том, что нет H1.
H1 подсказывает Google и программам для чтения с экрана, о чем страница. На странице исследования есть 13 подзаголовков поменьше, но главного над ними нет.
Это маленькая правка в одном шаблоне. Превратите название исследования в H1, и он появится на каждой такой странице.
Заодно добавьте alt-текст 4 картинкам, у которых его нет. Alt-текстом называют короткое описание, которое сообщает Google и программам для чтения с экрана, что изображено на картинке.
Так что проверьте с помощью нашего бесплатного расширения для браузера, есть ли в ваших главных шаблонах один понятный H1. На каждую страницу уйдет несколько секунд.
Разметьте каждое исследование
Структурированными данными называют код, который подсказывает Google, что это за страница: рецепт, товар или медицинское исследование. Вкладка Structured (структурированные данные) в расширении ищет такой код.
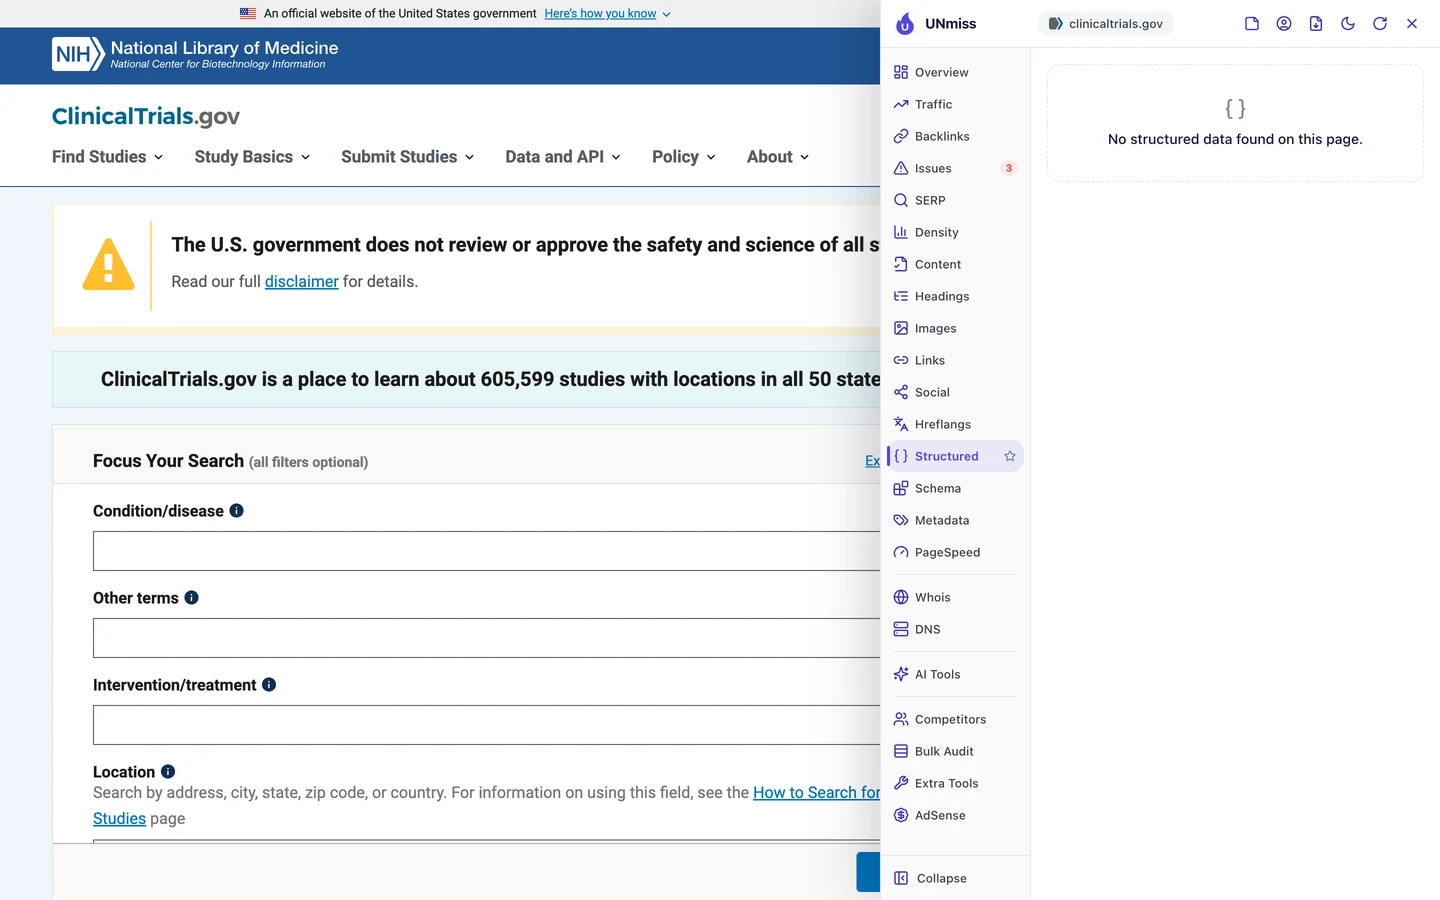
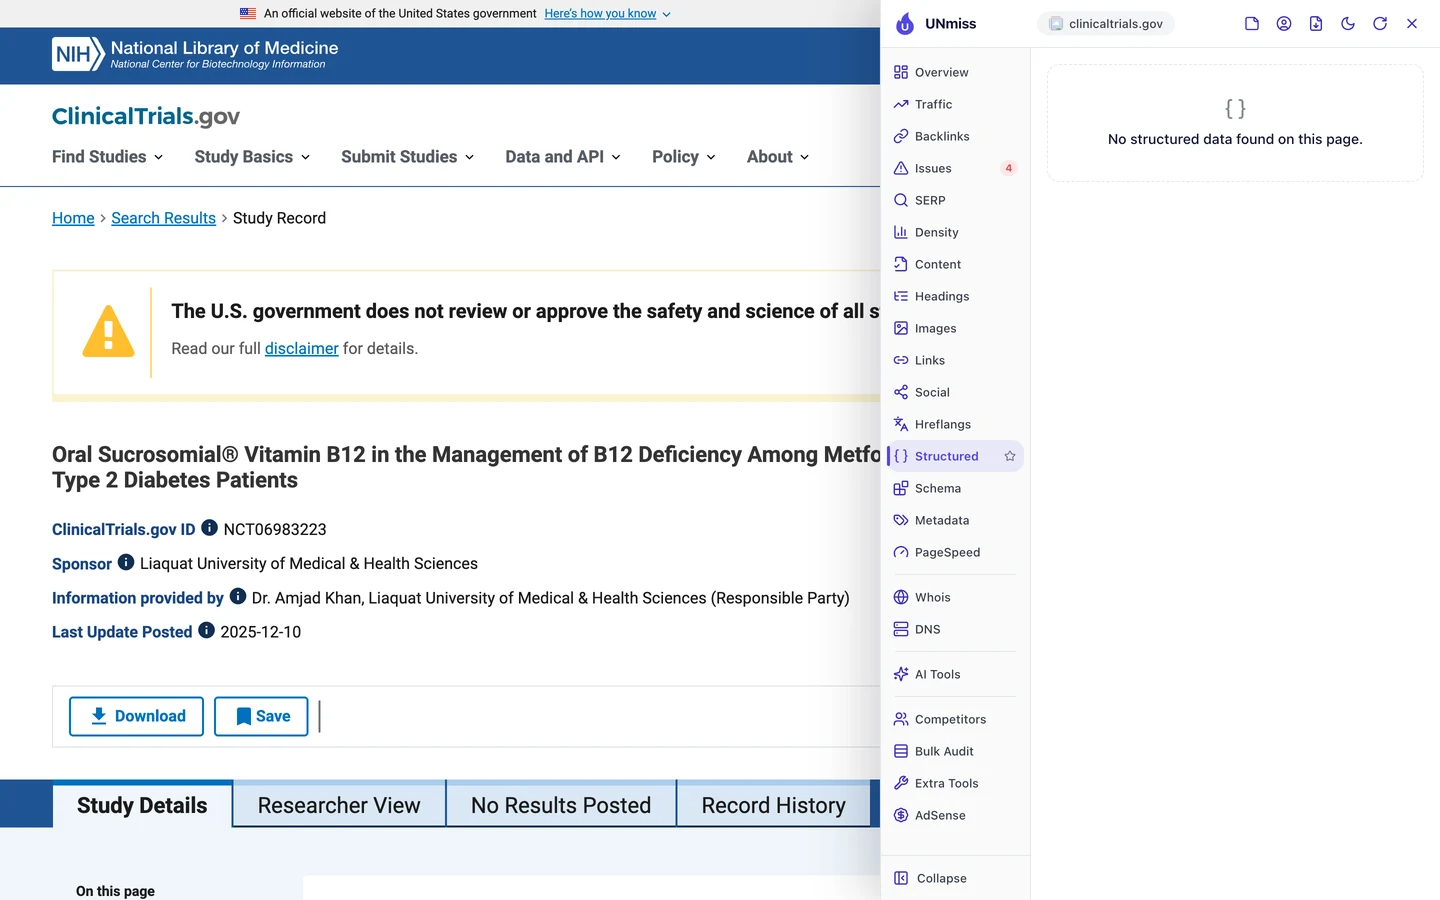
Ни на одной из двух страниц их нет. А для сайта, который буквально набит фактами, это упущенная возможность.
На каждой странице исследования уже видны спонсор, статус и дата последнего обновления. Но вкладка Content не нашла даты в коде.
Код мог бы четко описать все это для Google и ИИ-инструментов. Для этого даже есть готовый тип под названием MedicalStudy.
А вот и бонус. Если добавить такой код в исходный HTML, главные факты смогут прочитать даже краулеры, которые пропускают JavaScript.
Так что добавьте код, который сообщает, что это за страница, кто за нее отвечает и когда она менялась. Наш Генератор разметки Schema напишет его за вас.
Ищите запросы на 2-й странице
Напоследок наш Обзор домена показывает, какие позиции занимает в Google весь сайт.
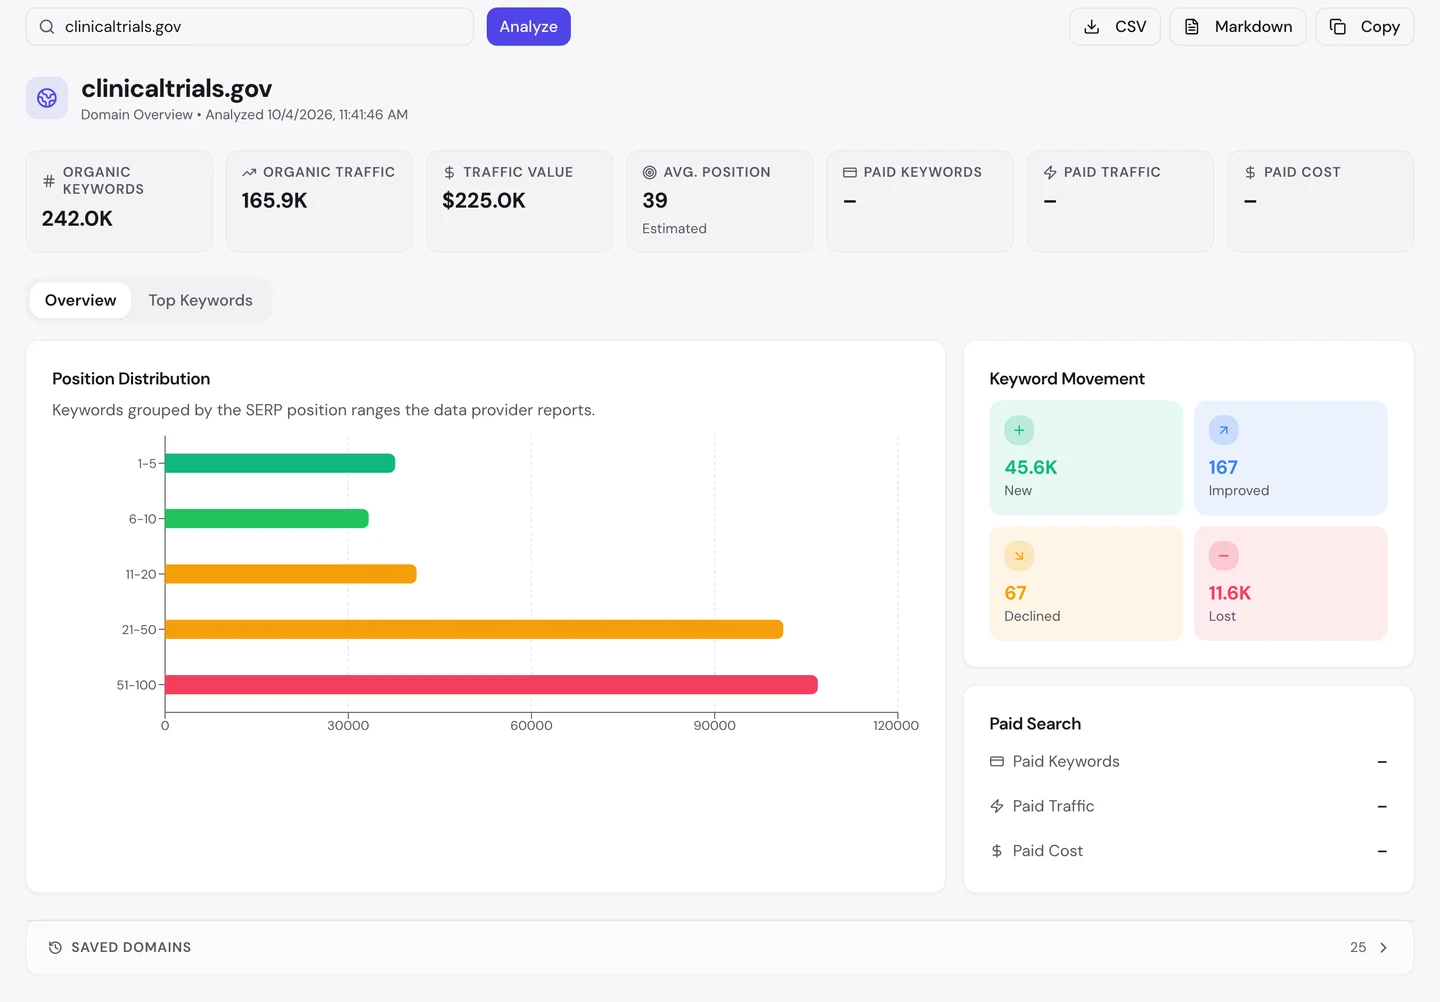
Сайт попадает в выдачу примерно по 242 тыс. запросов. Ценность его трафика около 225 тыс. $ в месяц: столько стоили бы эти посещения, если покупать их через рекламу Google.
Но в среднем он стоит на 39-м месте, то есть на 4-й странице Google. Большинство его ключевых слов ниже 20-го места, а там мало кто кликает.
Блок с динамикой радует. Сайт прибавил около 46 тыс. новых ключевых слов, а потерял около 12 тыс.
Страницы, которым нужен JavaScript, Google может читать дольше. Так что исправление, о котором мы говорили выше, возможно, поможет и здесь.
Быстрее всего выиграть можно на 2-й странице, на местах с 11 по 20. Заголовок получше или более понятный материал могут вытолкнуть такие запросы на 1-ю страницу.
Так что найдите свои ключевые слова на местах с 11-го по 20-е и сначала улучшите эти страницы. А потом следите в нашем Rank Tracker, как они поднимаются.
Наш «Аудит сайта» не смог прочитать ни одной страницы ClinicalTrials.gov, потому что текста исследований нет в исходном HTML. Запустите его на своем сайте и узнайте, что на самом деле получают краулеры с каждой страницы.
- Тот же аудит, который мы провели для ClinicalTrials.gov
- Заголовки, описания и подзаголовки каждой прочитанной страницы
- План от ИИ: что исправить в первую очередь
Что повторить не получится
Сначала о том, чего не скопировать. ClinicalTrials.gov ведет National Library of Medicine, и это официальный сайт правительства США. А его домен зарегистрирован еще в 2000 году.
Расширение насчитывает на него около 17,5 млн обратных ссылок. Обратной ссылкой называют ссылку на ваш сайт с другого сайта, и чтобы набрать столько, нужны годы доверия, а его не купишь.
Но вы все равно можете посмотреть, кто ссылается на вас и на ваших конкурентов, в нашем «Анализаторе обратных ссылок».
Теперь несколько честных замечаний о цифрах.
Мы собрали все цифры 4 октября 2026 года. Цифра 166 тыс. учитывает только поиск в США.
У расширения своя оценка, и она другая: около 237 тыс. в месяц. Обе цифры приблизительные и рассчитаны по позициям и частоте запросов, ведь никто, кроме самого сайта, не знает точного числа посещений.
Наш Website Audit прочитал 0 страниц, поэтому здесь нет ни отчета аудита, ни выборки обхода. Вместо этого мы в тот же день проверили исходный HTML вручную.
Каждого ИИ-краулера по отдельности мы не проверяли. Мы знаем только, что большинство ИИ-краулеров не выполняют JavaScript, а в исходном HTML нет текста исследований.
Google его явно выполняет, раз отдельные исследования попадают в его топ-10. Так что пустой HTML, скорее всего, сильнее бьет по сайту в ИИ-инструментах, чем в Google.
Одно число, которое стоит запомнить
0 слов.
Именно столько текста исследования получает краулер со страницы ClinicalTrials.gov, до того, как запустится хоть какой-то код. А в браузере на той же странице около 1 700 слов.
Google берет на себя лишнюю работу и все равно приводит около 166 тыс. посетителей в месяц. А большинство ИИ-краулеров не станет.
В этом и урок для любого сайта, который работает как приложение на JavaScript. Если ваших слов нет в HTML, часть читателей их так и не увидит.
А что написано в исходном HTML вашего сайта? Проверьте его глазами краулера.
Любую из этих проверок можно запустить для своего сайта и сайтов конкурентов, чтобы своими глазами увидеть такие же цифры.
Частые вопросы
Как посмотреть исходный HTML своей страницы?
В Chrome нажмите на странице правой кнопкой мыши и выберите View Page Source (просмотр кода страницы). Это и есть исходный HTML, и если вашего основного текста там нет, краулеры, которые пропускают JavaScript, его не увидят.
Сложно ли добавить серверный рендеринг?
Зависит от того, как устроен ваш сайт. Во многих современных веб-инструментах он включается одной настройкой, а в старых приложениях часто быстрее сделать пререндеринг ключевых страниц.
Наказывает ли Google сайты на JavaScript?
Нет. Google умеет их читать, но сначала ему нужно выполнить код, и из-за этого лишнего шага новые страницы он может прочитать не так быстро.
Чем пререндеринг отличается от серверного рендеринга?
При серверном рендеринге каждая страница собирается заново, когда ее кто-то запрашивает. При пререндеринге страницы собираются заранее и выдаются сохраненные копии. И в том и в другом случае текст оказывается в HTML.
Поможет ли файл llms.txt пустой странице?
Нет. Он может подсказать ИИ-инструментам, где ваши главные страницы, но текст на этих страницах все равно должен быть в HTML.
Какие структурированные данные подходят для страницы с исследованием или данными?
Для клинических исследований подходит MedicalStudy, а для страниц, где публикуют данные, подходит Dataset. Заполните название, статус, спонсора и даты, которые уже видны на странице.
Стоит ли закрывать от краулеров страницы с результатами поиска?
Обычно да. Их может быть бесконечно много, и они повторяют один и тот же контент, поэтому, если их закрыть, краулеры будут тратить время на ваши настоящие страницы.
Как узнать, могут ли ИИ-инструменты прочитать мой сайт?
Проверьте, что ваш текст есть в исходном HTML, а robots.txt пускает ИИ-краулеров. Потом спросите ИИ-инструменты о вашей теме и посмотрите, назовут ли они вас.