Open Library привлекает из американского Google около 312 000 посетителей в месяц, и почти половина из них попадает на главную страницу, которая стоит на первом месте по простым запросам вроде «read books online free».
Бесплатную онлайн-библиотеку Open Library ведет Internet Archive. Ее цель в том, чтобы завести веб-страницу для каждой книги, которая когда-либо выходила.
Мы прогнали сайт через все наши SEO-инструменты. Среди находок оказались проверка на ботов, которая пускает Google, но останавливает остальных посетителей, и испанский заголовок на странице английской книги.
Ниже 9 уроков, которые можно перенять, и то, что повторить не выйдет.
Выходите в топ не только по бренду
Начали мы с нашего инструмента «Проверка органического трафика». Он оценивает органический трафик сайта, то есть людей, которые находят его в Google сами, без рекламы.
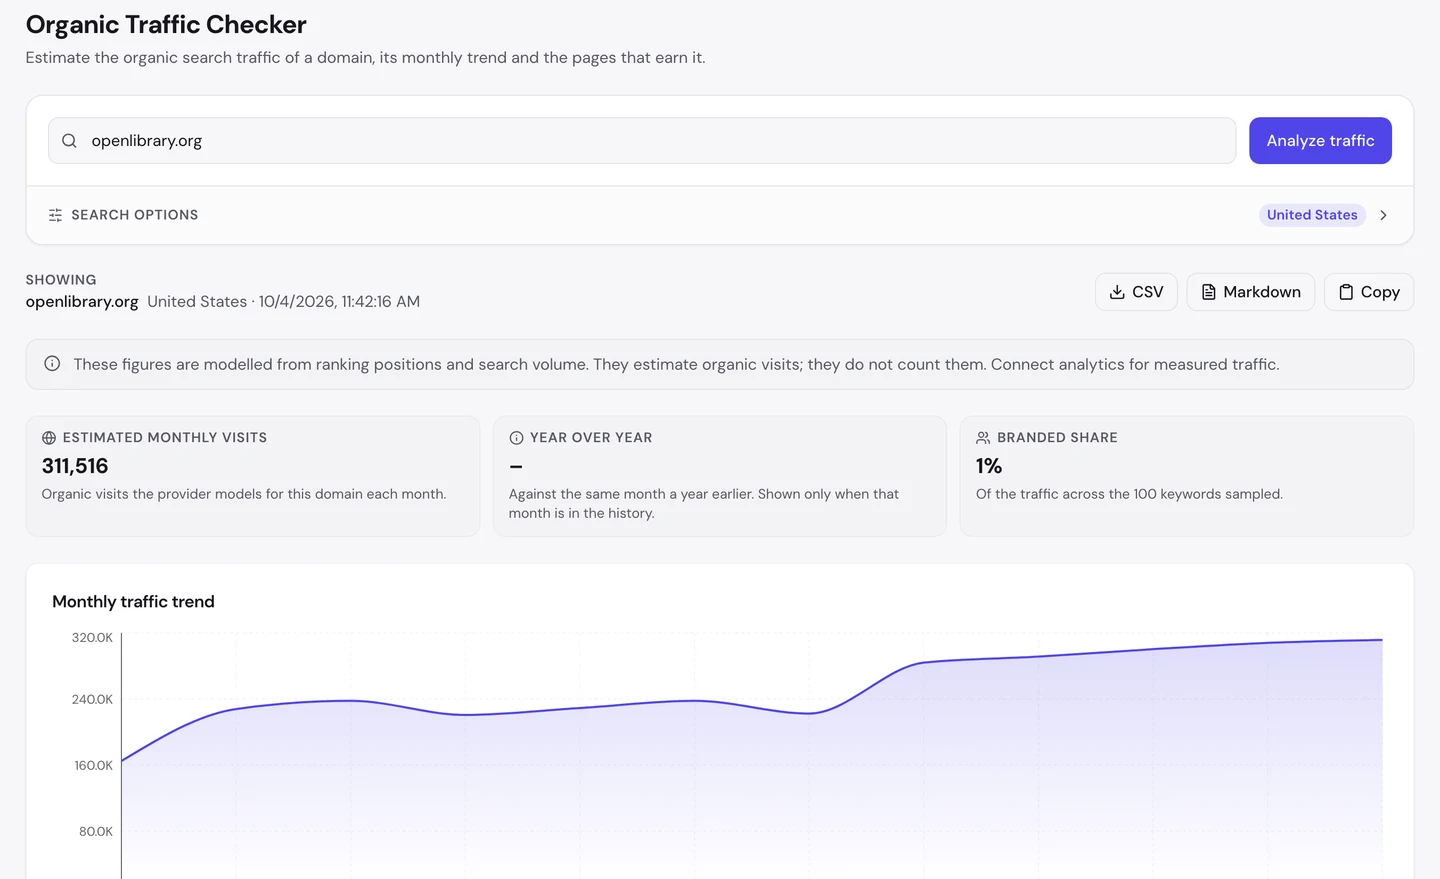
У openlibrary.org это около 312 тыс. посещений в месяц из США. За последний год график вырос почти вдвое.
Почти половина этих посещений приходится на одну страницу, главную. Поэтому мы посмотрели, по каким запросам она выходит в топ.
Вкладка Keywords (ключевые слова) в нашем инструменте «Аудит сайта» показывает запросы, по которым сайт попадает в выдачу, его места в ней и сколько посещений приносит каждый запрос.
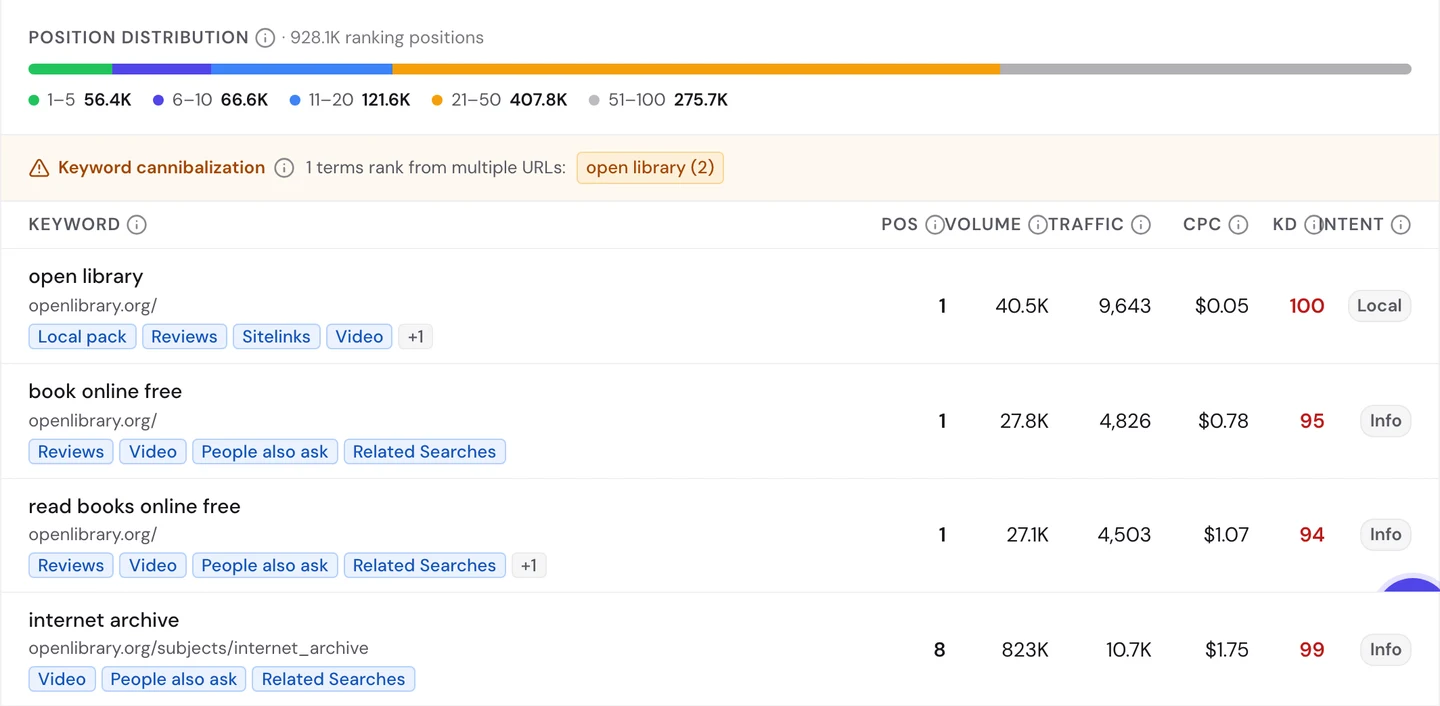
Главная на первом месте по запросу «open library», и это логично. Здесь люди сами ввели название сайта.
Но она же первая и по запросам «book online free» и «read books online free». Каждый из этих запросов вводят около 27 тыс. раз в месяц, и ни в одном нет названия Open Library.
Этим людям просто нужна бесплатная книга. Если вы когда-нибудь искали такую, то, возможно, тоже попадали туда, даже не зная, что это за сайт.
Есть и небольшая загвоздка. Вкладка предупреждает о каннибализации ключевых слов: это когда ваши же страницы борются за один и тот же запрос.
Здесь речь о самом запросе «open library». По нему в выдаче и главная, и страница поиска, но большую часть посещений забирает главная.
Вкладка Traffic (трафик) в аудите показывает картину по всему миру, а не только по США.
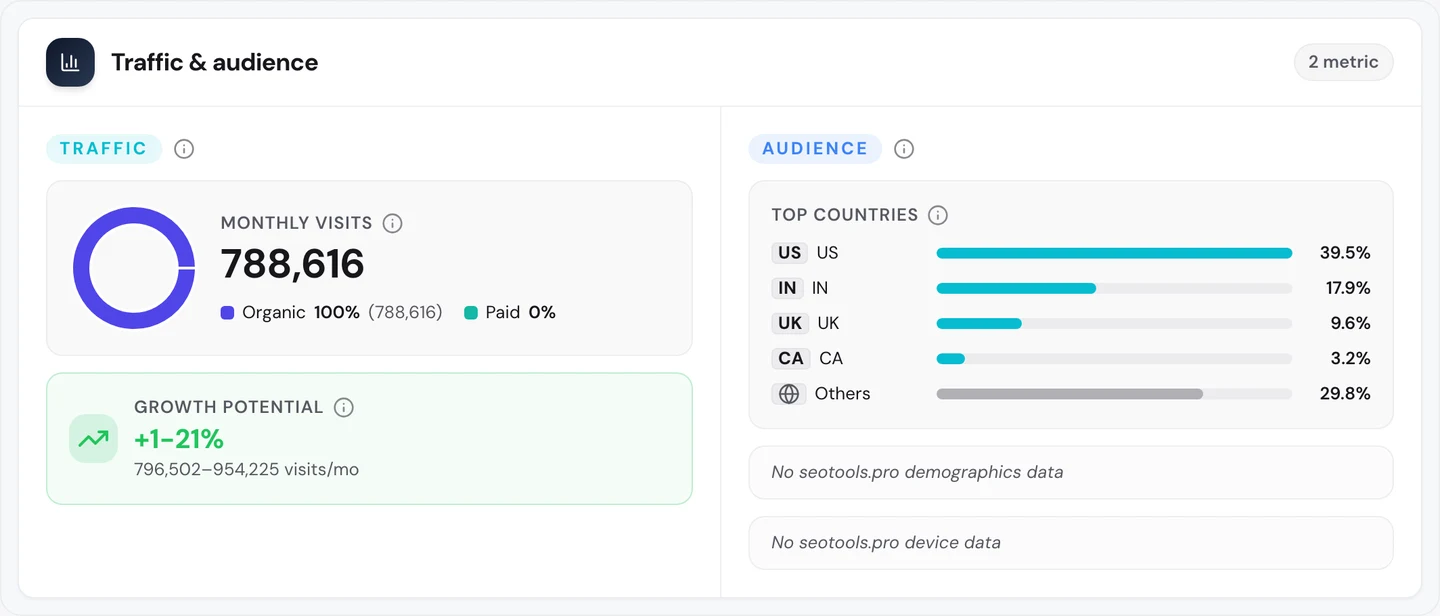
По всему миру Open Library привлекает из поиска около 790 тыс. посетителей в месяц и не платит ни за одного. Примерно 2 из 5 приходят из США, а следом идет Индия.
Так что делайте главную страницу под слова, которые вводят люди, еще не знающие о вас, а не только под свое название. Эти слова покажет наш инструмент «Исследование ключевых слов», а наш инструмент «Проверка органического трафика» покажет, какие страницы по ним выигрывают.
Пропускайте нужных ботов
Дальше мы решили посмотреть на страницу отдельной книги и выбрали Fantastic Mr Fox Роальда Даля.
Мы открыли ее в браузере, которым управляет программа: так наши инструменты проверяют страницы. Книгу Open Library нам не показала.
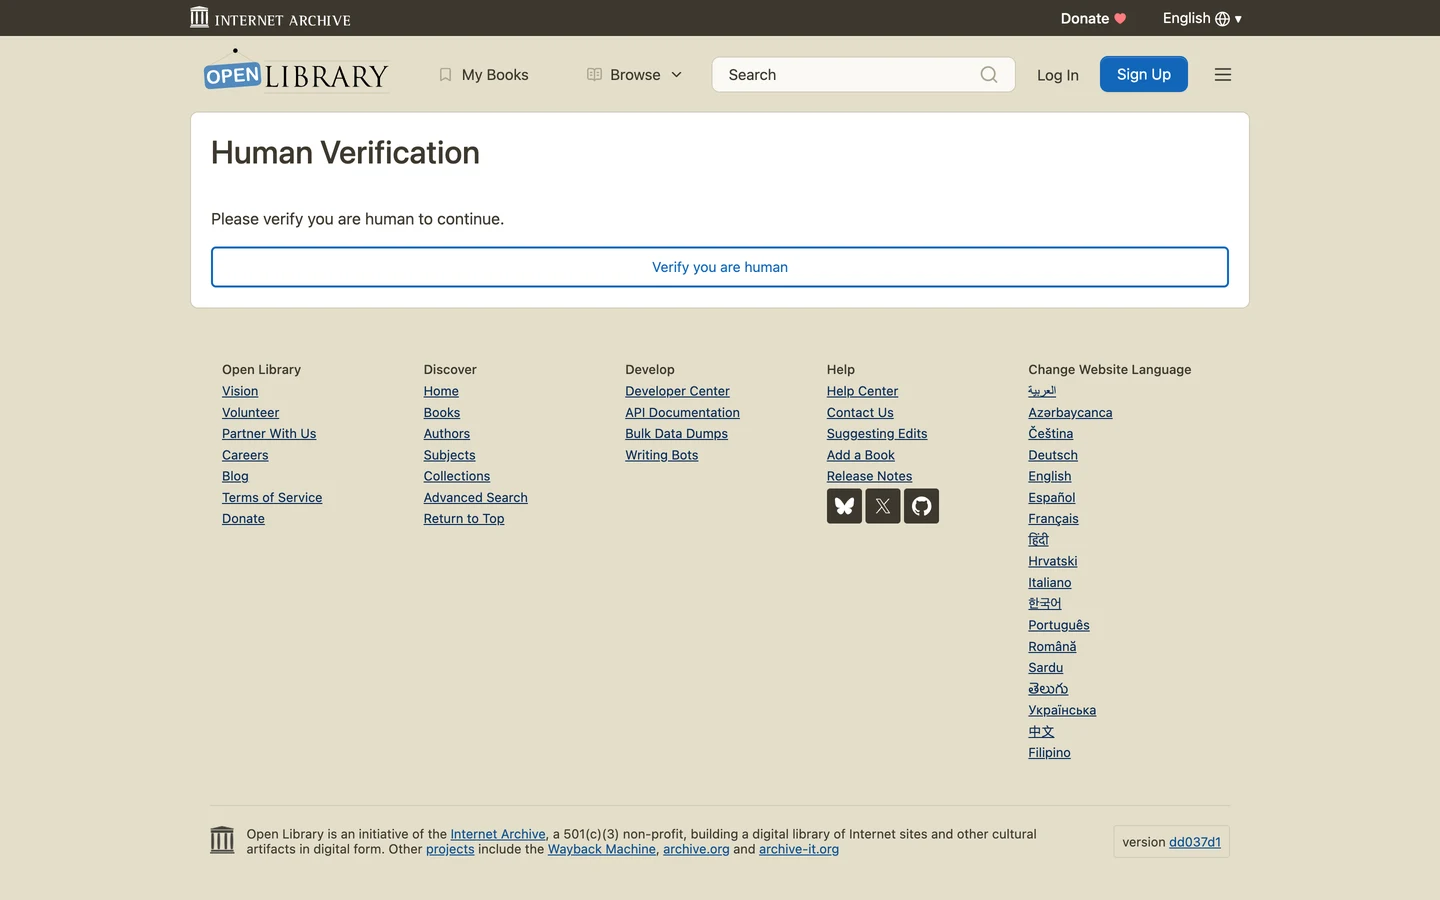
Вместо нее открылась страница «Human Verification». Чтобы пройти дальше, нужно было доказать, что мы люди.
Такие проверки на ботов встречаются часто. Они защищают от скраперов, то есть программ, которые массово копируют страницы.
Потом наше бесплатное расширение для браузера проверило страницу, которую нам выдали. Откройте страницу, нажмите на значок seotools.pro, и рядом появится панель с SEO-проверками.
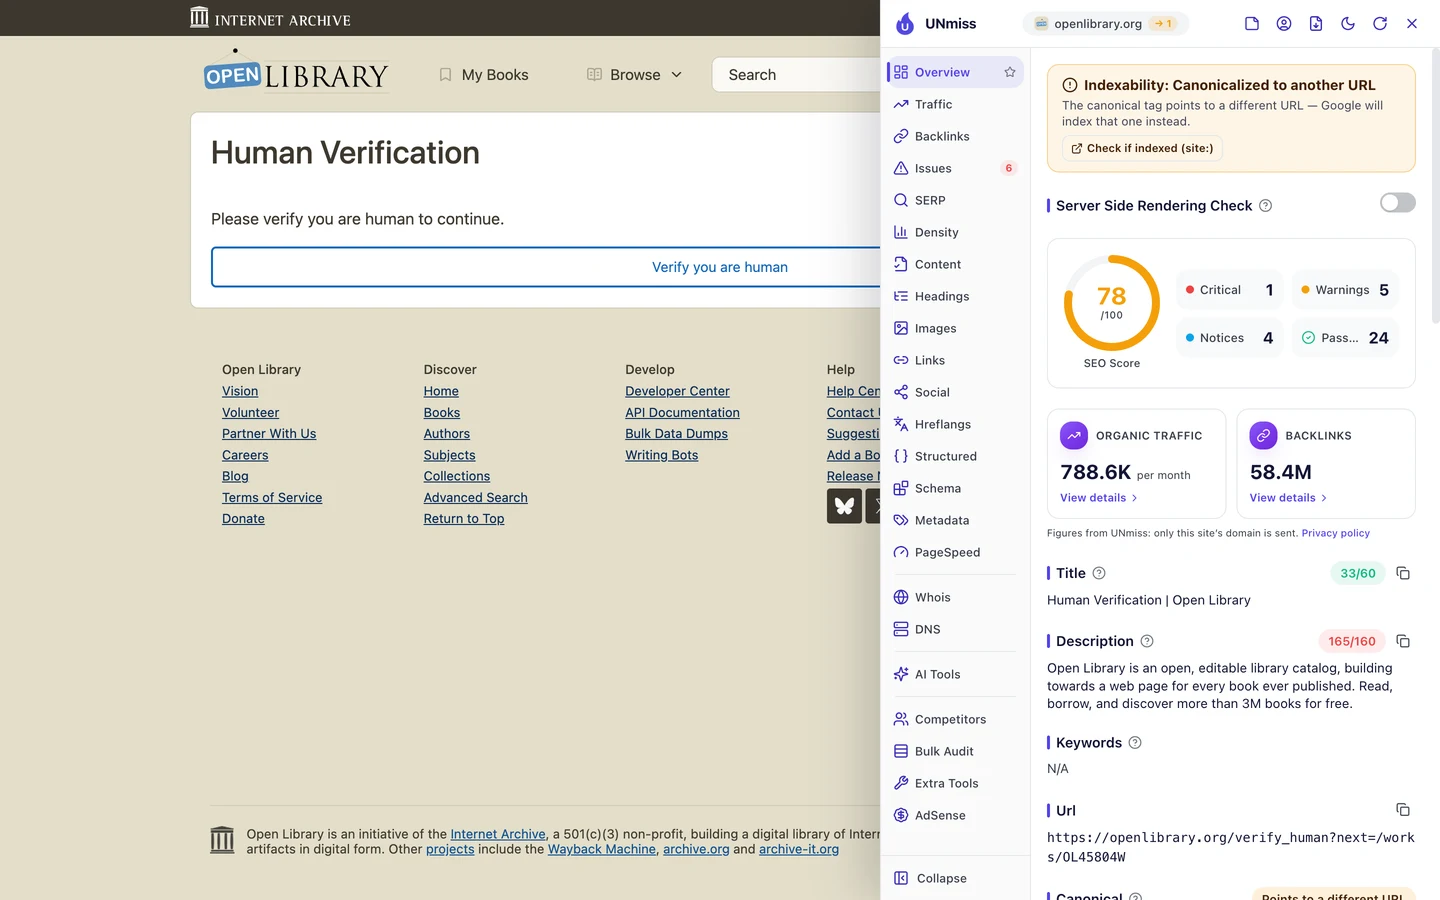
В заголовке написано «Human Verification | Open Library». Адрес тоже сменился: теперь это страница проверки с кодом книги в конце.
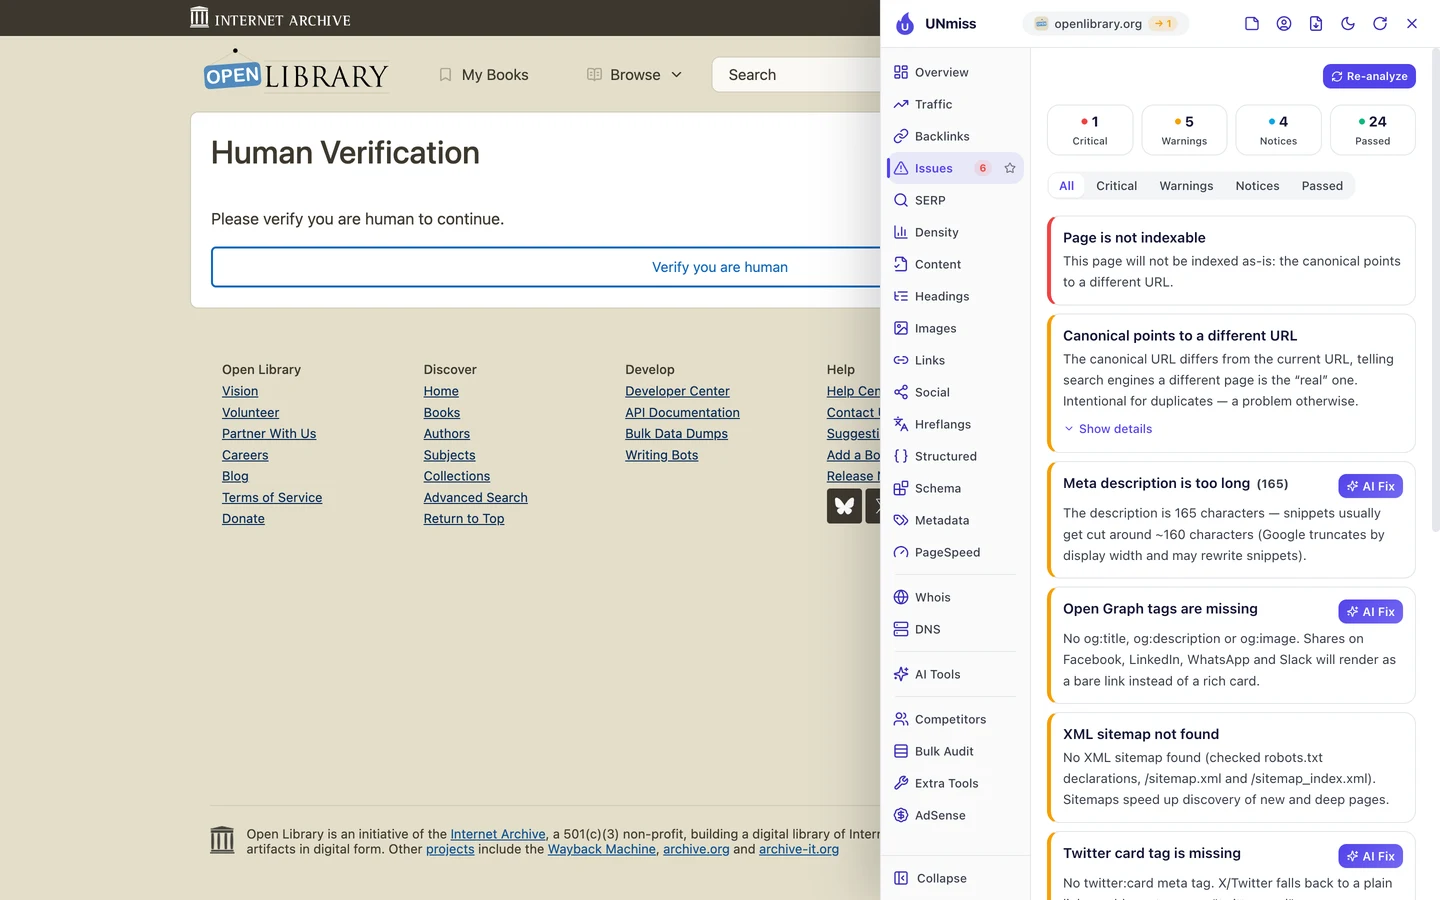
Главная проблема в том, что страница не попадет в индекс, то есть в список страниц, которые Google может показать. Причина в теге canonical. Он подсказывает Google, какой адрес считать основной копией, а здесь указывает на другой адрес.
Для страницы проверки это нормально. Вы точно не захотите, чтобы Google ее показывал.
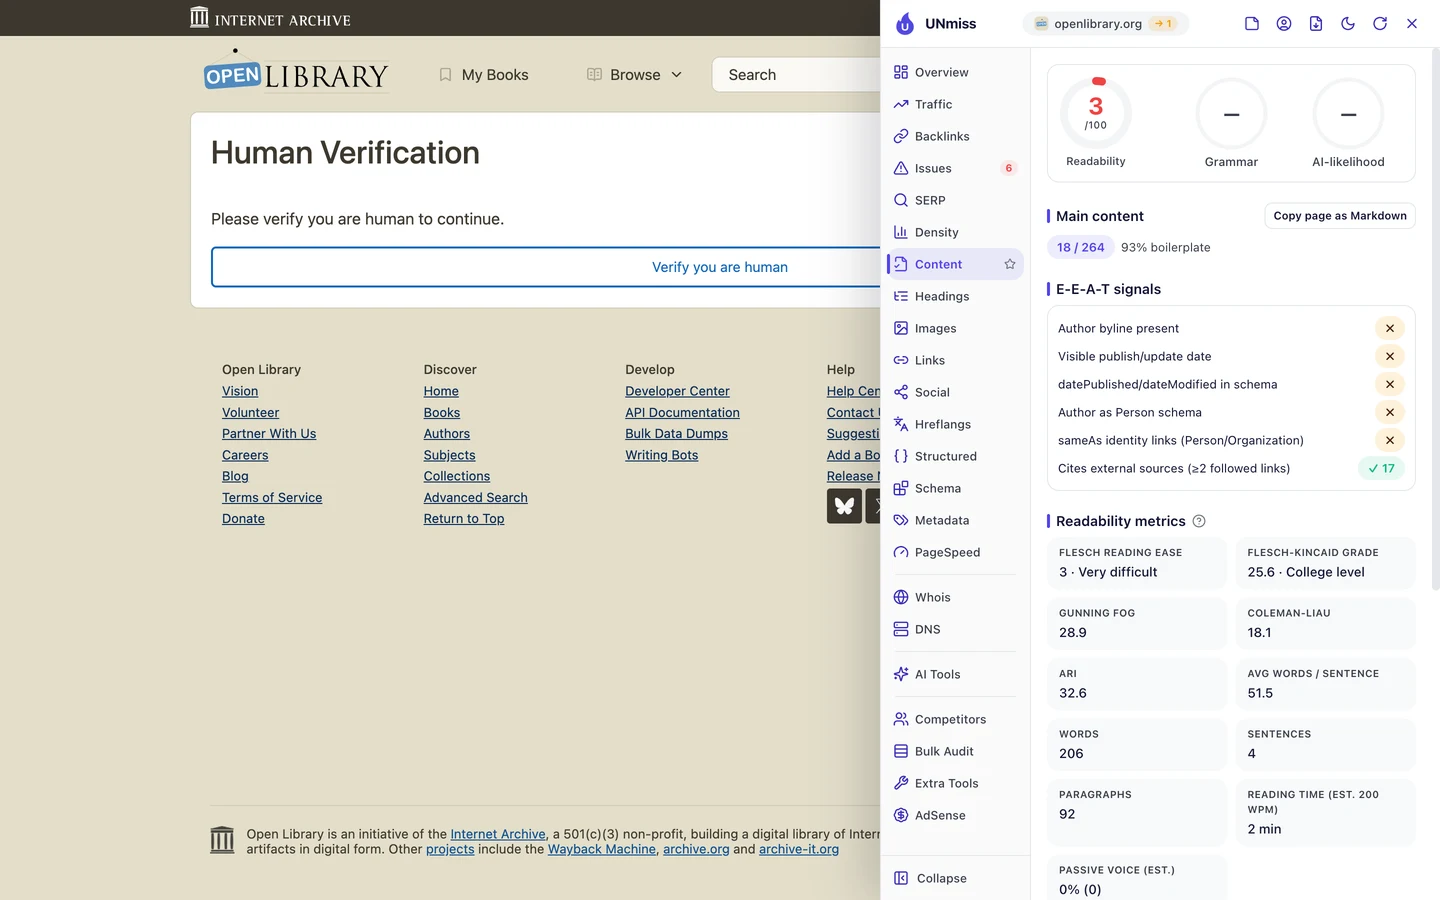
Вкладка Content (контент) показывает, насколько она пустая. Из 264 слов только 18 приходятся на настоящий контент, а остальное занимают меню и подвал.
А Google тоже получает эту страницу? 4 октября мы провели простой тест.
Каждый браузер и бот отправляет user agent, то есть имя, которым он представляется, когда запрашивает страницу. Мы запросили страницу книги под 3 разными именами.
Краулер Google называется Googlebot: эта программа обходит страницы, чтобы Google мог показывать их в поиске. А GPTBot тоже краулер, только от OpenAI, компании, которая создала ChatGPT.
С именем обычного браузера Open Library отправила нас на страницу проверки. А с именами Googlebot и GPTBot мы получили настоящую страницу книги.
Получается, Open Library пускает поисковых и ИИ-краулеров, а всех остальных просит доказать, что они люди. Схема умная, пока исправно работает.
Но есть и риск. Если такое правило когда-нибудь даст сбой, Google может получить страницу проверки сразу на всех книгах.
Правила для краулеров лежат еще и в файле robots.txt: там написано, что им можно читать. Расширение разбирает этот файл за вас.
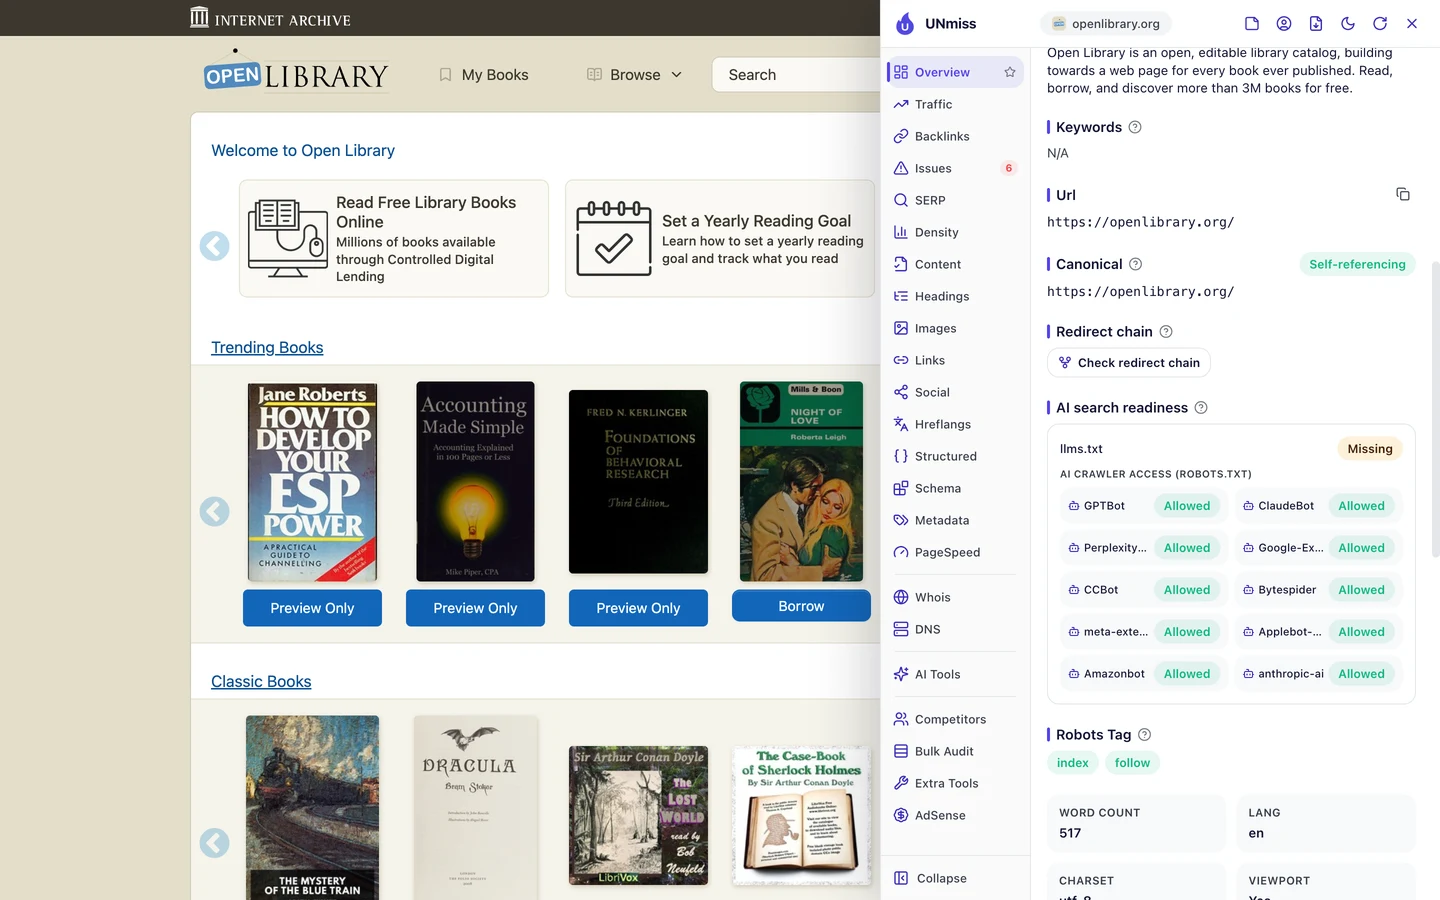
Файл robots.txt у Open Library пускает всех 10 ИИ-краулеров, которых проверяет расширение. А вот llms.txt у сайта нет. В этом коротком файле сайт рассказывает о себе ИИ-инструментам.
Как крупные сайты обходятся с ИИ-краулерами, мы разбирали в нашем кейсе о robots.txt. А наш кейс о llms.txt показывает, кто пользуется этим файлом.
Так что если у вас стоит проверка на ботов, тестируйте страницы глазами Google, ИИ-краулеров и обычного посетителя. Составьте правила для краулеров в нашем генераторе robots.txt, а потом проверьте в нашем инструменте «Проверка видимости в ИИ», упоминают ли вас ИИ-инструменты.
Open Library показывает незнакомым посетителям проверку на ботов, а поисковых и ИИ-краулеров пропускает. Мы проверяем ваш сайт так, как его видят Google, ИИ-инструменты и живые люди, а потом исправляем то, что каждый из них видит неправильно.
- Проверяем ключевые страницы глазами Google, ИИ-краулеров и реальных посетителей
- Проверяем правила для ботов, robots.txt и llms.txt
- Исправляем страницы, которые показывают краулерам проверку или не тот заголовок
- SEO и GEO, чтобы вас цитировали и в ответах ИИ
Берите заголовок, который чаще ищут
У настоящей страницы книги нашелся еще один сюрприз. Ее заголовок, то есть синяя ссылка, которую Google показывает для страницы, оказался совсем не таким, как можно было ожидать.
Для Googlebot страница Fantastic Mr Fox называлась «El Superzorro by Roald Dahl | Open Library». По-испански эта книга называется El Superzorro.
Получается, английская страница знаменитой детской книги носила название испанского издания. Человек из США искал бы «Fantastic Mr Fox», а не «El Superzorro».
Open Library собирает многие издания одной книги на одной общей странице. Похоже, эта страница взяла заголовок не у того издания.
У заголовка главной страницы проблема помельче. Расширение показывает его на вкладке Overview (обзор).
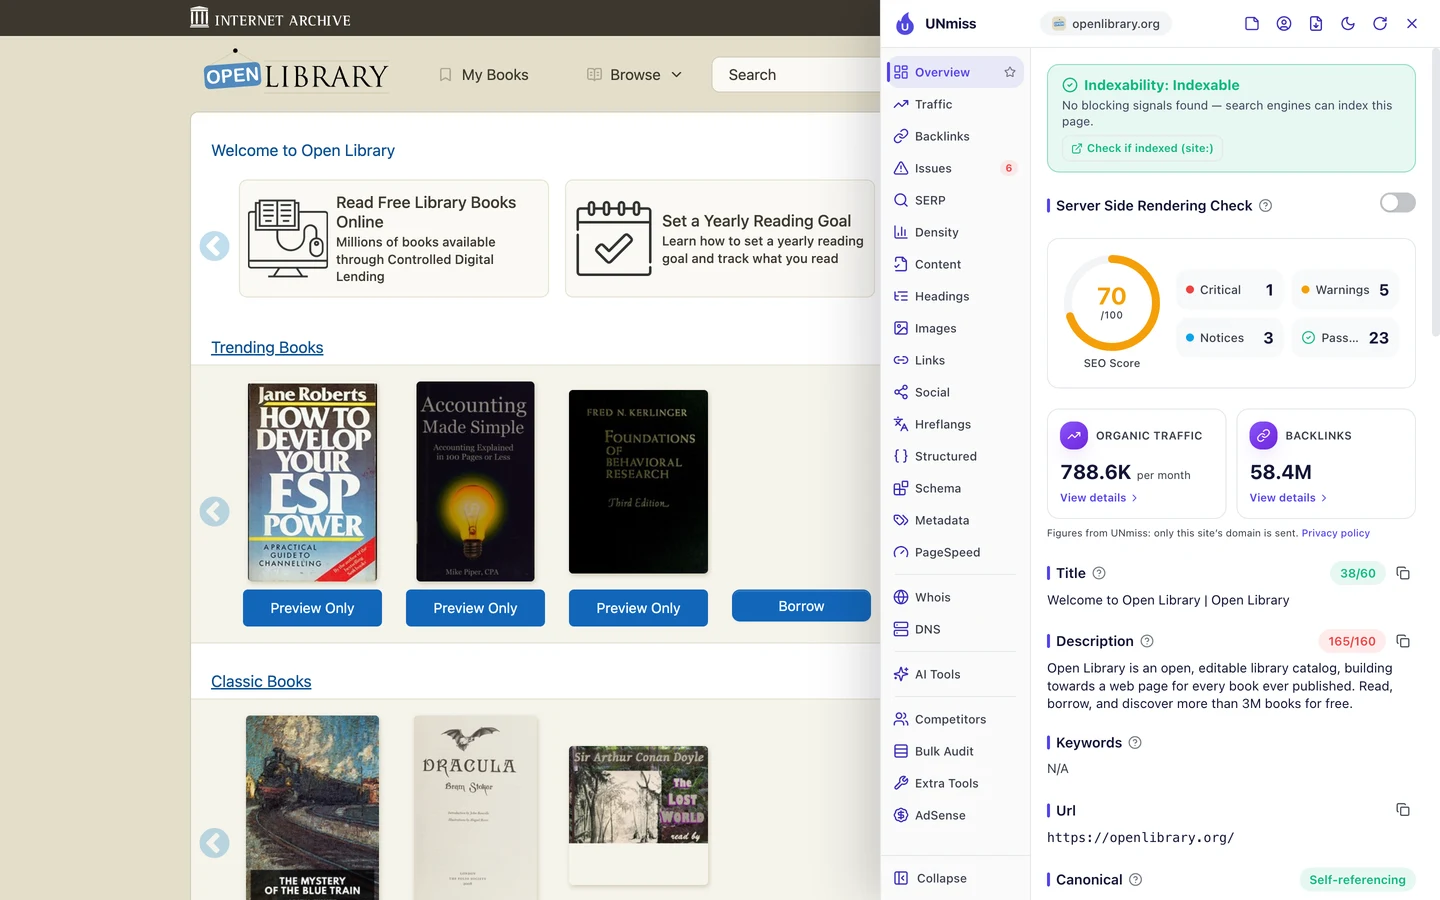
В нем написано «Welcome to Open Library | Open Library», то есть название стоит в нем дважды. При этом страница выходит в топ по запросам о бесплатных книгах онлайн, а этих слов в заголовке нет вообще.
И все равно она на первом месте. Новому сайту с меньшим числом ссылок такое могло бы и не сойти с рук.
У PHP.net, который мы тоже разбирали, в заголовках стояли кодовые названия вместо слов, которые ищут люди. Исправляется это так же.
Так что дайте каждой странице заголовок, который ищет большинство, причем на языке этих людей. Как ваш заголовок выглядит в Google, покажет наш Симулятор SERP.
Пишите описание для каждой страницы
В описании коротко сказано, о чем страница, и Google может показать его под вашим заголовком. На главной Open Library описание длиной 165 символов.
Google обычно обрезает его примерно после 160 символов. Так что конец описания люди могут так и не увидеть.
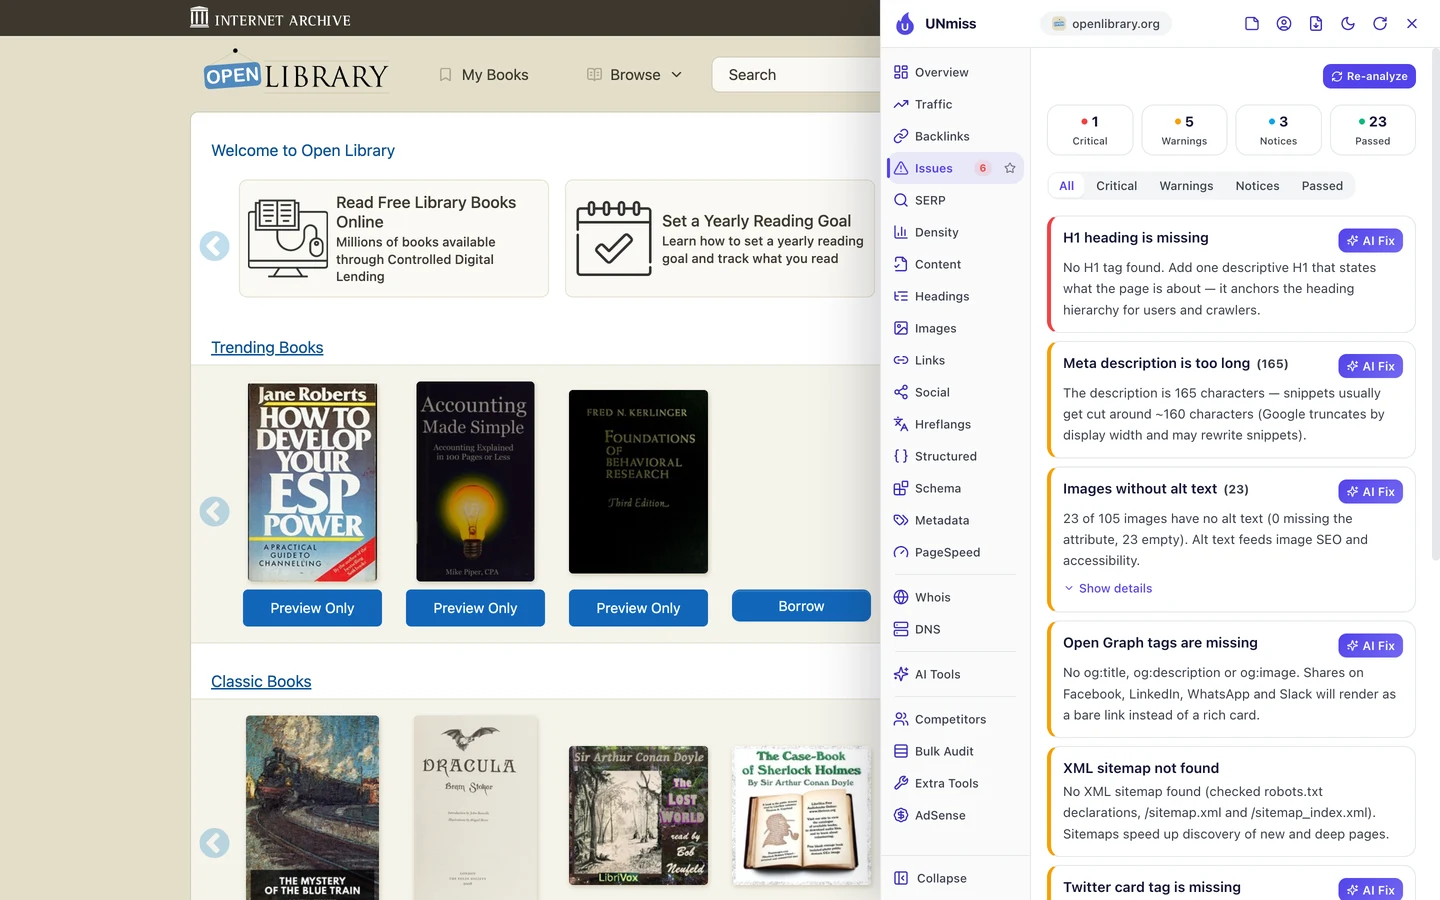
Вкладка Issues (проблемы) ставит на первое место отсутствие H1. Тегом H1 размечают главный заголовок страницы, а на главной его нет.
Еще она отмечает 23 из 105 изображений без alt-текста. Alt-текст коротко описывает картинку, чтобы Google и программы для чтения с экрана понимали, что на ней.
А потом мы нашли кое-что посерьезнее. Это же длинное описание кочует со страницы на страницу.
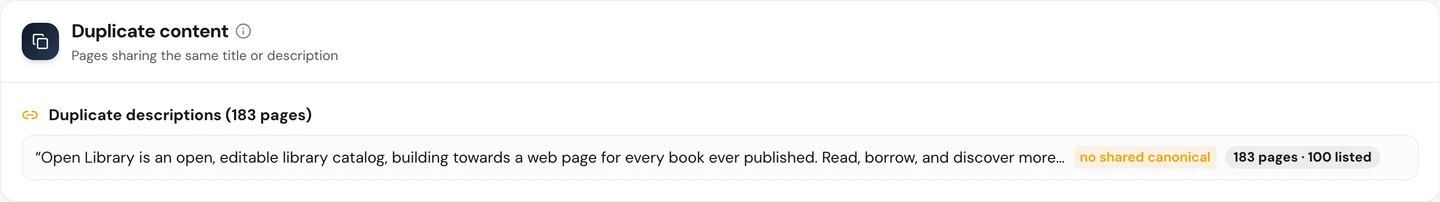
Наш аудит нашел текст с главной на 183 страницах, слово в слово. Для Google все эти страницы на одно лицо, и в выдаче их тоже не отличить друг от друга.
В таких случаях Google часто пишет собственное описание. И вы уже не решаете, что люди прочитают перед тем, как нажать на ссылку.
Так что напишите свое короткое описание для каждой страницы или настройте шаблон так, чтобы он собирал его из фактов самой страницы. Наш Генератор метатегов поможет его написать и проверить длину.
Разметьте кодом каждую книгу
Структурированными данными называют код, который подсказывает Google, что это за страница: книга, человек или место. Вкладка Structured (структурированные данные) в расширении ищет такой код.
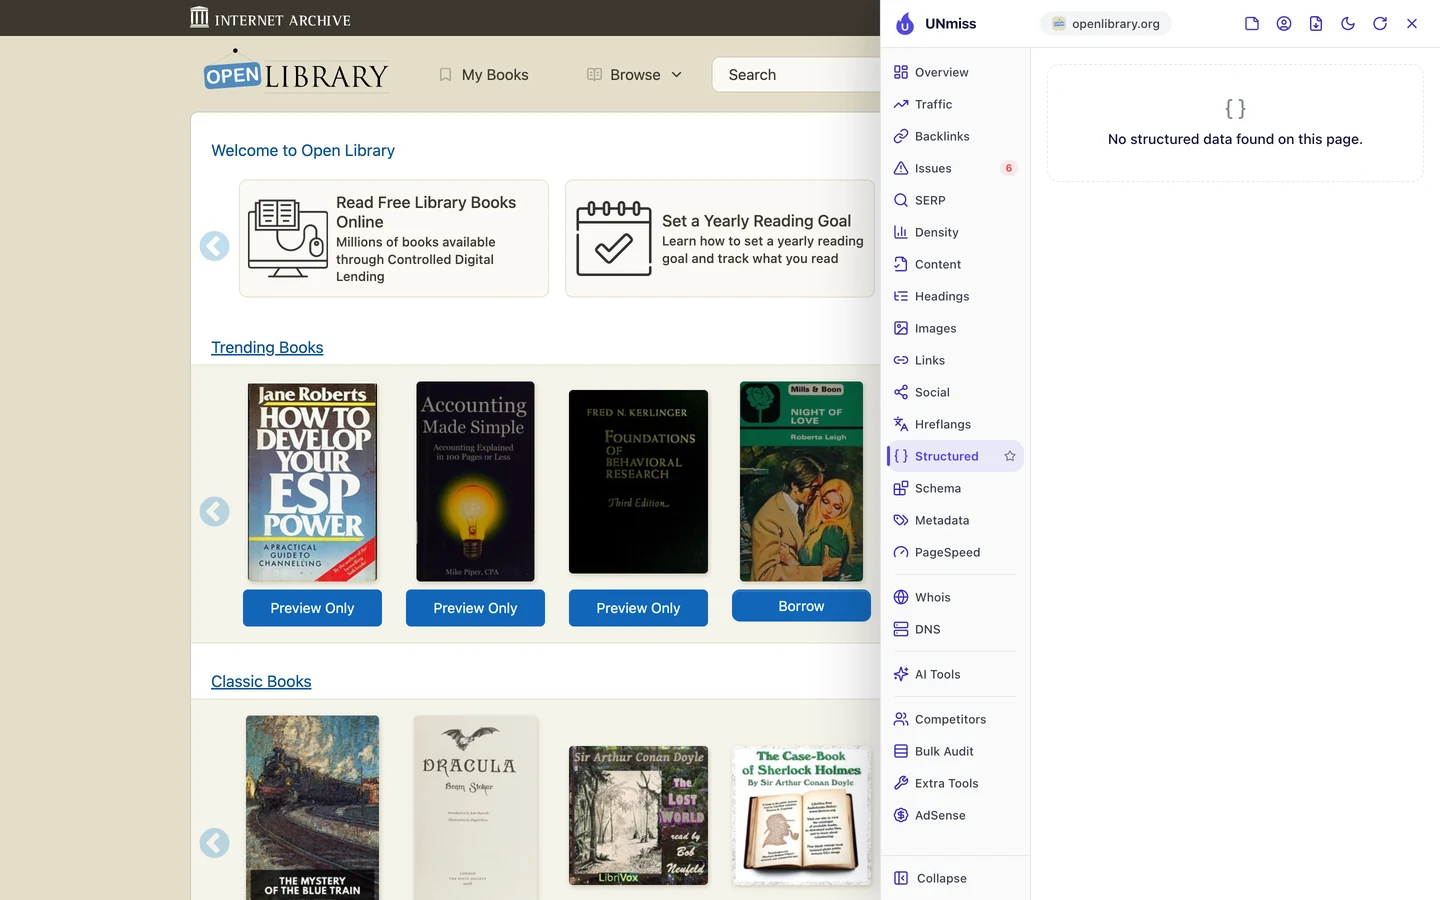
На главной мы их не нашли. А страницу книги так же проверить не удалось, потому что наш тестовый браузер уперся в проверку на ботов.
Для библиотеки это упущенная возможность. Для такого кода есть тип Book, где можно указать автора, издание и ISBN, то есть номер, который печатают на задней обложке книги.
Это помогает и ИИ-инструментам. Такой код прямо сообщает чат-боту, о какой книге и каком авторе речь, и гадать ему не приходится.
Так что добавьте на каждую страницу код, который сообщает, что на ней книга, кто ее написал и какое это издание. Наш Генератор разметки Schema напишет его за вас.
Получайте ссылки от школ
Обратная ссылка ведет на ваш сайт с другого сайта. Google считает каждую такую ссылку чем-то вроде голоса доверия.
Вкладка Backlinks (обратные ссылки) в нашем аудите показывает те же данные, что и наш инструмент «Анализатор обратных ссылок».
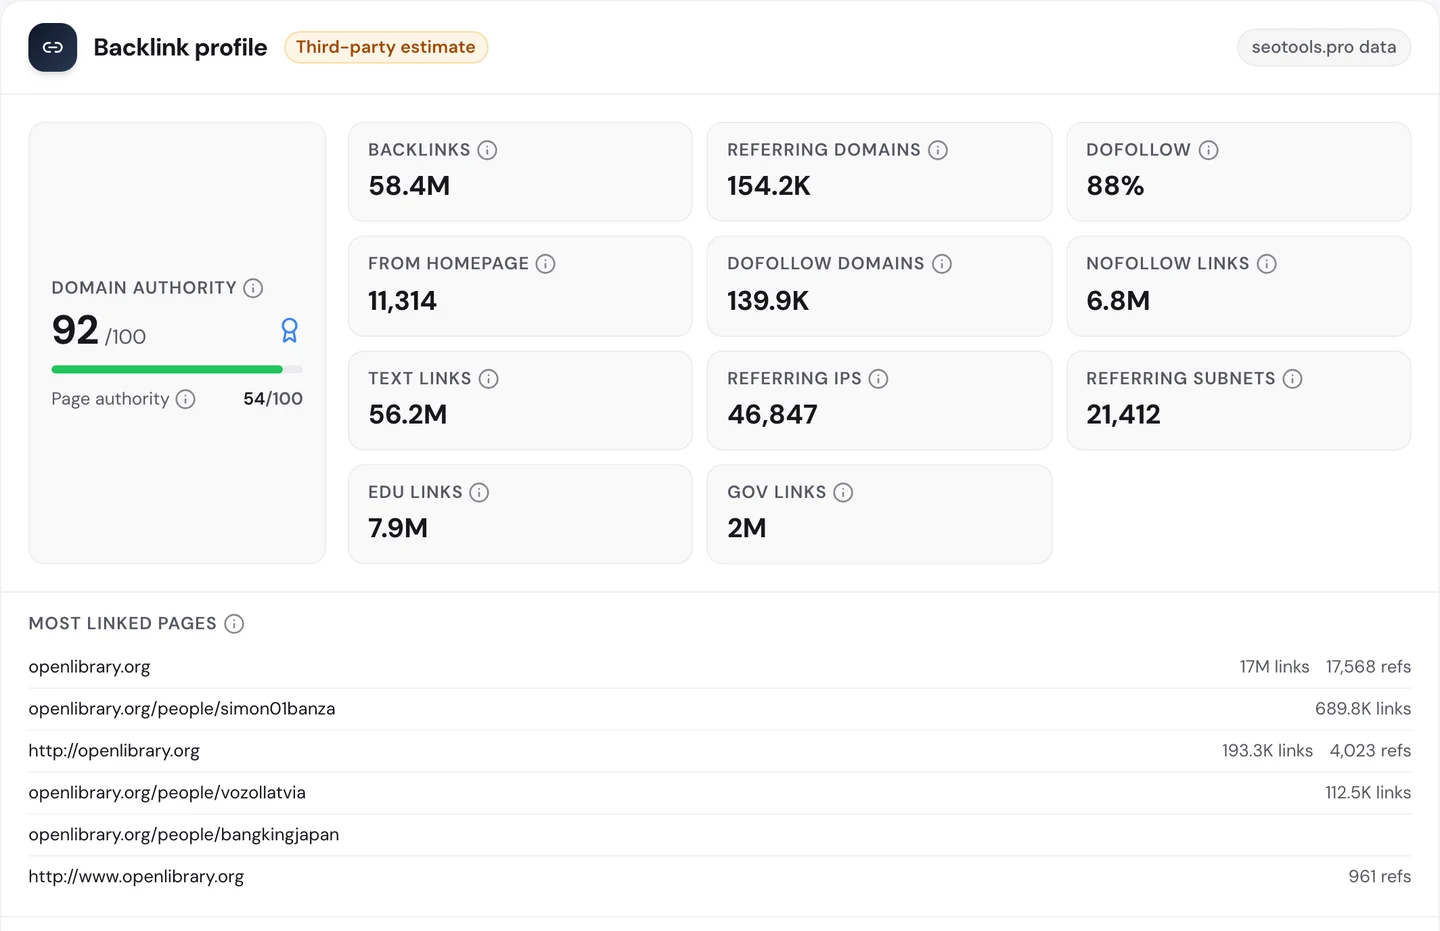
На Open Library ведут около 58 млн ссылок примерно со 154 тыс. ссылающихся доменов, то есть сайтов, которые на нее ссылаются. Ее Domain Authority, наша оценка силы ссылок сайта по шкале от 0 до 100, равен 92.
Теперь посмотрите на блок EDU links. Около 7,9 млн ссылок ведут с сайтов .edu, а такие адреса используют школы и колледжи США.
Еще 2 млн ведут с государственных сайтов, и для бесплатной библиотеки это логично. Такие ссылки трудно заполучить, если вам самим еще не доверяют.
Одно стоит держать на заметке. Сразу после главной среди страниц с самым большим числом ссылок идут несколько профилей участников.
У Docker Hub, который мы тоже разбирали, в начале списка оказались профили, похожие на спам. Если ваш список возглавляет незнакомый профиль, обязательно на него посмотрите.
Так что найдите людей, которые охотно отправят к вам своих читателей. Для библиотеки это учителя. А потом отслеживайте каждую новую ссылку в нашем инструменте «Анализатор обратных ссылок».
Ищите запросы почти на 1-й странице
С таким количеством ссылок Open Library должна стоять в Google высоко. Наш Обзор домена показывает, как обстоят дела на самом деле.
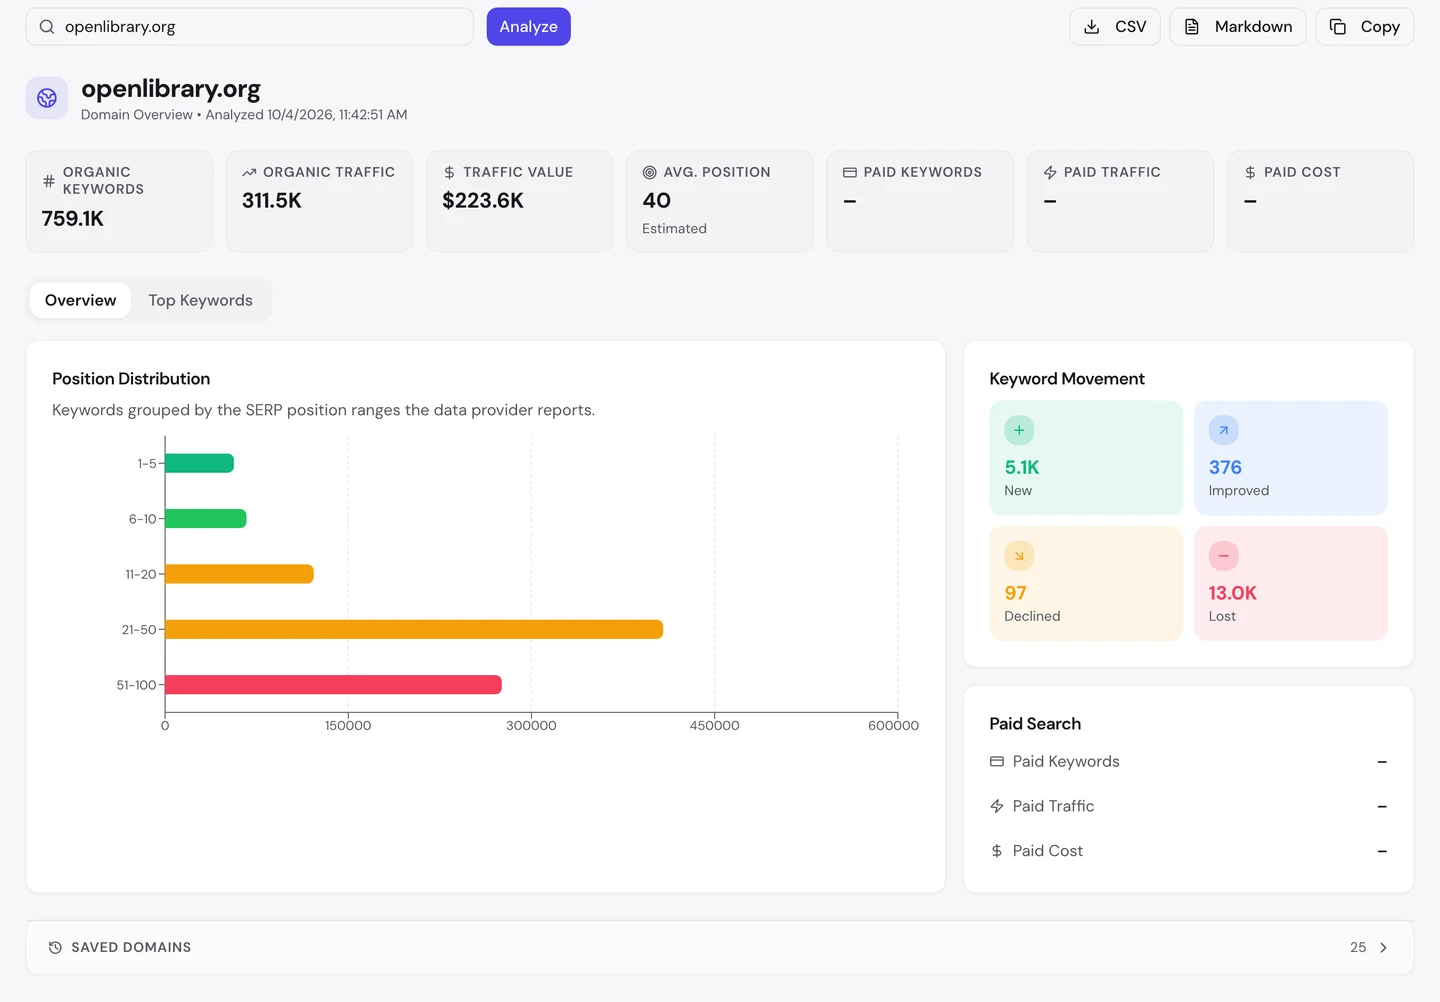
Open Library попадает в выдачу примерно по 760 тыс. запросов. Ценность ее трафика, то есть сколько стоили бы эти посещения в рекламе Google, около 224 тыс. $ в месяц.
Но ее средняя позиция 40, а это 4-я страница Google. Самый длинный столбец на графике у мест с 21 по 50.
Стоит взглянуть и на блок с динамикой. Сайт получил около 5 тыс. новых ключевых слов и потерял около 13 тыс.
Если нужны быстрые победы, смотрите на то, что чуть-чуть не дотянуло до 1-й страницы. Вкладка Keywords в аудите насчитывает около 122 тыс. позиций с 11-го по 20-е место.
Часть этих запросов забирают конкуренты. Кто именно, показывает вкладка Competitors (конкуренты) в аудите.
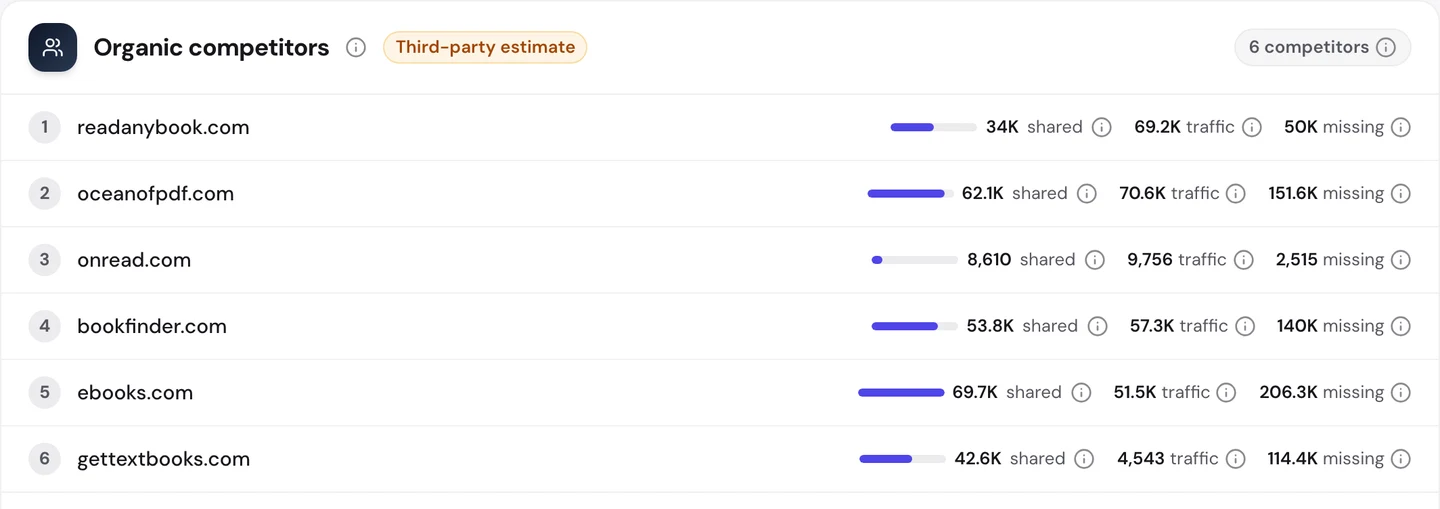
Большинство конкурентов оказались сайтами с бесплатными электронными книгами. У Bookfinder.com около 54 тыс. общих запросов с Open Library.
У Ebooks.com около 70 тыс. А еще он попадает в выдачу примерно по 206 тыс. запросов, по которым Open Library не видно.
Столбец «missing» (недостающие) можно сразу брать как готовый список задач. В нем виден каждый запрос, который забирает конкурент, и можно решить, нужна ли вам под него страница.
Так что найдите свои запросы на местах с 11-го по 20-е и в первую очередь улучшите эти страницы. Изучите конкурентов в нашем инструменте «Анализ конкурентов», а потом следите в нашем Rank Tracker, как ваши страницы поднимаются.
Сделайте аудит глазами Google
Расширение проверяет по одной странице за раз. А наш Website Audit проверяет сразу сотни, так что видно, какие проблемы повторяются.
Он проверил 332 страницы, и Open Library набрала 80 баллов из 100. Отчет оценивает это как «хорошо».
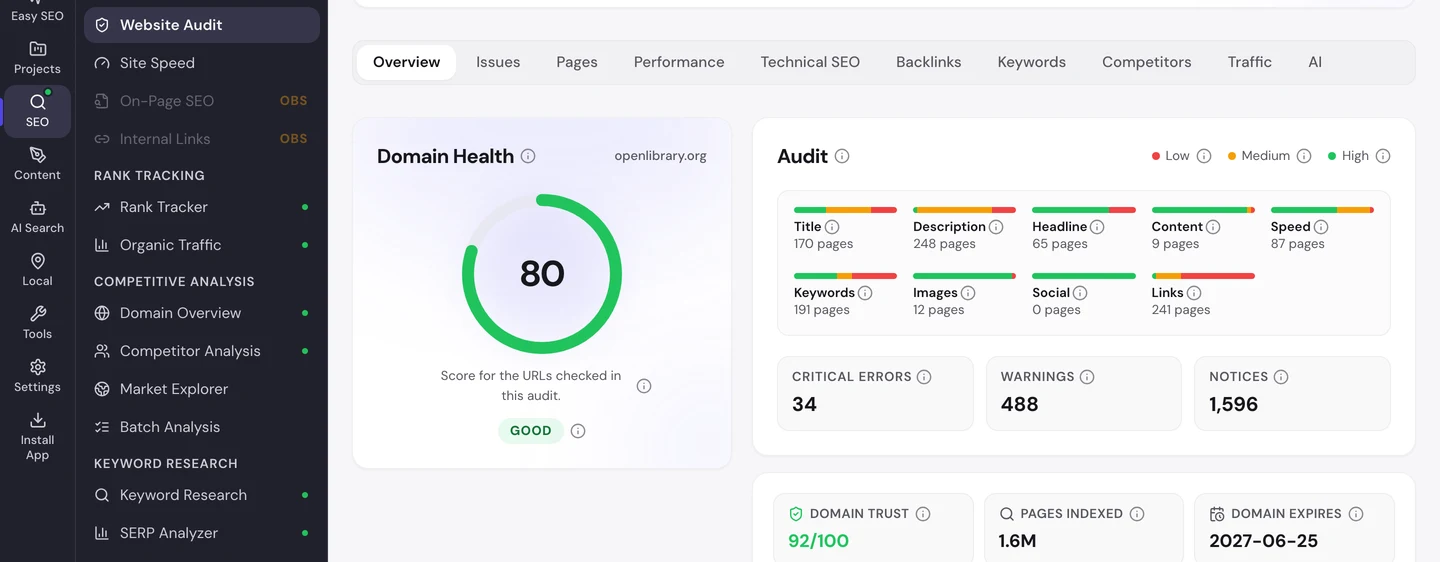
Вкладка Issues (проблемы) сортирует проблемы по тому, насколько они важны для вас.
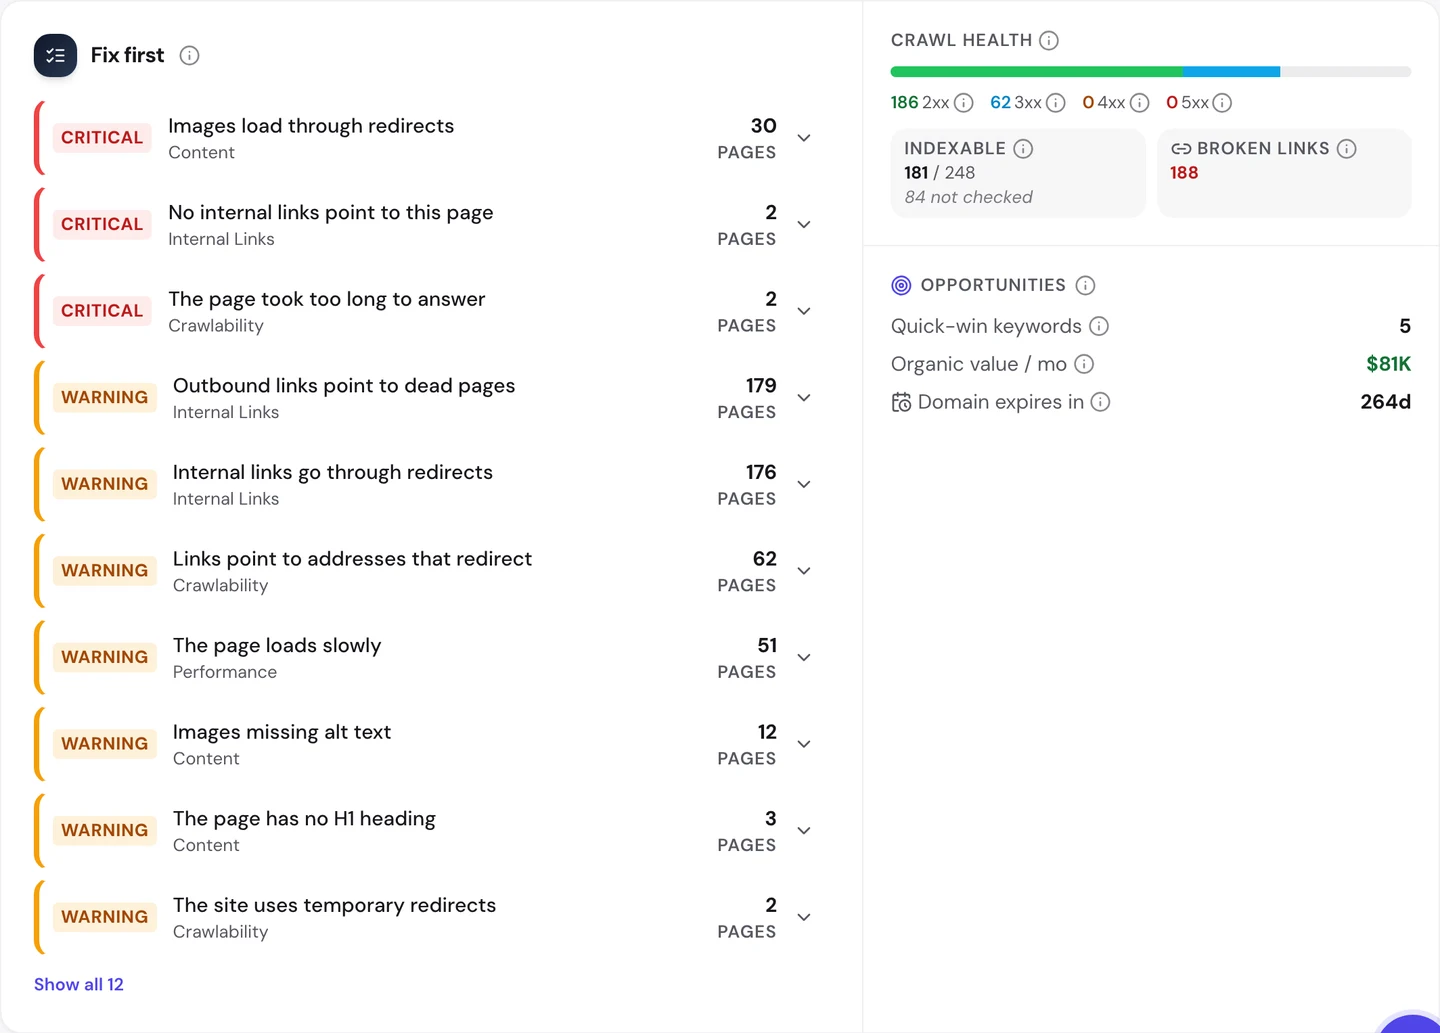
Главная ошибка: изображения загружаются через редиректы. Адрес картинки ведет на старое место, а оттуда ее перенаправляют дальше, так что каждое изображение делает лишний круг.
На 2 страницы вообще не ведет ни одна ссылка. А еще 2 отвечали слишком долго.
Большинство предупреждений касается ссылок. Около 180 страниц ссылаются на нерабочие страницы, а примерно у 175 собственные ссылки ведут через редиректы.
Вкладка Technical SEO (техническое SEO) показывает, какие страницы Google может проиндексировать.
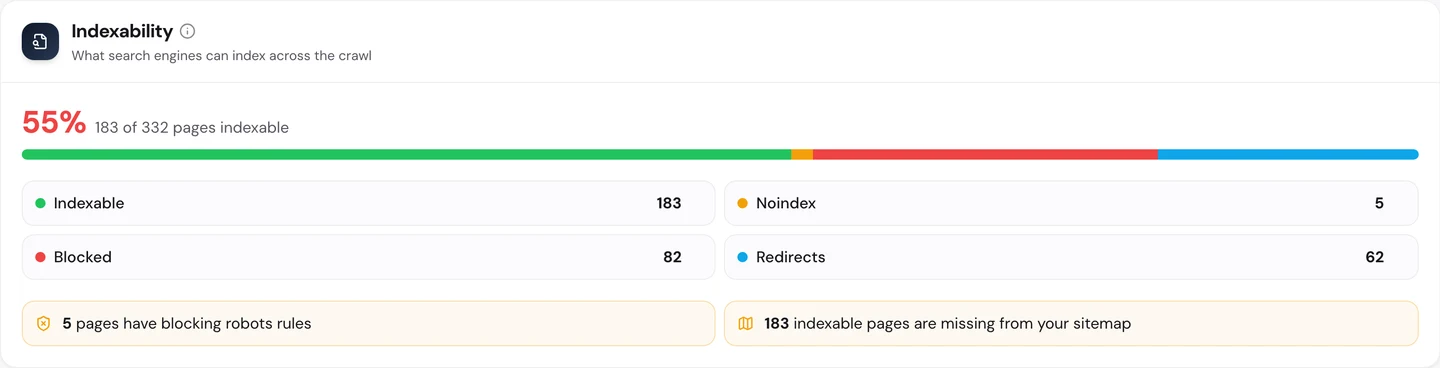
Google может проиндексировать только 55% проверенных нами страниц. Правила robots блокируют 82 из них, а 62 оказались редиректами.
Отчасти это сделано специально. И все же стоит убедиться, что каждое правило блокирует только то, что вы задумали.
Дальше идет карта сайта, то есть файл, в котором перечислены страницы сайта для Google. Ни одной из 183 страниц, которые Google может проиндексировать, в карте сайта нет, а расширение вообще не нашло карту сайта по привычным адресам.
Сайту с миллионами книг карта сайта нужна больше, чем многим другим. Она помогает Google находить глубокие страницы, на которые ведет мало ссылок.
Ломать голову, что исправлять первым, вам не придется. Вкладка AI (ИИ) в аудите составляет план: короткую сводку, разбор каждой проблемы с советом, как ее исправить, и список задач на 90 дней.
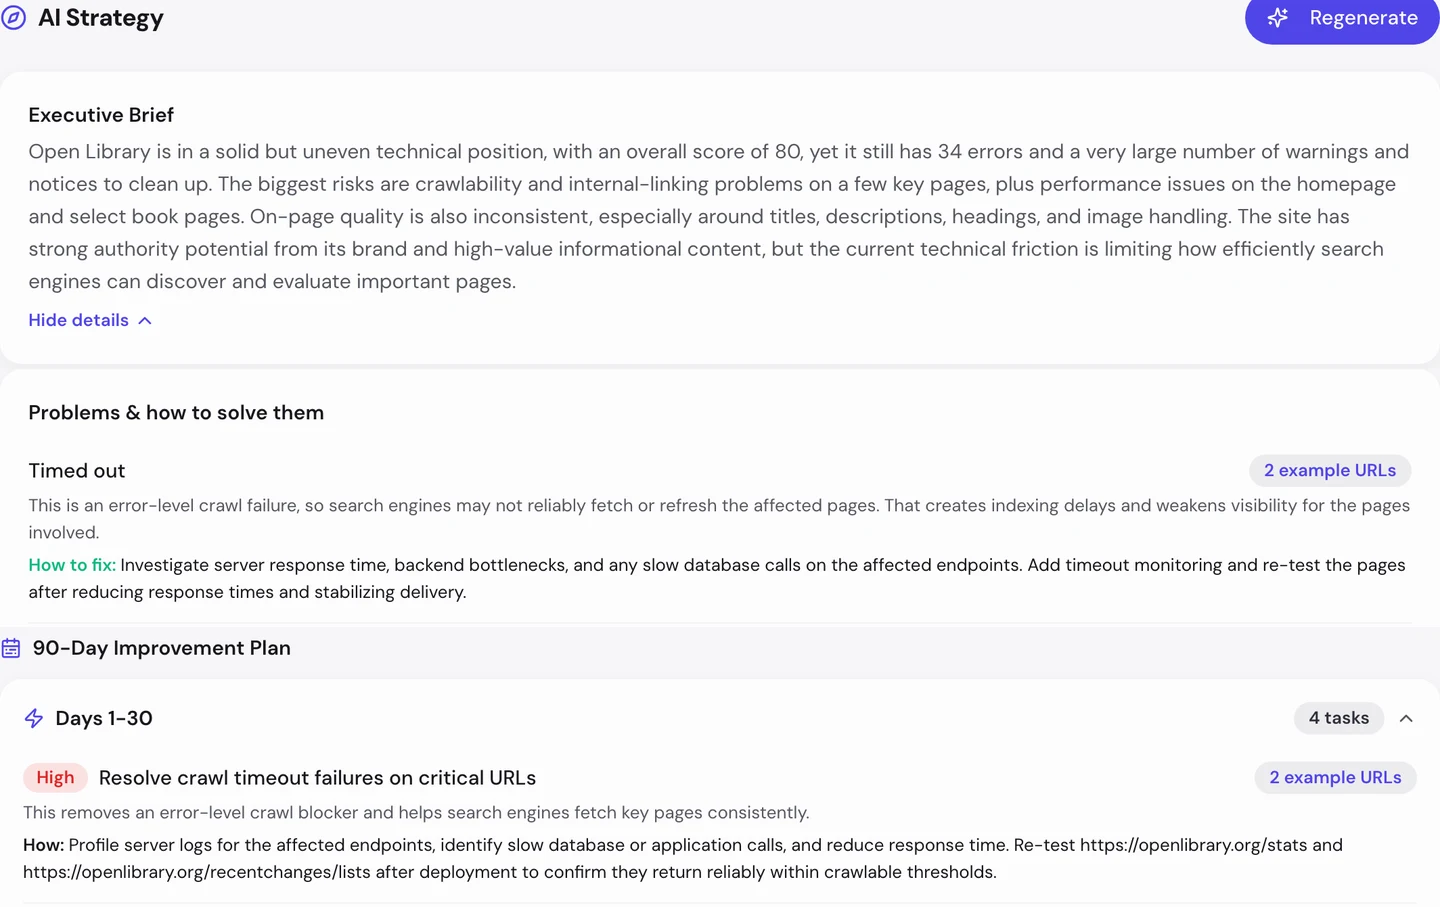
Для Open Library первый месяц начинается с 2 страниц, которые не успевают ответить. Потом идут изображения с редиректами и страницы, на которые не ведут ссылки.
Так что сканируйте свой сайт так, как это делает Google, и исправляйте проблемы, которые тиражирует шаблон. Запустите наш Аудит сайта, и вы увидите, какие исправления помогут сразу сотням страниц.
Ускорьте страницы на телефонах
И напоследок скорость. Когда мы открыли главную, ряды книг на ней еще загружались.
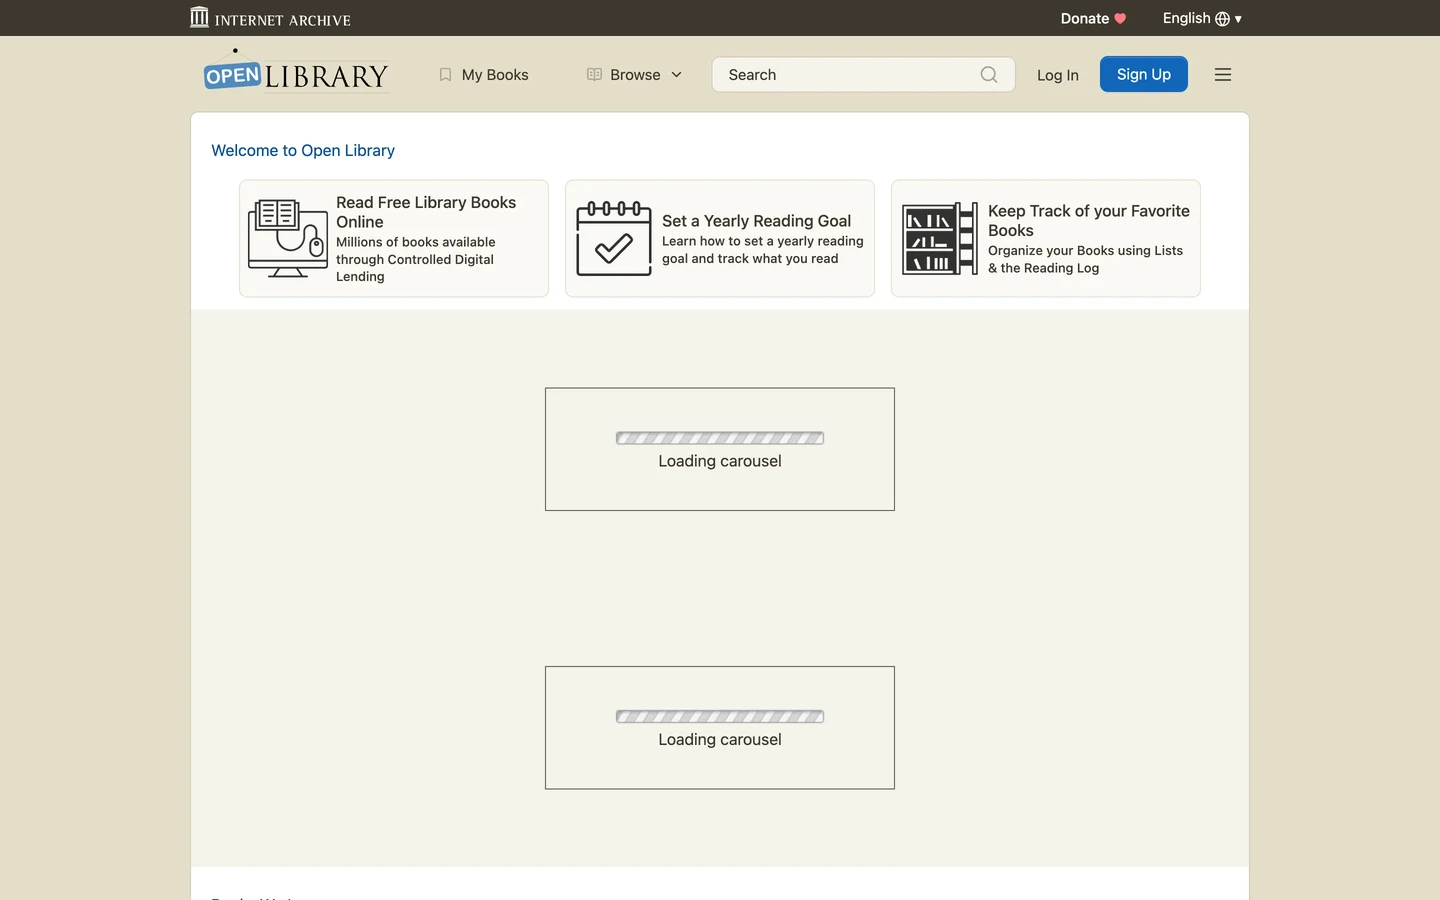
В каждом блоке было написано «Loading carousel». Каруселью называют ряд обложек, который можно прокручивать. Через мгновение эти ряды заполнились.
Вкладка Performance (производительность) в аудите показывает Core Web Vitals. Это 3 проверки Google: как быстро страница загружается, как быстро она реагирует на действия и не прыгает ли содержимое. Измеряют их на устройствах реальных посетителей.
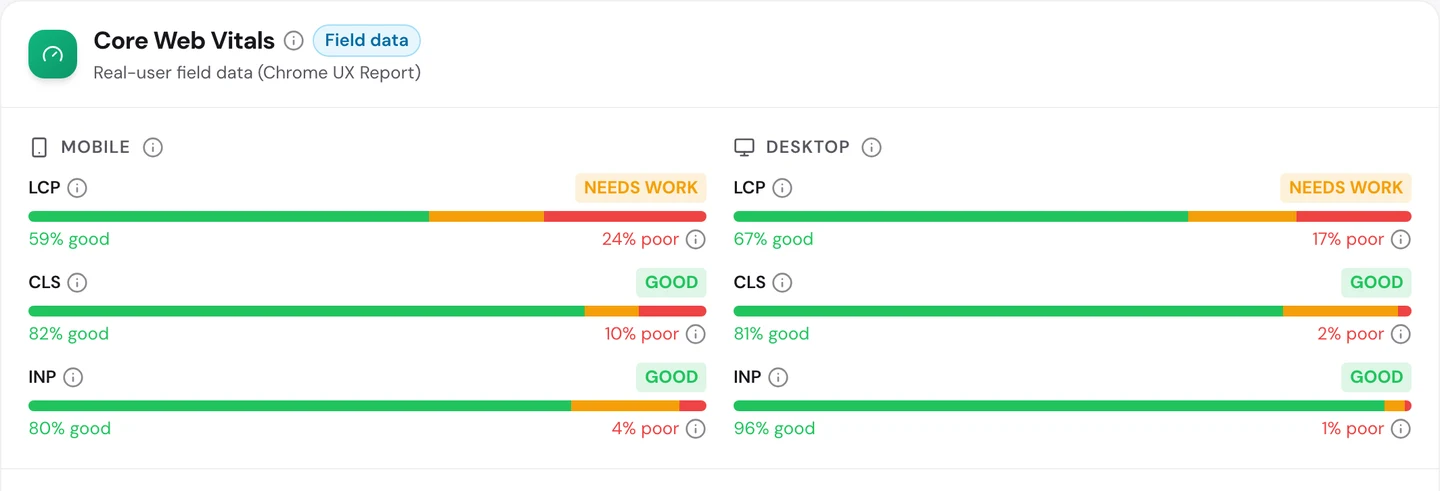
Open Library проходит 4 из 6 проверок. Страницы у нее быстро реагируют и не прыгают как на телефонах, так и на компьютерах.
Слабое место в загрузке, а именно ее вы замечаете в первую очередь. На телефонах основной контент быстро появляется только примерно в 3 из 5 посещений.
Примерно в 1 из 4 посещений с телефона приходится ждать слишком долго. На главной аудит винит в этом несжатые скрипты и медленный ответ сервера.
Так что тестируйте самые посещаемые страницы на телефоне и загружайте основной контент раньше всего остального. Наш инструмент Site Speed покажет, что тормозит каждую страницу.
Google может проиндексировать только 55% страниц Open Library, которые мы просканировали. Наш Website Audit показывает, какие ваши страницы заблокированы, перенаправлены или отсутствуют в карте сайта, и что исправить в первую очередь.
- Тот же аудит, который мы провели для Open Library
- Индексация, редиректы и битые ссылки в одном месте
- ИИ-план, который выстраивает исправления по порядку
Что повторить не получится
Сначала о том, чего не скопировать: Open Library управляет некоммерческая организация Internet Archive. Ее домен существует с 2001 года.
На нее ведут миллионы ссылок со школьных и государственных сайтов. Это годы доверия, а доверие не купишь.
Теперь несколько честных замечаний о цифрах.
Все цифры актуальны на 4 октября 2026 года. Цифра 312 тыс. учитывает только поиск в США и только openlibrary.org.
Мировая оценка 790 тыс. взята из вкладки Traffic в аудите. Все эти цифры приблизительные, ведь никто, кроме самой Open Library, не знает точного числа посещений.
Инструменты рассчитывают эти цифры по позициям в выдаче и частоте запросов.
Наш тестовый браузер уперся в проверку на ботов на странице книги. Поэтому на скриншотах расширения с этой страницы видна проверка, а не книга.
В тесте с user agent мы меняли только имя, которое отправляли. Запросов с серверов самого Google мы не делали, а к ним сайт может относиться по-своему.
Мы просканировали 332 страницы, а для такого огромного сайта это лишь небольшая выборка. Поэтому мы искали по ней повторяющиеся проблемы, а не считали каждую ошибку.
Одно число, которое стоит запомнить
55%.
Такую долю просканированных нами страниц Open Library может проиндексировать Google. Остальные заблокированы, перенаправлены или специально закрыты от индекса.
И все же Open Library привлекает около 312 тыс. посетителей в месяц из США, и почти половина из них приходит через одну сильную главную страницу.
В этом и урок для любого крупного сайта. Важно не только то, что вы публикуете, но и то, до чего может добраться Google и что он там видит.
Что видит Google, когда открывает ваши страницы? Проверьте их так, как это сделал бы Google.
Любую из этих проверок можно запустить для своего сайта и сайтов конкурентов, чтобы своими глазами увидеть такие же цифры.
Частые вопросы
Навредит ли проверка на ботов моим позициям?
Нет, если Google через нее проходит. Проверьте ключевые страницы под именем Googlebot и под видом обычного посетителя, а потом убедитесь, что Google получает настоящую страницу.
Как понять, что бот действительно Googlebot?
Назваться Googlebot может любая программа. Google объясняет, как отличить его краулера по адресу, с которого он приходит. Тогда ваша проверка на ботов сможет пропускать настоящего Googlebot и отсекать подделки.
Не клоакинг ли пускать Google в обход проверки?
Клоакингом называют ситуацию, когда Google показывают не то, что видят люди. Если после проверки люди получают ту же страницу, значит, вы всем показываете одно и то же.
Стоит ли блокировать ИИ-краулеров?
Зависит от ваших целей. Если хотите, чтобы ИИ-инструменты цитировали вас и ссылались на вас, пускайте их. Если вы продаете контент, который они могут скопировать, часть из них можно заблокировать.
Какой заголовок дать странице с множеством изданий?
Используйте название, которое чаще всего ищут, на языке самой страницы. Другие названия упомяните ниже, чтобы страницу находили и по ним.
Нужна ли карта сайта, если Google и так находит мои страницы?
Крупным сайтам нужна. Карта сайта помогает Google находить глубокие страницы, на которые ведет мало ссылок, и сообщает ему, когда страницы меняются.
Как быстрее всего ускорить главную страницу?
Сначала загружайте основной текст и первые изображения, а остальное придержите. Сжимайте скрипты и убирайте те, которыми не пользуетесь.
Как часто крупному каталогу проводить аудит?
Для начала хватит раза в месяц. А еще запускайте его после каждого крупного изменения шаблона, ведь одна правка может затронуть тысячи страниц.