Кожен перевірений нами видавець блокує ШІ-краулерів у своєму robots.txt, а з 41 софтверної компанії хоча б одного блокують лише 5.
Невеликий файл robots.txt підказує краулерам, тобто програмам, що відвідують сайти, які сторінки їм можна читати. Ми прочитали цей файл на 57 великих сайтах і шукали в ньому імена 18 ШІ-краулерів.
Різниця очевидна. Видавці продають свої тексти, тож тримають їх під замком.
Софтверні компанії хочуть, щоб інструменти ШІ їх рекомендували, тож лишають двері відчиненими.
Нижче 8 уроків, які можна перейняти, і те, чого повторити не вийде.
Ставтеся до текстів як до товару
Почнімо із загальної картини. Сайт блокує краулера, коли файл сайту забороняє йому заходити на будь-яку сторінку.
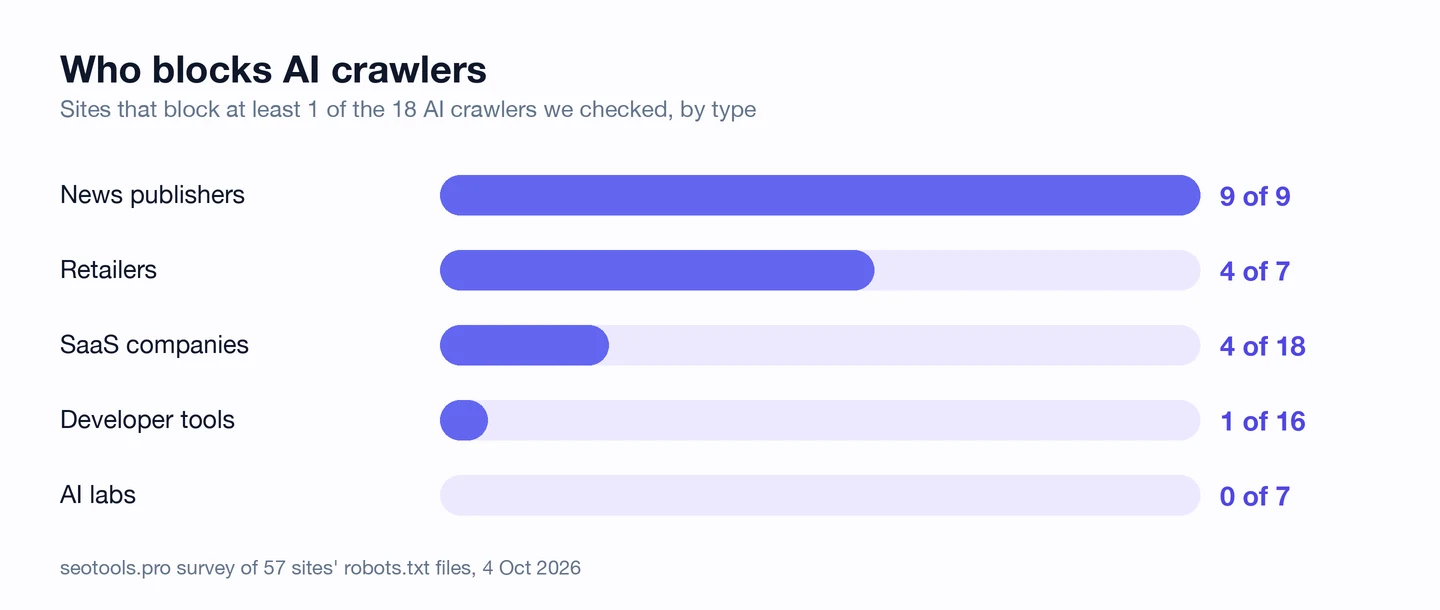
Усі 9 видавців блокують хоча б одного ШІ-краулера. The New York Times, CNN і wikiHow блокують по 17 із 18, яких ми шукали.
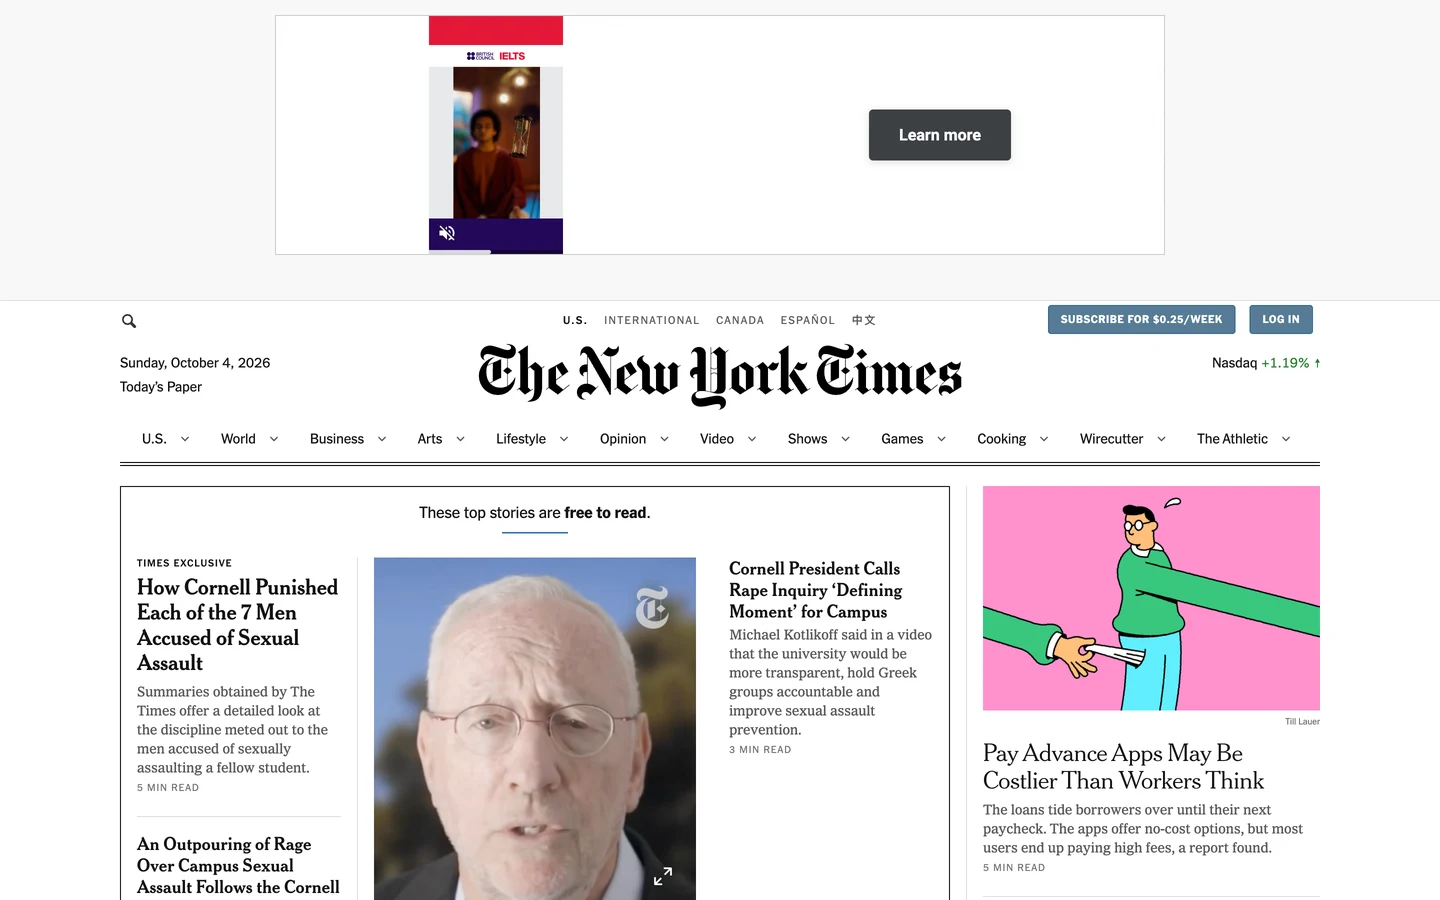
Ось що вони захищають. NYT продає свою журналістику, а на головній сторінці позначено найважливіші матеріали, які можна читати безкоштовно.
Його robots.txt починається з примітки простою англійською. У ній сказано, що без письмового дозволу статті не можна використовувати для створення ШІ чи великих мовних моделей.
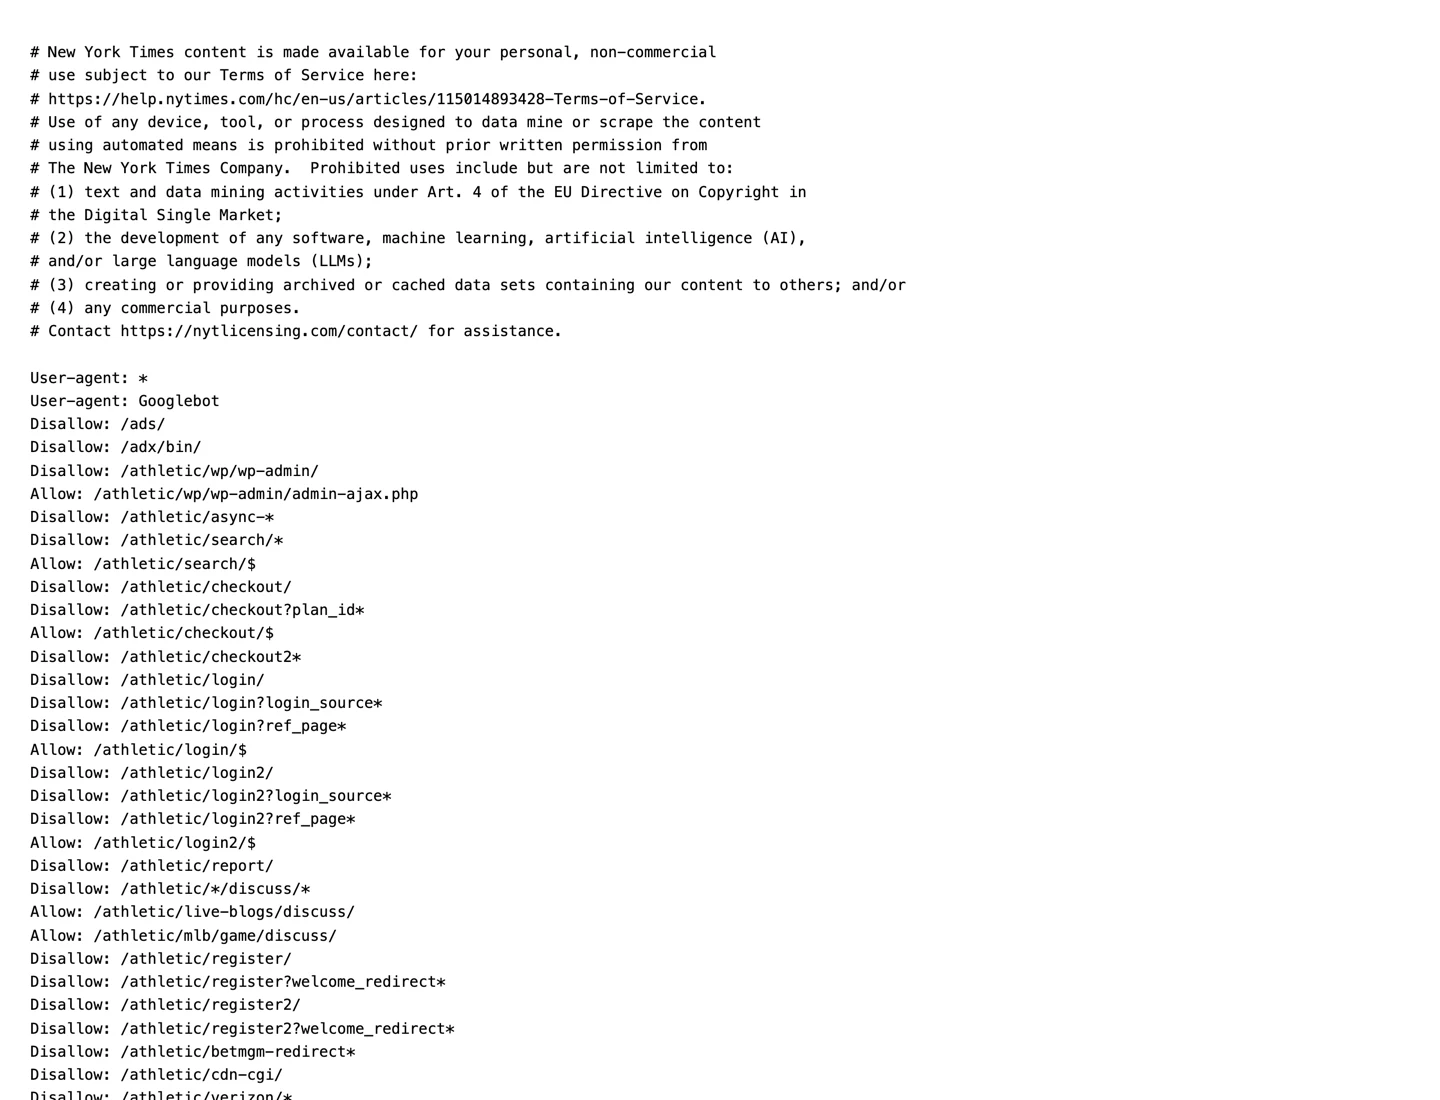
Наприкінці примітки вказано контакт для ліцензування. Інакше кажучи, тексти продаються.
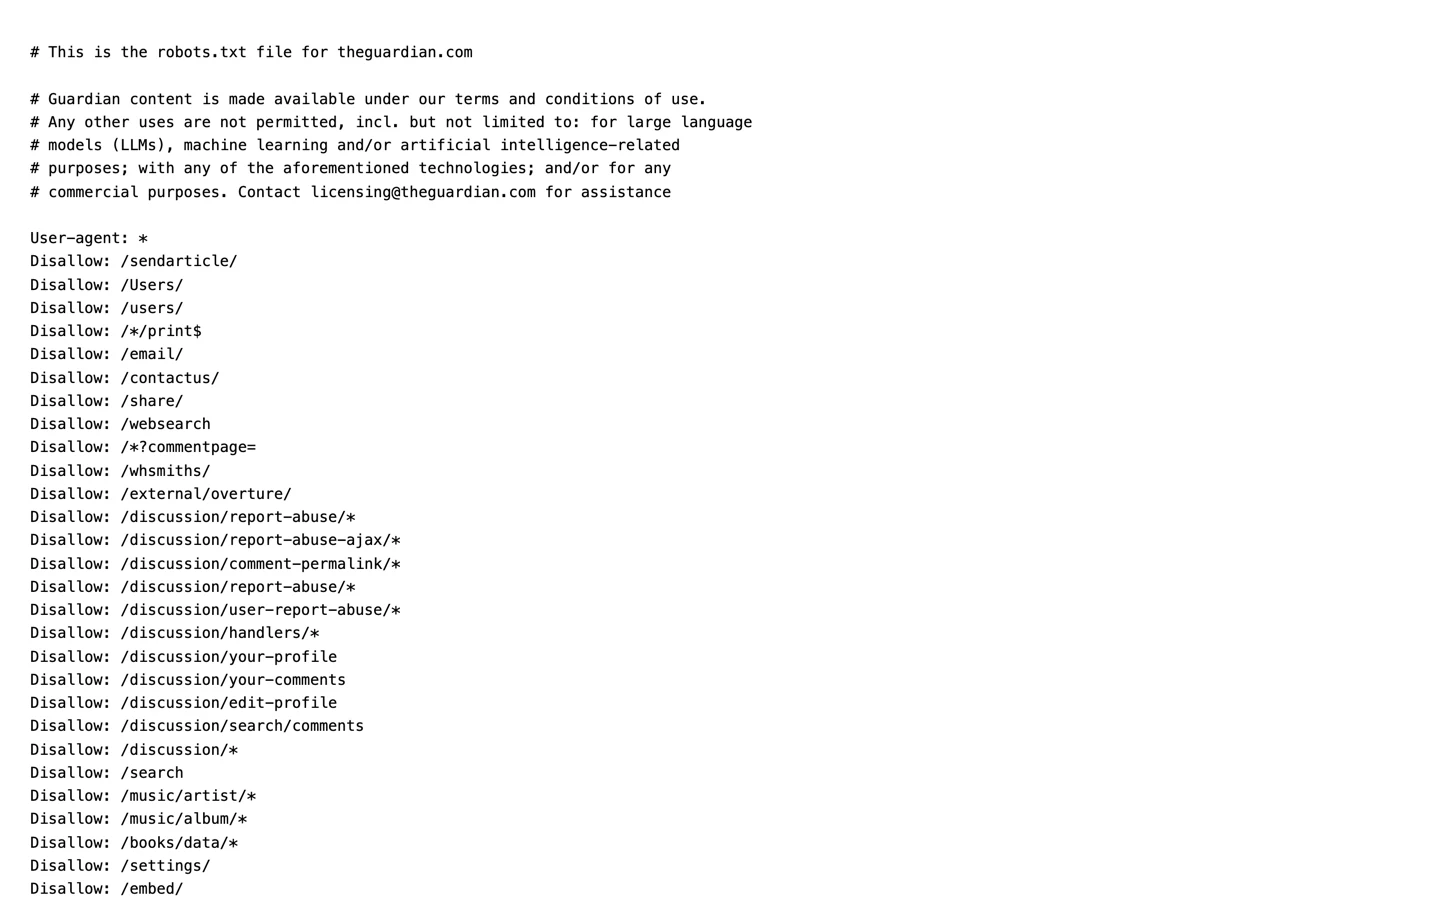
У файлі The Guardian написано майже те саме. ШІ та великі мовні моделі там прямо названо серед заборонених способів використання.
wikiHow, який ми теж розбирали, блокує 17 ШІ-краулерів. Healthline, ще один сайт, який ми детально вивчили, блокує 11.
Тож якщо ви продаєте саме тексти, не пускайте ШІ-краулерів, які їх копіюють. Наш генератор robots.txt сам напише для вас ці правила.
Дайте ШІ прочитати, що ви продаєте
Софтверні компанії роблять протилежний вибір. З 41 перевіреної нами компанії хоч якогось ШІ-краулера блокують лише 5.
Їхні сторінки не продають тексти. Компанії продають продукт, а сторінки його рекламують.
Подивіться, наприклад, на головну сторінку Stripe. Коли хтось питає в інструмента ШІ, як приймати оплату онлайн, Stripe хоче потрапити у відповідь.
Наше безкоштовне розширення для браузера показує, що дозволяє robots.txt сайту. Відкрийте будь-яку сторінку, натисніть значок seotools.pro і прокрутіть до розділу «AI search readiness».
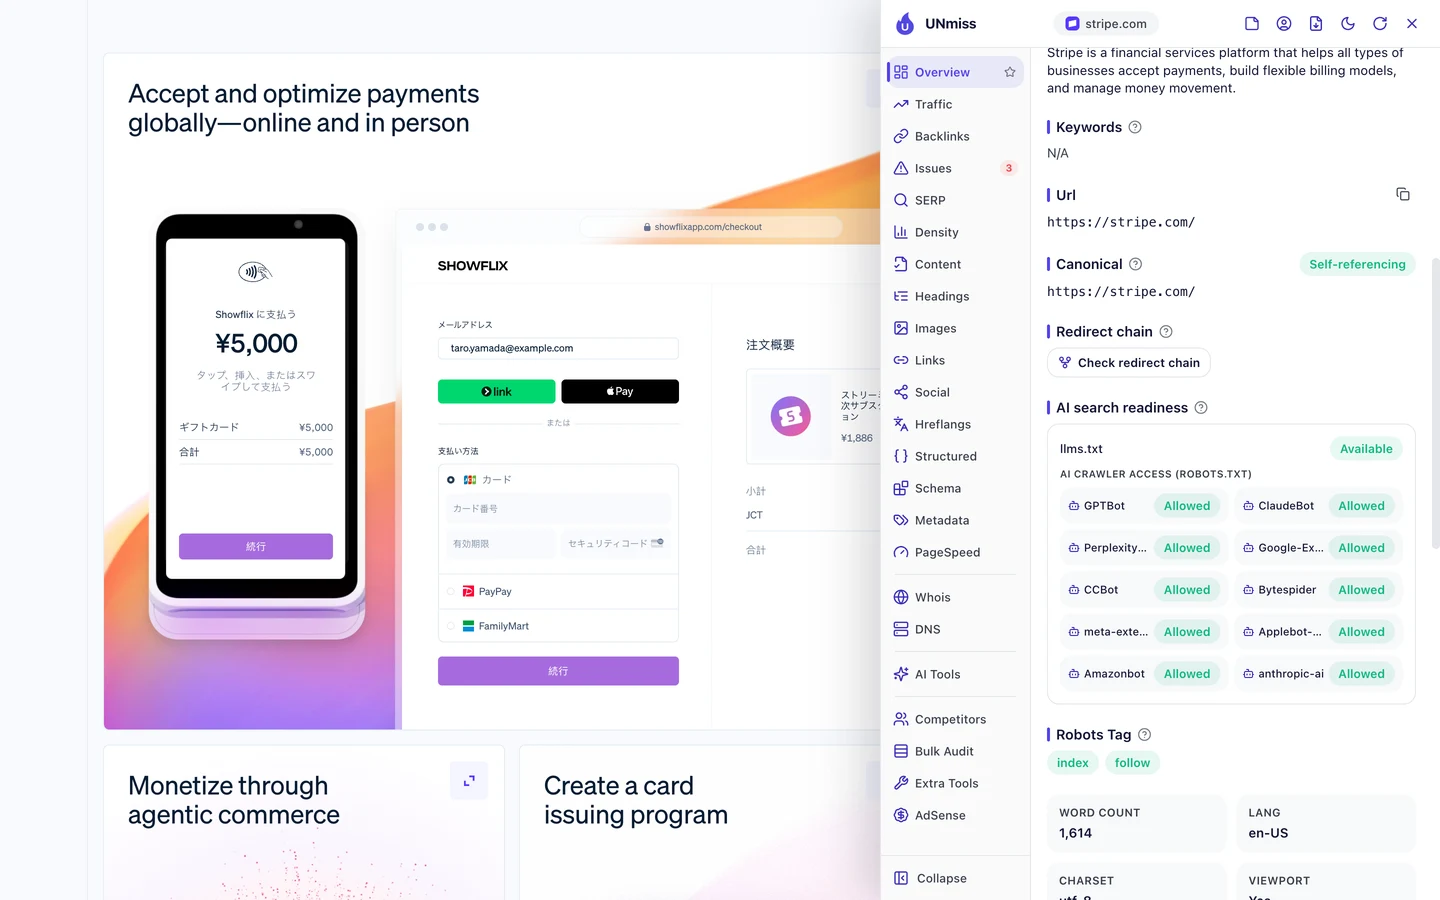
Stripe пускає всіх 10 краулерів, яких показує панель. А ще в нього є llms.txt, короткий файл, який пояснює інструментам ШІ, про що сайт.
Навіть ШІ-лабораторії, тобто компанії, які створюють цих ботів, не блокують жодного. GitHub блокує лише одного, Bytespider.
Винятками стали Figma і Canva, яку ми теж розбирали. Обидві блокують по 11.
Але те, що ШІ може вас прочитати, ще не означає, що він дасть на вас посилання. Наше дослідження цитувань у ШІ показало, що ці інструменти часто називають бренд, але не дають на нього посилання, а в дослідженні llms.txt ми з’ясували, у кого є цей файл-путівник.
Тож якщо ваші сторінки продають продукт, пускайте до них інструменти ШІ. А потім перевірте в нашому інструменті «Перевірка видимості в ШІ», чи справді вони вас згадують.
Блокуйте навчання, а не відповіді
Не всі ШІ-краулери роблять одне й те саме. Одні збирають сторінки для навчання, тобто передають їх ШІ, щоб він на них учився.
Інші відкривають сторінку, щоб відповісти на запитання тут і зараз. Такі боти можуть назвати вас, дати посилання і привести до вас відвідувачів.
Наш генератор robots.txt показує кожного ШІ-краулера, компанію, якій він належить, і те, що він, за її словами, робить.
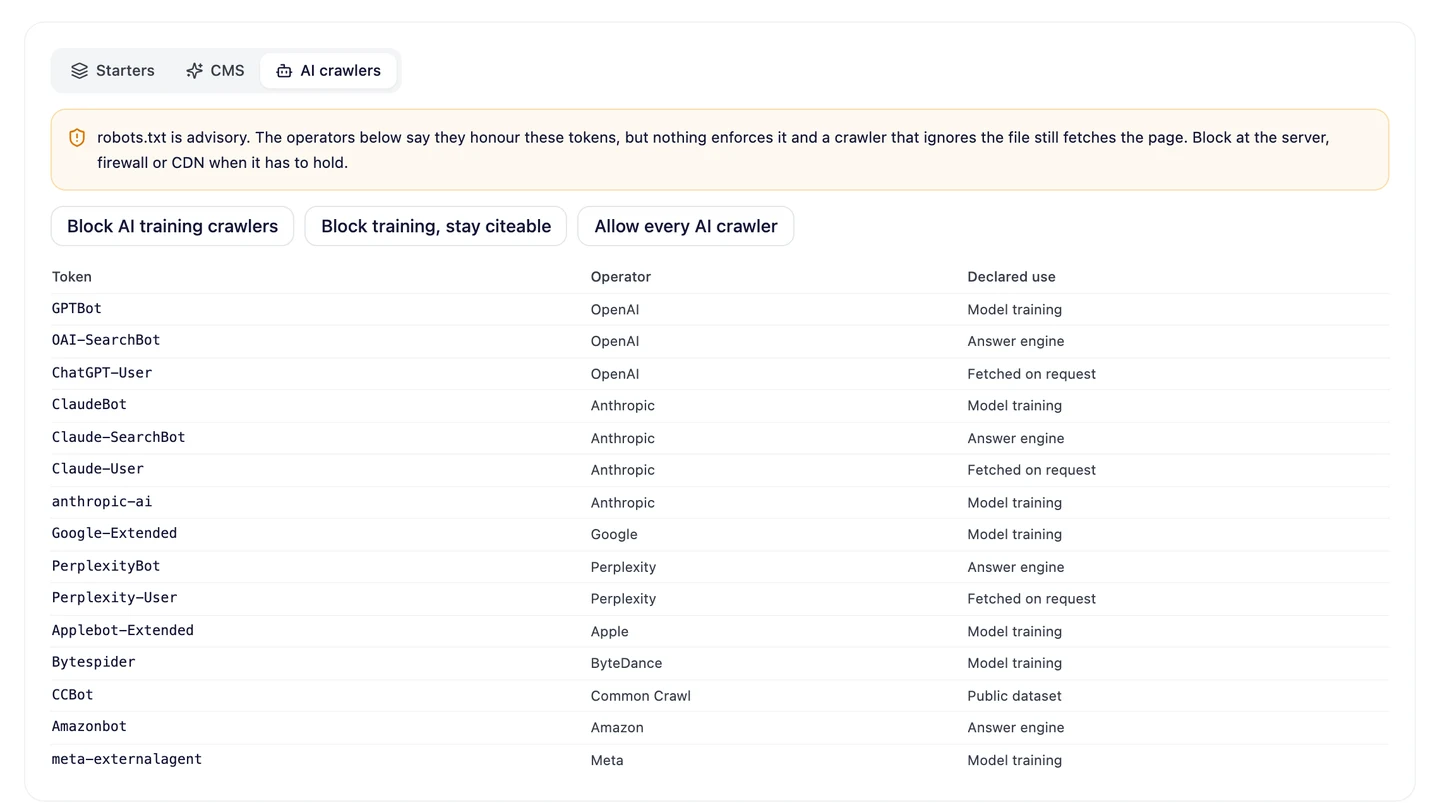
Візьмімо OpenAI. GPTBot позначено як бота для навчання моделей, а OAI-SearchBot як бота для відповідей.
А сайти ставляться до цих 2 ботів зовсім по-різному. Ось скільки з 57 сайтів блокують кожного краулера.
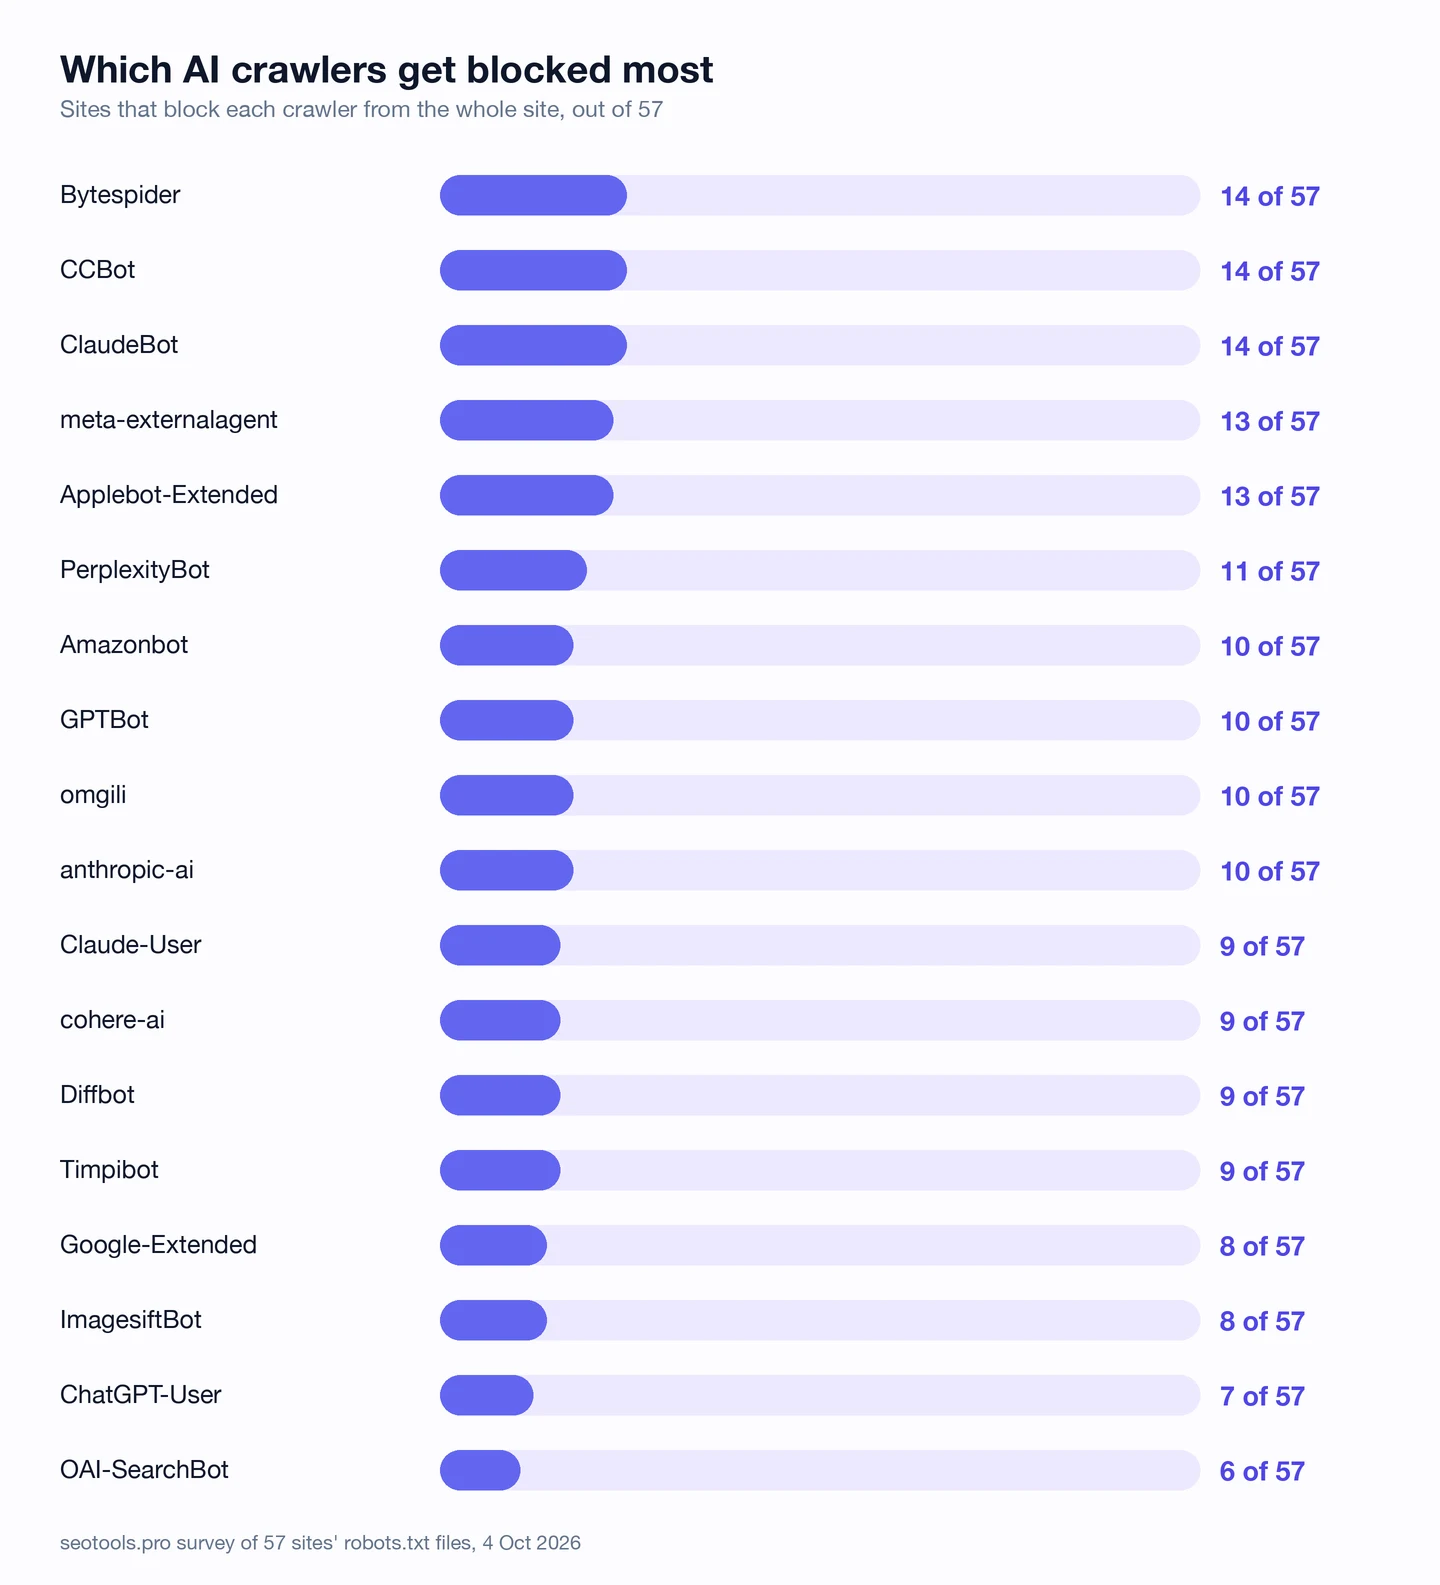
Найчастіше блокують ClaudeBot, CCBot і Bytespider, кожного на 14 сайтах. Усі 3 збирають сторінки для навчання або для відкритих наборів даних.
OAI-SearchBot блокують найрідше з усіх 18. Його не пускають лише 6 сайтів, тоді як GPTBot блокують 10.
Але це не залізне правило. PerplexityBot теж бот для відповідей, але його все одно блокують 11 сайтів.
Саме на цій ідеї в генераторі зібрано готовий набір правил «Block training, stay citeable». Вас цитують, коли інструмент ШІ називає вас і дає посилання на вашу сторінку.
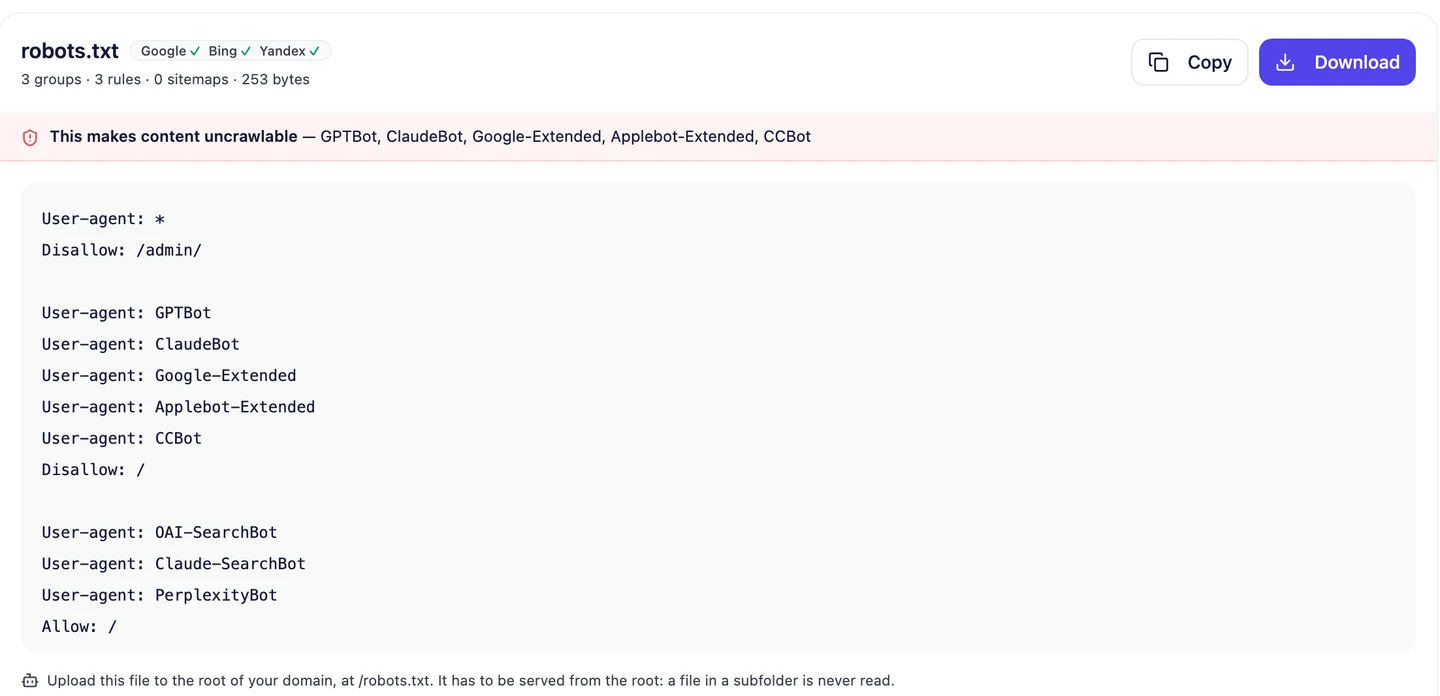
Він закриває весь сайт для 5 краулерів, серед них GPTBot і ClaudeBot, і пускає 3 боти для відповідей. Увесь файл складається лише з 3 коротких груп.
Тож за бажання не віддавайте свої сторінки на навчання, але дозвольте ботам для відповідей їх читати. Виберіть цей набір у нашому генераторі robots.txt і скопіюйте файл.
Видавці не пускають ШІ-краулерів, а софтверні компанії їх пускають. Ми визначимо, на чий бік варто стати вашому сайту, налаштуємо правила для кожного бота і подбаємо, щоб відповіді ШІ згадували вас і посилалися на ваш сайт.
- Перевіримо, яких ШІ-краулерів ваш сайт блокує зараз
- Напишемо правила, які не пускають ботів для навчання, а ботів для відповідей пускають
- Відстежимо, чи згадують вас інструменти ШІ і чи дають на вас посилання
- SEO і GEO, щоб вас знаходили і в Google, і у відповідях ШІ
Вирішуйте долю кожного бота окремо
Навіть видавці блокують не всіх ботів. Подивіться, скількох не пускає кожен із них.
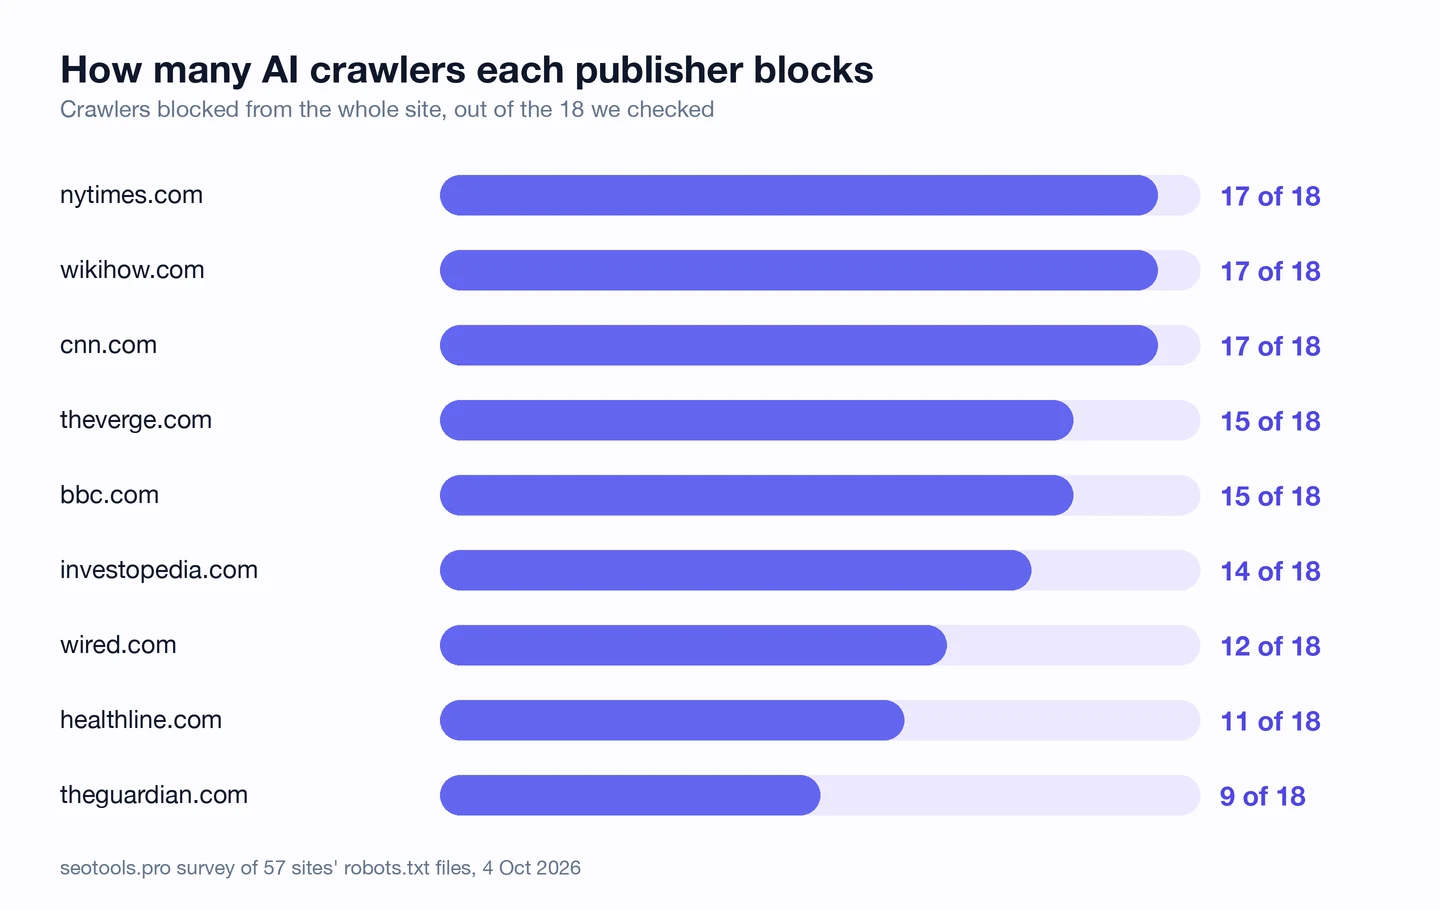
Перші 3 сайти блокують по 17 з 18. The Guardian блокує лише 9.
Схоже, ці прогалини залишено свідомо, а не через забудькуватість. Investopedia блокує 14, але не чіпає 3 краулерів OpenAI, хоча в її файлі названо всіх 3.
The Guardian блокує ботів Anthropic і Perplexity. А ботів OpenAI і Google не чіпає.
Причин ззовні не видно. Але видно, що кожен бот отримує своє окреме «так» чи «ні».
Ось як це робиться у файлі. User-agent — це ім’я, яким бот себе називає, і над одним правилом можна перелічити багато імен.
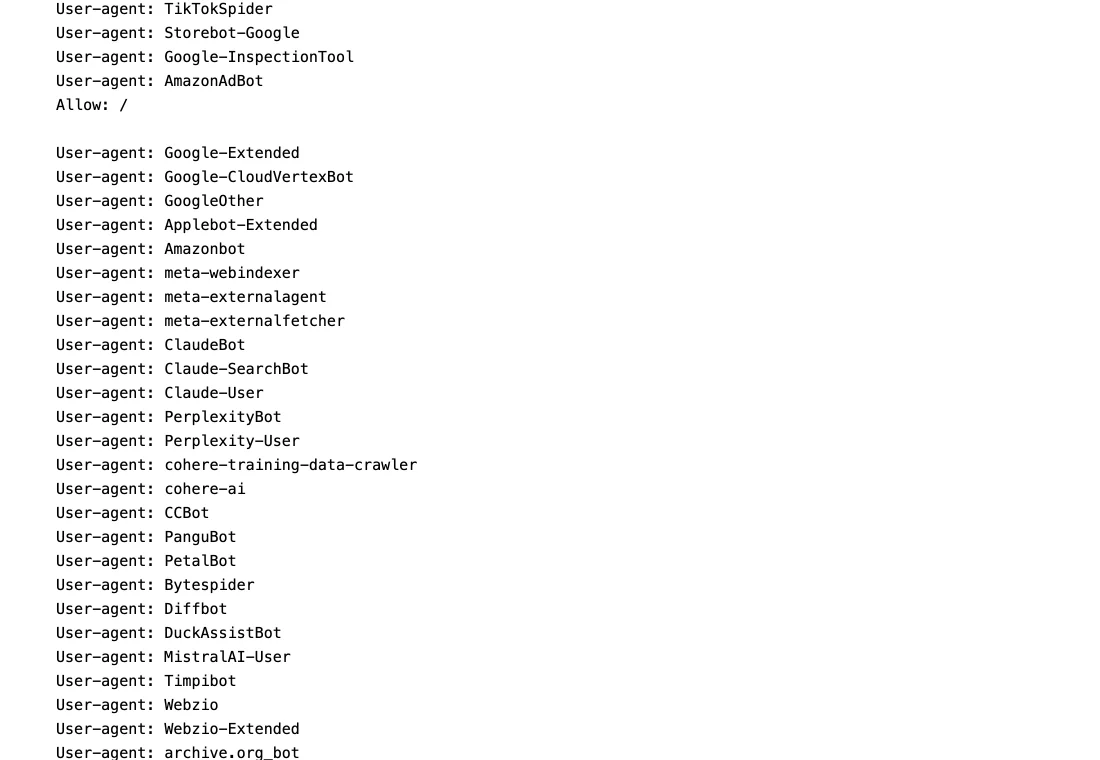
Wired зводить в одну групу цілий довгий список ШІ-краулерів. За нашими даними, він блокує 12 із 18, яких ми шукали.
Тож вирішуйте для кожного бота окремо, а не за принципом «все або нічого». Наш генератор robots.txt показує, що робить кожен бот, тож ви знатимете, кому саме кажете «ні».
Вирішіть, які товари бачить ШІ
Магазини опинилися десь посередині. З 7 перевірених рітейлерів 4 блокують хоча б одного ШІ-краулера.
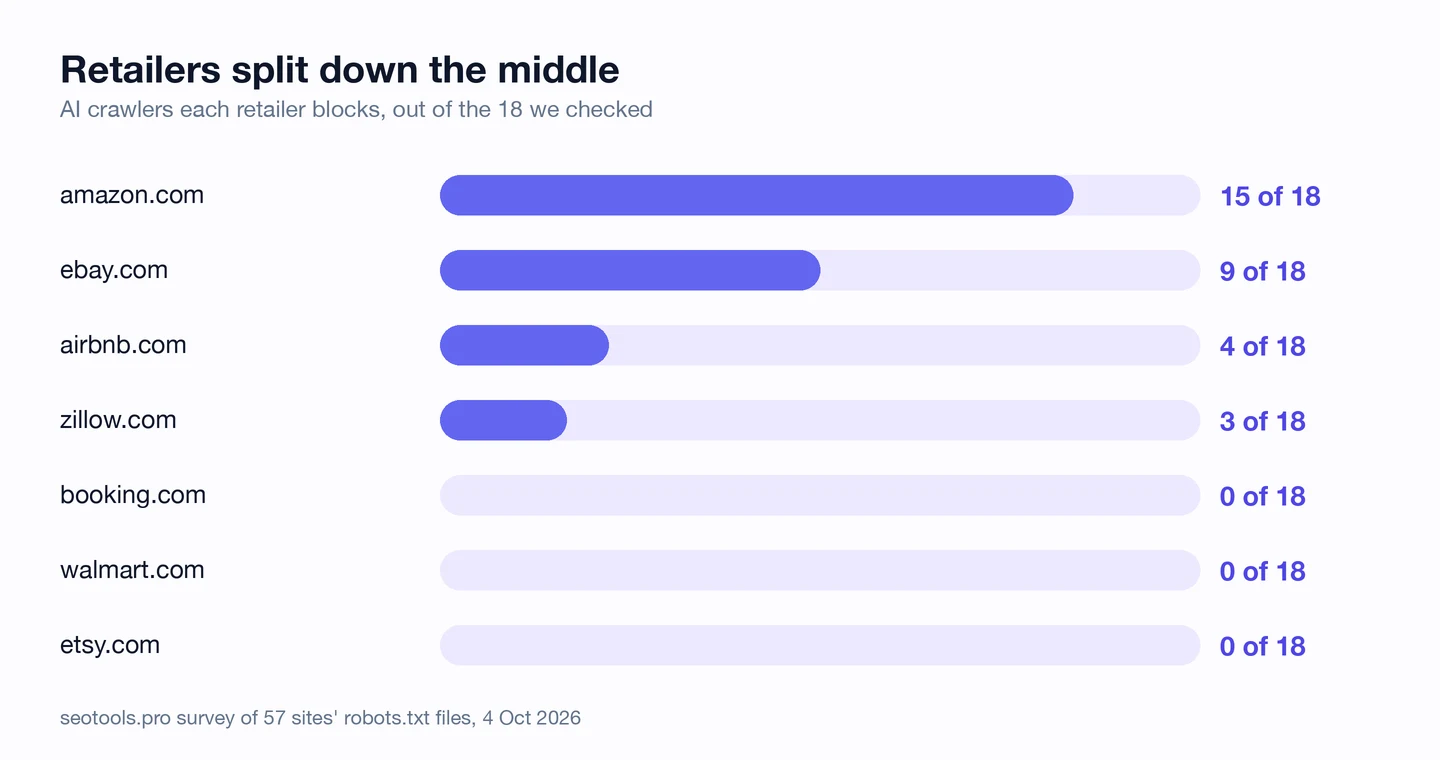
Amazon блокує 15 з 18. Але власного краулера, Amazonbot, не чіпає.
eBay блокує 9. Walmart, Etsy і Booking.com не блокують жодного.
Подумайте, що покупець запитує в інструмента ШІ, наприклад «який намет підійде новачкові?». Якщо ваші правила не пускають ботів для відповідей, ваших наметів у цій відповіді не буде.
В Amazon є власний краулер і величезний власний магазин, тож він може дозволити собі сказати «ні». А більшості магазинів потрібна кожна відповідь, у яку вони можуть потрапити.
Тож якщо ви щось продаєте, дозвольте ботам для відповідей читати сторінки товарів. А щоб вони знайшли кожен товар, створіть карту сайту, тобто файл зі списком усіх сторінок, у нашому «Генераторі XML Sitemap».
Не плутайте згадку з блокуванням
Ось пастка, у яку легко потрапити. У багатьох файлах ШІ-краулерів названо, але зовсім не заблоковано.
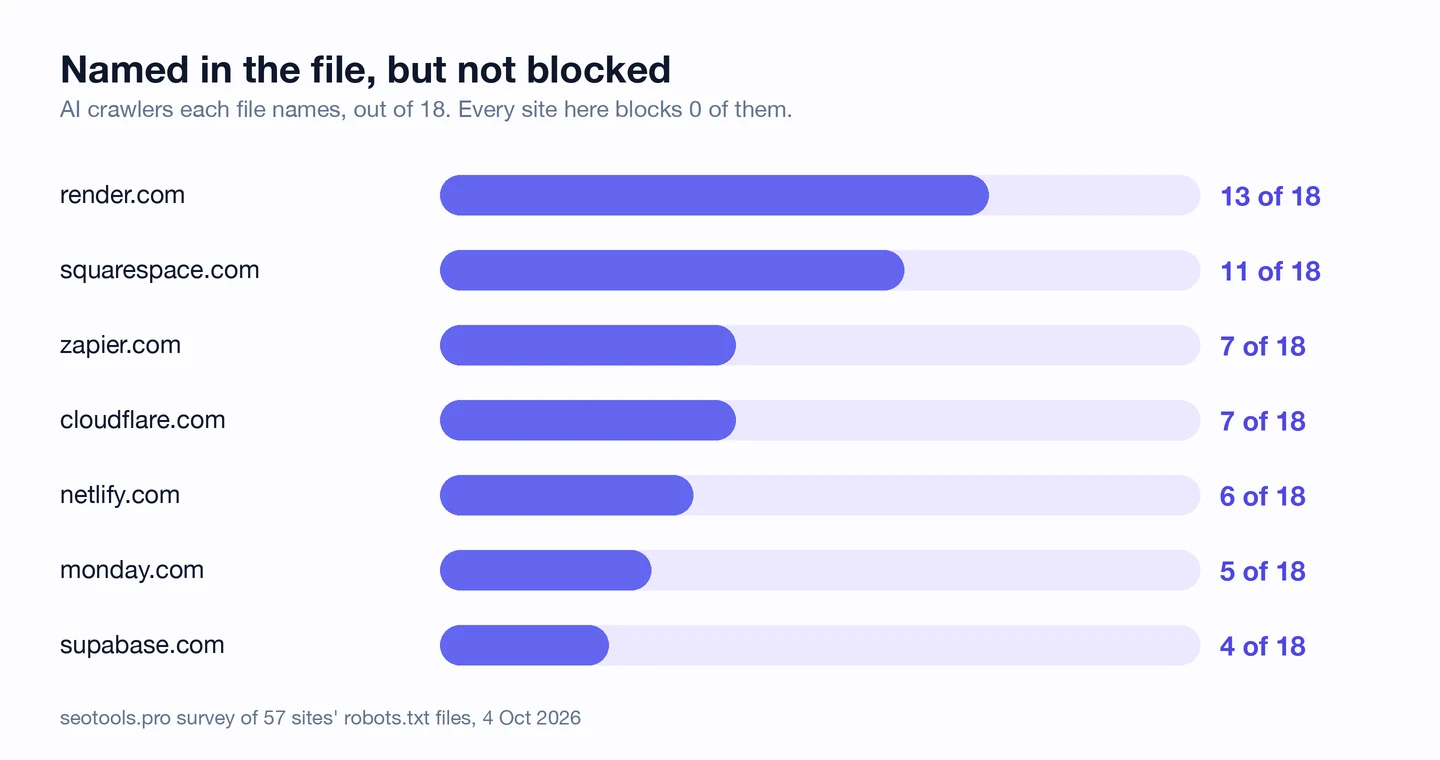
Render називає у своєму файлі 13 ШІ-краулерів. А блокує 0 з них.
Zapier, який ми теж розбирали, називає 7 і не блокує жодного. Squarespace, Netlify і ще кілька сайтів роблять так само.
Ім’я у файлі може означати різне. Воно може стояти над правилом для однієї папки, над рядком Allow або взагалі в коментарі.
Закрити для бота весь сайт може лише одне правило. Це Disallow: / під ім’ям бота, і воно означає «не заходь на жодну сторінку».
Тож читайте правило під кожним ім’ям, а не лише саме ім’я. Панель ШІ-краулерів у нашому розширенні для браузера читає правила за вас і позначає кожного бота як «Allowed» або «Blocked».
Робіть аудит robots.txt щокварталу
Файли змінюються, а нові ШІ-краулери з’являються постійно. Тож перевіряйте свій файл і файли конкурентів кожні 3 місяці.
Найшвидше перевірити це розширенням. Відкрийте сайт, натисніть значок seotools.pro і подивіться на розділ «AI search readiness».
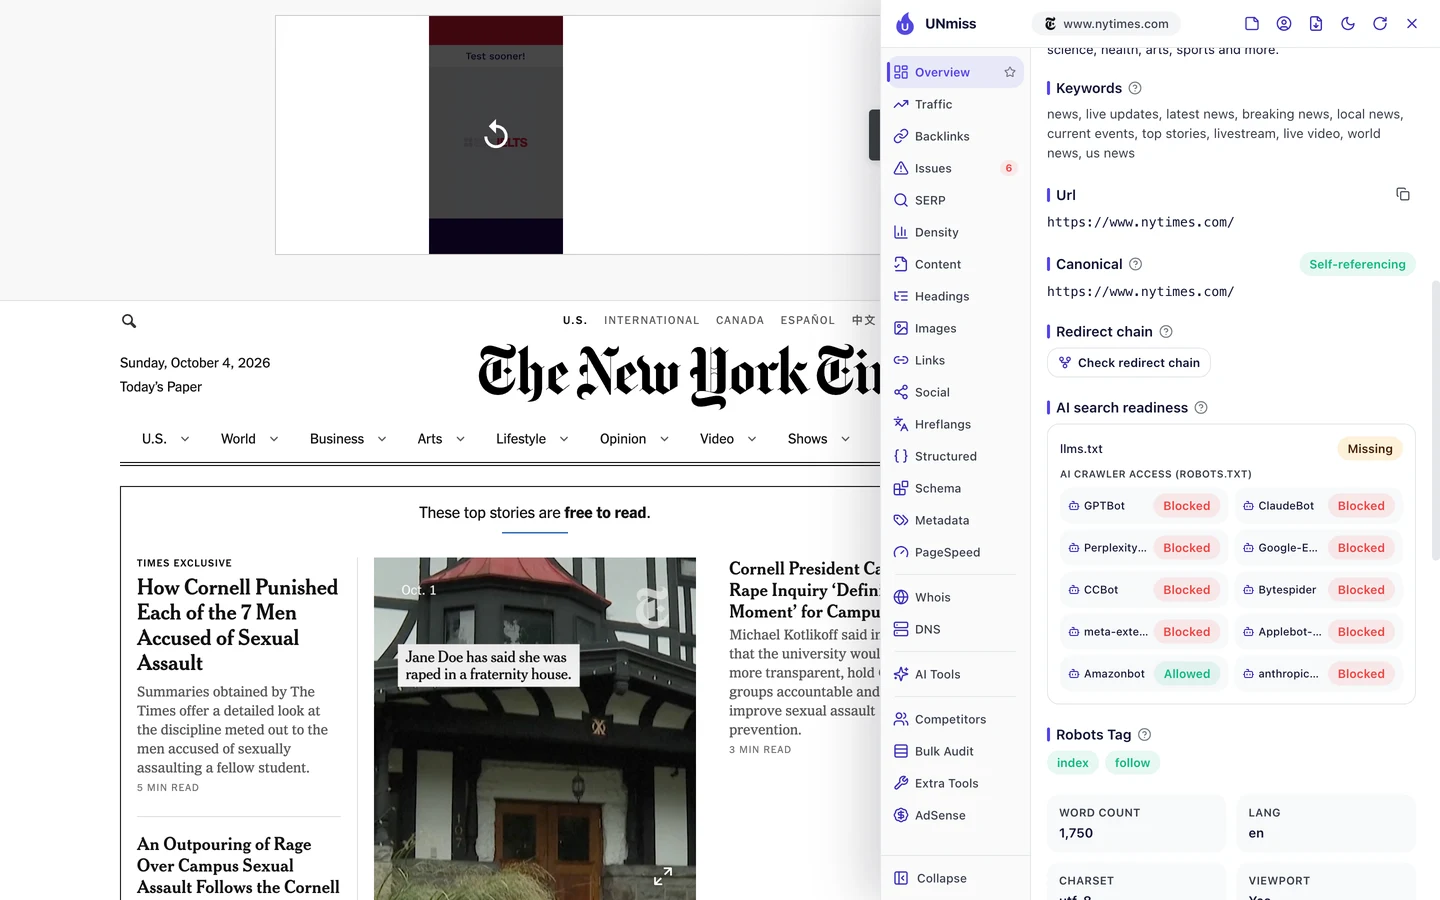
На сайті The New York Times 9 з 10 ботів позначено як «Blocked». Лише Amazonbot має позначку «Allowed».
А ще панель показує, що llms.txt немає. Stripe, навпаки, пускає всіх ботів і має цей файл.
Тепер так само перевірте свій сайт. Чи не заблокували ви помилково бота для відповідей?
Потім пошукайте прогалини. Може, у вашому списку бракує нового краулера?
Щоб перевірити весь сайт, запустіть наш Аудит сайту. Його вкладка Technical SEO показує доступ ШІ-краулерів поруч з іншими показниками стану сайту.
Ось як виглядає ця картка для сайту NHS, британської системи охорони здоров’я, з аудиту, який ми провели того ж тижня.
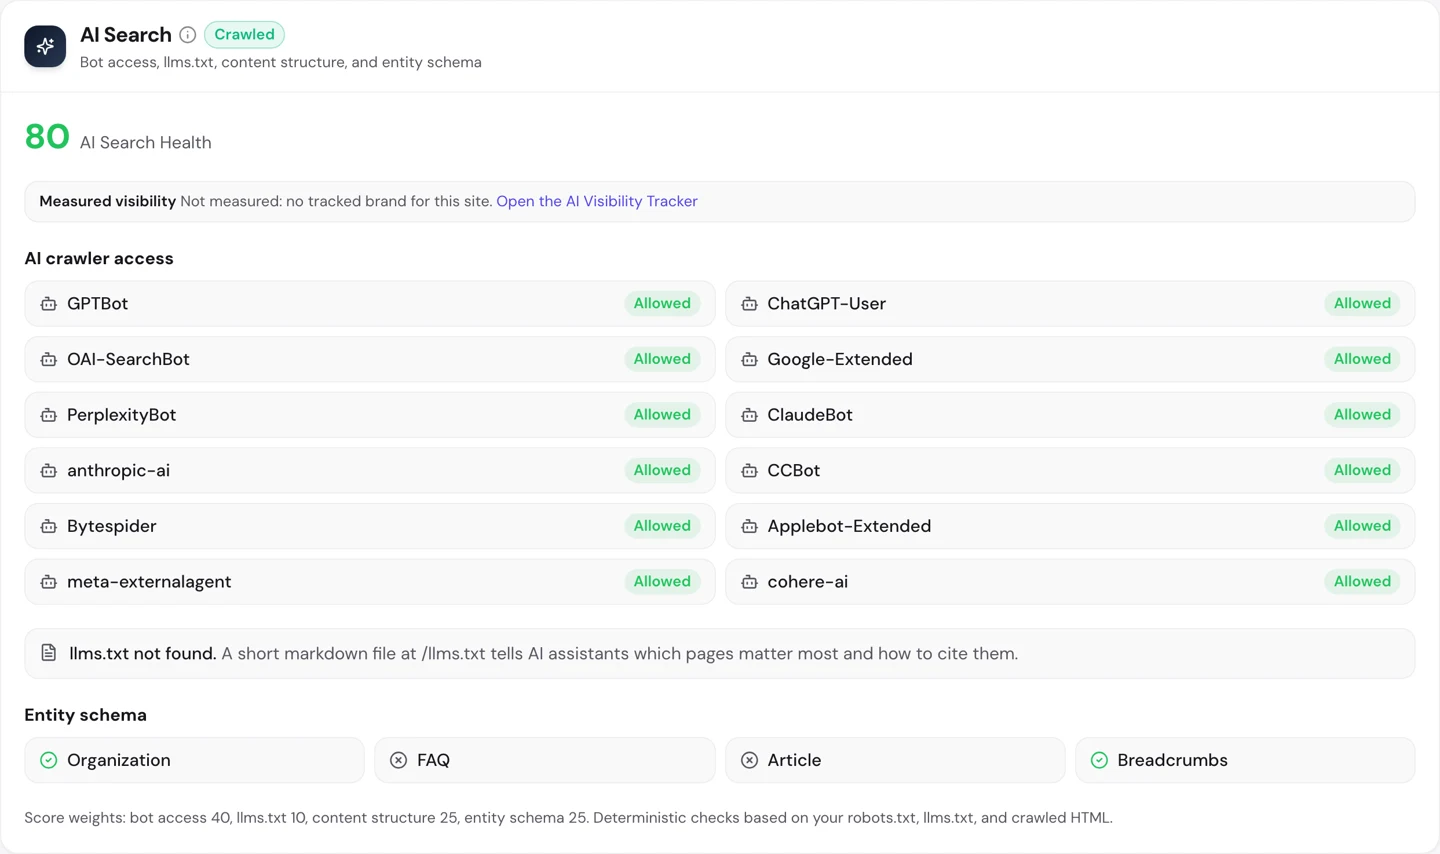
Вона показує, чи має кожен ШІ-краулер доступ, і заодно перевіряє, чи є llms.txt.
Тож поставте собі в календар перевірку кожні 3 місяці. Запускайте наш Аудит сайту для свого сайту, а розширення для сайтів конкурентів.
Не чекайте послуху від усіх ботів
І останнє, що варто знати. Robots.txt лише просить, а не замикає.
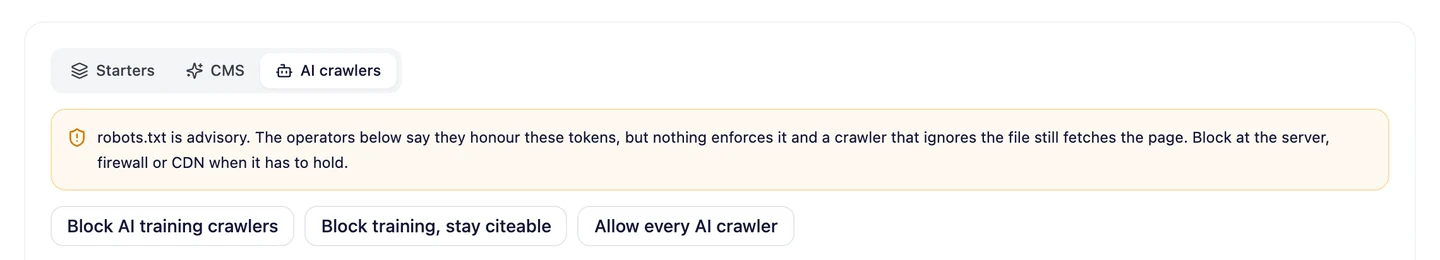
Наш генератор попереджає про це одразу вгорі. Великі ШІ-компанії запевняють, що дотримуються правил із файлу, але ніщо не змушує краулера його слухатися.
Бот, який ігнорує файл, однаково може відкрити кожну сторінку. Тож якщо сторінка має лишатися закритою, одного robots.txt замало.
Для цього блокуйте бота ще й на сервері чи у файрволі. Зазвичай налаштувати це допоможе ваш хостинг-провайдер.
Тож складіть чіткі правила в нашому генераторі robots.txt і додайте правило у файрвол для кожного бота, якого справді не можна пускати.
Кожен перевірений нами видавець блокує ШІ-краулерів, а більшість софтверних компаній ні. Наше розширення для браузера читає robots.txt будь-якого сайту й позначає кожного ШІ-краулера як «Allowed» або «Blocked», тож ви знатимете, як справи у вас.
- Та сама панель ШІ-краулерів, якою ми перевіряли The New York Times і Stripe
- Заодно перевіряє, чи є файл llms.txt
- Запускайте її і на сайтах конкурентів
Що скопіювати не вийде
Спершу про те, чого не повторити. The New York Times має відоме ім’я та величезний архів, тож може сказати «ні» інструментам ШІ, і його однаково читатимуть.
Stripe може сказати «так» кожному боту з протилежної причини. Він продає софт, тож нічого не втрачає, коли ШІ читає його сторінки.
Більшість сайтів десь посередині. Тому вибір за вами.
Тепер кілька чесних зауважень про цифри.
Усі файли ми прочитали 4 жовтня 2026 року. Файли robots.txt можуть змінитися будь-якого дня, тож повторний підрахунок може дати інші цифри.
Ми перевірили 57 сайтів і шукали в них імена 18 ШІ-краулерів. Ще 2 сайти не відповіли, тож ми їх не рахували.
Також ми не брали компанії, які роблять SEO-інструменти, зокрема й нашу, щоб ніхто не ставив оцінки сам собі.
Ми вважали, що сайт блокує краулера, лише коли файл закриває для нього весь сайт. Правила для окремої папки ми не враховували.
Скриншоти самих файлів The New York Times, The Guardian і Wired зроблено під час попередньої перевірки в серпні. А всі підрахунки ми робили в жовтні.
Панель розширення показує 10 ШІ-краулерів, а в дослідженні ми шукали 18. Тож панель може показати менше блокувань, ніж наші діаграми.
І robots.txt показує лише те, про що сайт просить. Які боти насправді слухаються, з нього не дізнатися.
Одне число, яке варто запам’ятати
9 з 9.
Саме стільки перевірених нами видавців блокують ШІ-краулерів. Їхні тексти і є товаром, тож вони їх бережуть.
Софтверні компанії пішли іншим шляхом, і хоч щось блокують лише 5 з 41. Їм важливіше потрапити у відповідь.
Ваш вибір зводиться до одного запитання. Ваші сторінки і є тим, що ви продаєте, чи лише способом це продати?
Кожну з цих перевірок можна запустити для свого сайту й для сайтів конкурентів і побачити ті самі цифри на власні очі.
Часті запитання
Чи зашкодить блокування ШІ-краулерів моїм позиціям у Google?
Ні. Googlebot, краулер пошуку Google, працює окремо від Google-Extended. Google каже, що блокування Google-Extended не впливає на позиції ваших сторінок.
Чи прибере блокування мої сторінки з моделей ШІ, які вже їх прочитали?
Ні. Блокування зупиняє лише майбутні візити. Усе, що модель вивчила до того, як ви додали правило, у ній і залишиться.
Чи можна закрити від ШІ-краулерів лише деякі сторінки?
Так. Додайте під ім’ям бота правило Disallow для однієї папки, наприклад із платними статтями. Решта сайту залишиться відкритою.
Чи згадуватимуть мене інструменти ШІ, якщо я їх заблокую?
Можливо, на основі того, що про вас пишуть інші сайти. Але ваших власних сторінок вони прочитати не зможуть, тож не зможуть ні цитувати їх, ні давати на них посилання.
Як швидко боти помічають зміни в robots.txt?
Більшість великих краулерів перечитують файл часто, зазвичай десь за добу. Дайте їм трохи часу, перш ніж перевіряти логи сервера.
Де має лежати файл robots.txt?
У корені домену, наприклад yoursite.com/robots.txt. Копію в підпапці боти ніколи не читають, а для кожного піддомену потрібен окремий файл.
Чи потрібен llms.txt, якщо robots.txt уже пускає ШІ?
Це необов’язково. Robots.txt каже, що ботам можна читати, а llms.txt дає інструментам ШІ короткий путівник по ваших найкращих сторінках.
А як бути з ботами ШІ, які не називають себе?
Robots.txt не зупинить бота, який приховує, хто він. Підозрілих відвідувачів можна помітити в логах сервера, а заблокувати їх допоможе хостинг або файрвол.