Ми перевірили 59 великих сайтів і знайшли файл llms.txt на 32 з них, але майже всі вони продають софт, а новинні сайти й інтернет-магазини обходяться без нього.
Файл llms.txt лежить у корені сайту і містить звичайний текст. Він коротко описує сайт для інструментів ШІ на кшталт ChatGPT і дає посилання на найважливіші сторінки.
4 жовтня 2026 року ми запросили цей файл у кожного сайту й прочитали все, що прийшло у відповідь.
Ось 7 уроків, які можна перейняти, і те, чого повторити не вийде.
Подивіться, що роблять конкуренти
Почнімо із загальної картини. Ми розділили сайти на 5 груп і перевірили, чи є файл у кожного.
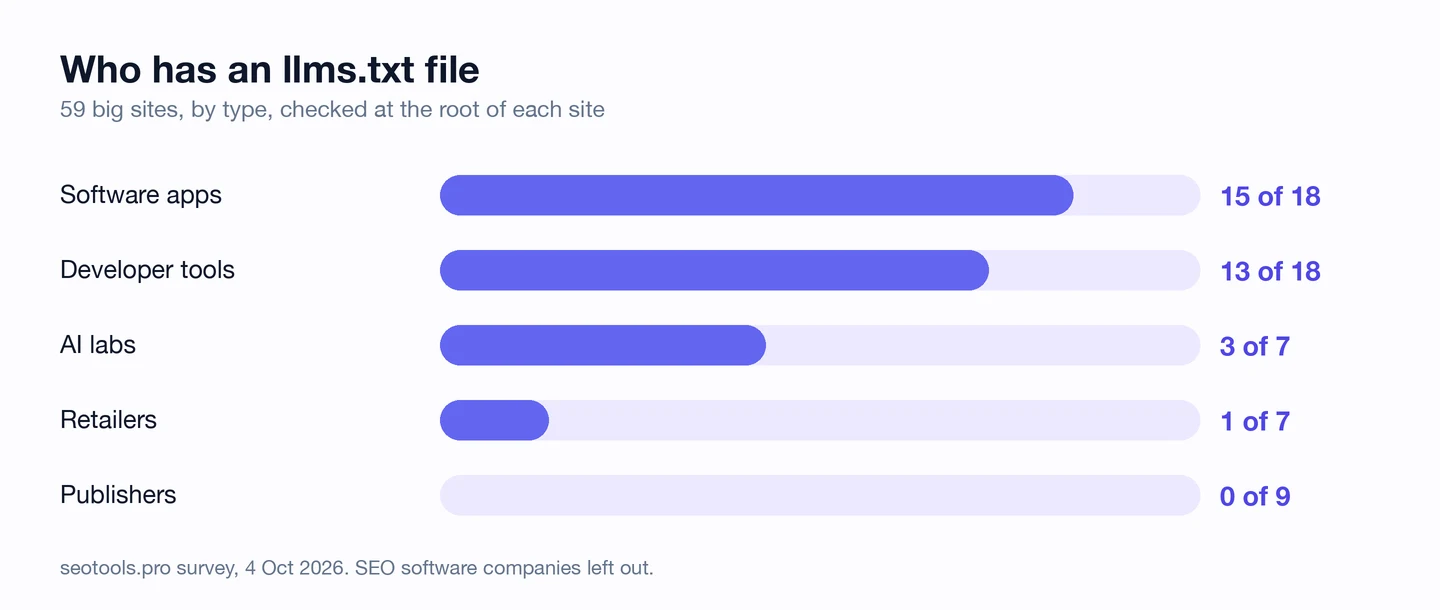
Програмні продукти й інструменти для розробників лідирують із великим відривом. Файл є у Slack, Notion, Shopify, Stripe і GitHub.
У медіа 0 з 9. Ні в The New York Times, ні в BBC, ні в CNN.
Zapier, який ми теж розбирали, — один із софтверних сайтів, де файл є.
Серед великих магазинів і маркетплейсів файл є лише в Etsy. В Amazon, eBay і Airbnb його немає.
Наша здогадка проста. Софтверним компаніям вигідно, щоб інструменти ШІ розповідали про їхній продукт і радили його.
Багато медіа заробляють на своїх текстах, тож воліють не пускати до них інструменти ШІ.
Тож перш ніж писати файл, з’ясуйте, як заведено у вашій ніші. Відкрийте головну сторінку конкурента, натисніть значок seotools.pro у нашому безкоштовному розширенні для браузера, і панель ШІ покаже, чи є в нього llms.txt.
Додайте файл на сайт документації
І ось несподіванка. Найчастіше файл трапляється на сайтах документації, тобто в тій частині сайту, де компанія пояснює, як працює її продукт.
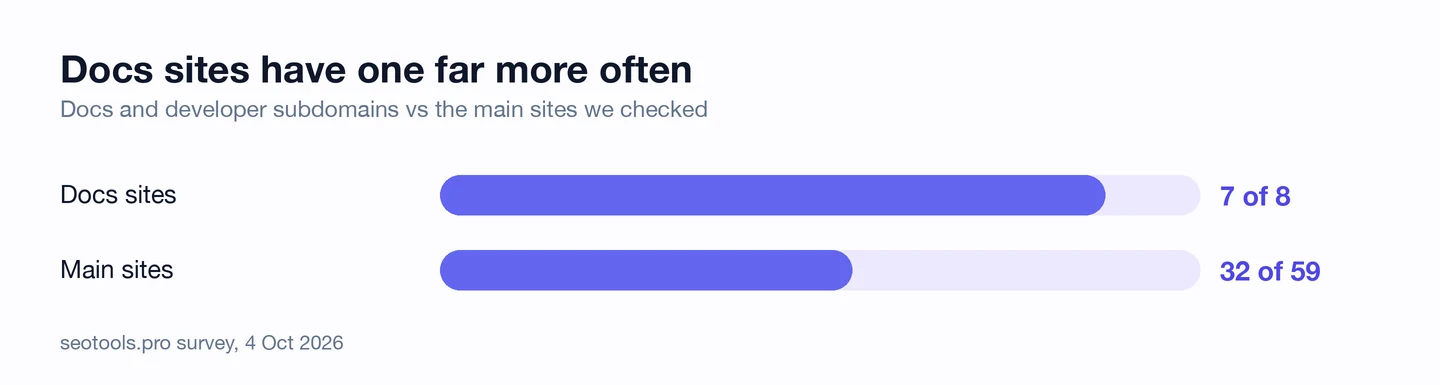
7 з 8 перевірених нами сайтів документації мають файл. Серед основних сайтів таких лише близько половини.
Погляньте на Anthropic, компанію, яка створила Claude. На її основному сайті llms.txt немає, а в документації для розробників є.
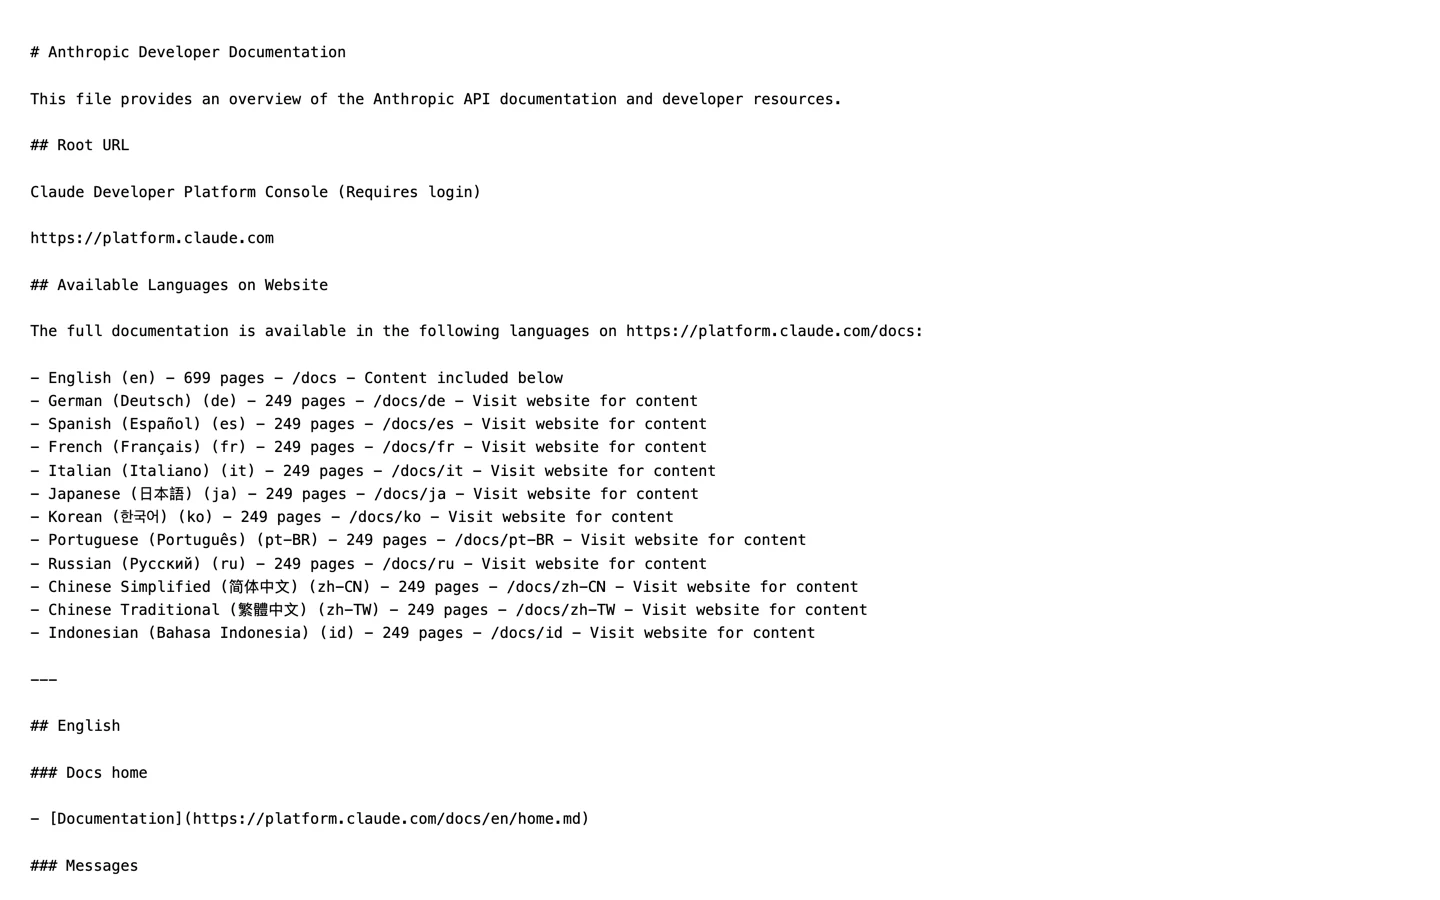
У Stripe файл є і на основному сайті, і в документації. До документації програмісти заходять, щоб навчитися працювати зі Stripe.
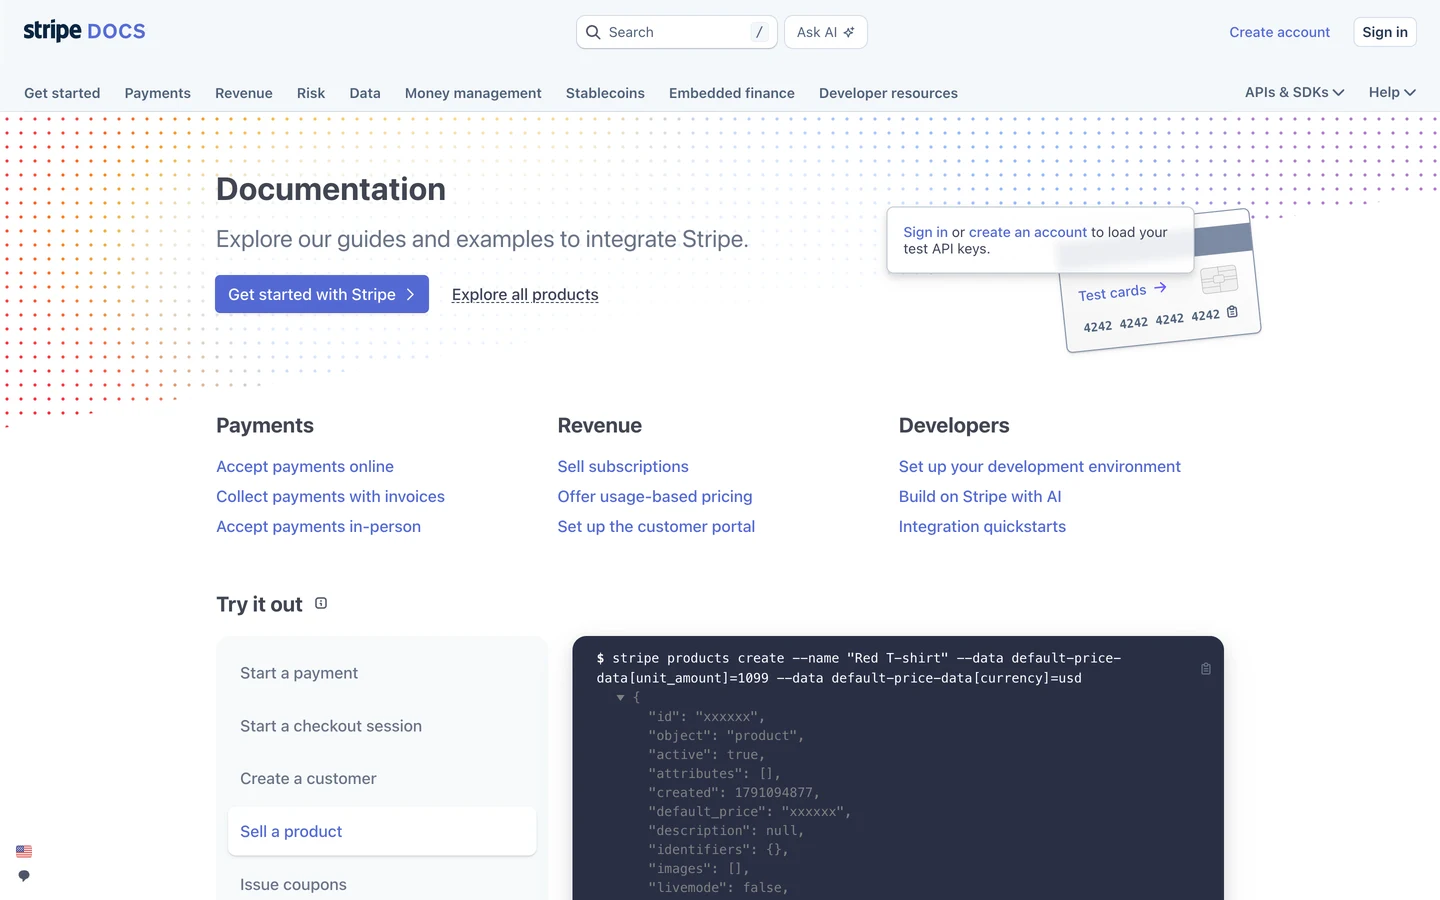
Кожне посилання на цій сторінці відповідає на запитання «як зробити...». Такі запитання люди ставлять інструментам ШІ з ранку до вечора.
Ось чому путівник для ШІ найкорисніший там, де зібрані ваші відповіді. Головна сторінка продає, а документація пояснює.
Тож якщо у вас є документація, довідковий центр чи посібники, зробіть для цієї частини сайту окремий файл. А потім поставте нашому інструменту «Перевірка видимості в ШІ» запитання, які ставлять ваші покупці, і подивіться, чи згадують вас інструменти ШІ.
Зробіть файл коротким
Файл llms.txt задуманий як короткий огляд. Більшість знайдених нами файлів такі і є, але деякі просто величезні.
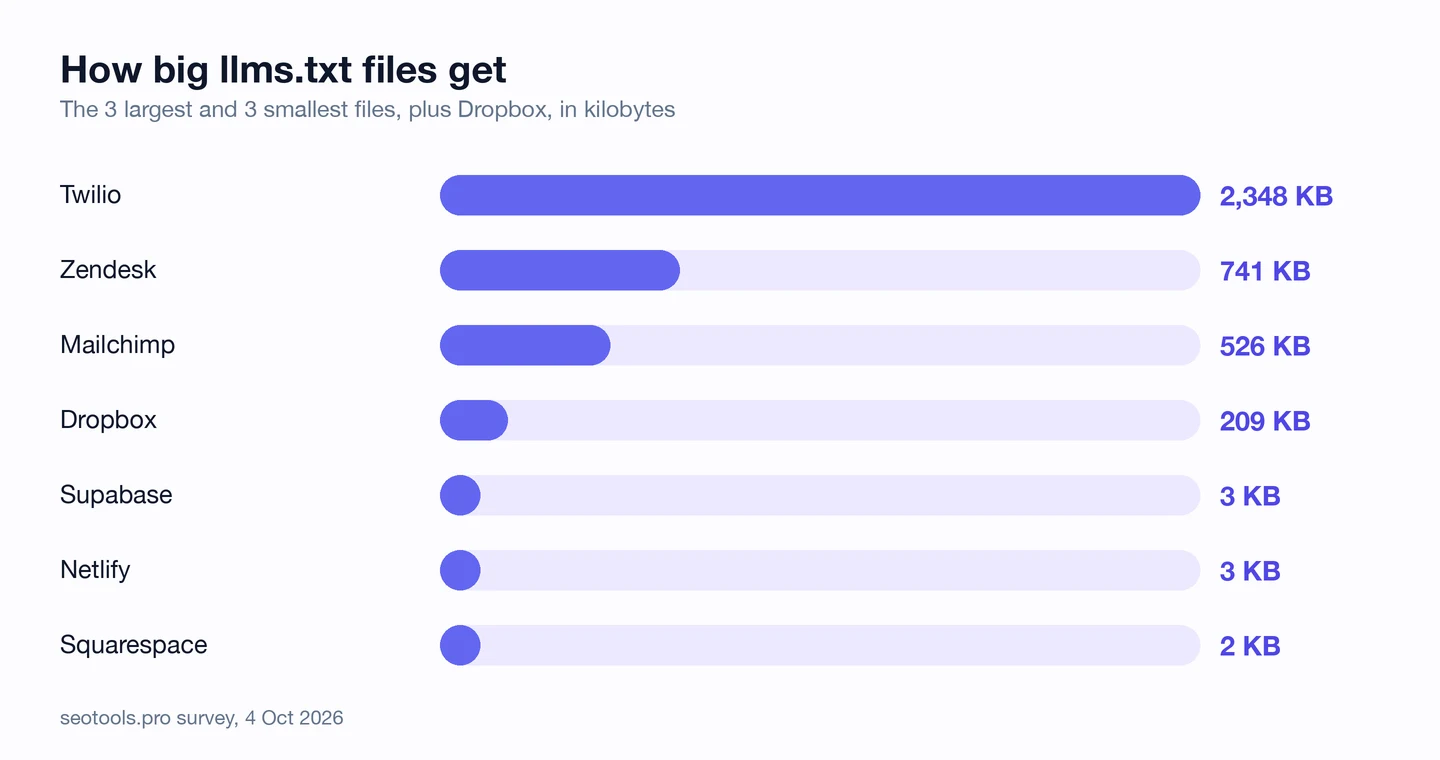
Найменші справжні файли важать від 2 до 3 КБ — це приблизно сторінка тексту. Такі компактні файли у Squarespace, Netlify і Supabase.
Файл Twilio важить близько 2,3 МБ. Це в 800 з лишком разів більше, ніж у Netlify, а посилань у ньому понад 9 тис.
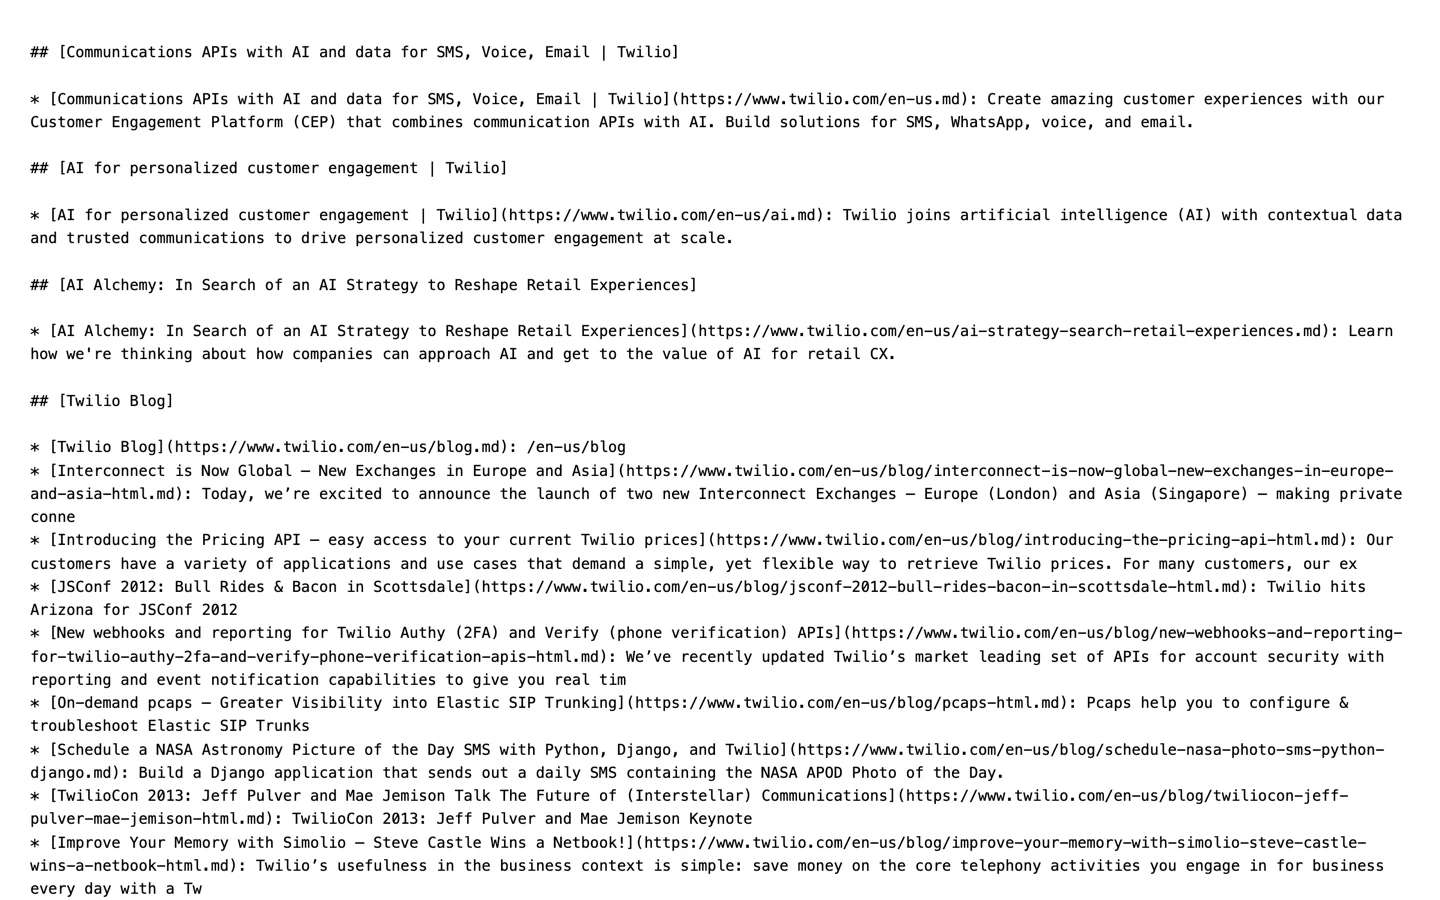
Жодному інструменту ШІ не потрібен допис про конференцію 2012 року, щоб зрозуміти, що продає Twilio. Такий великий файл перестає бути оглядом і перетворюється на звалище.
Далі йдуть Zendesk (близько 740 КБ) і Mailchimp (близько 530 КБ).
Для повного списку сторінок уже є окремий файл. Це карта сайту (sitemap), список сторінок для Google.
Тож залиште в llms.txt лише найважливіші сторінки, а решту нехай перелічує карта сайту. Наш Генератор XML Sitemap створить цей файл за вас.
Візьміть за основу просту структуру
А який вигляд має хороший файл? Чудовий приклад є у Vercel: близько 5 КБ і 25 посилань.
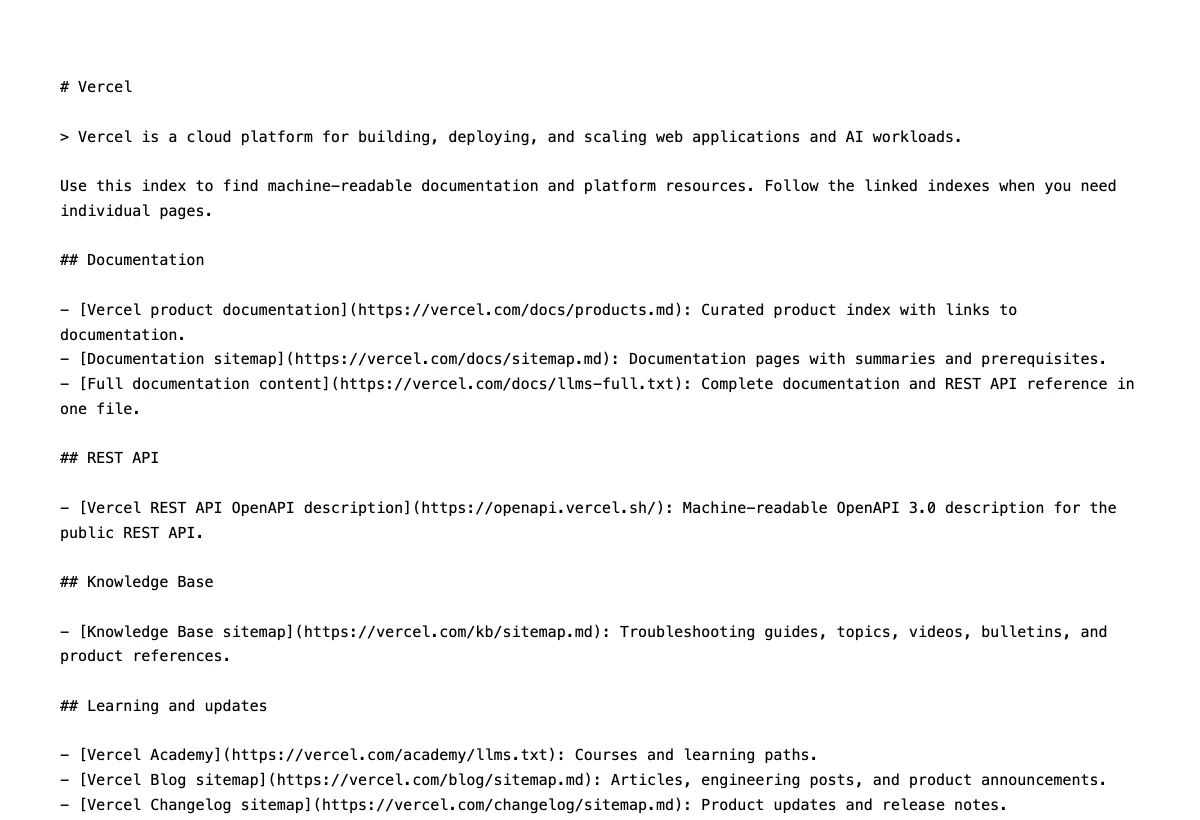
Він побудований за простою схемою, як і більшість хороших файлів. Спершу назва, потім один рядок про те, чим ви займаєтеся.
Далі йдуть короткі розділи, наприклад Documentation чи Help. У кожному рядку посилання і кілька слів про те, що за ним.
Ось і все. Код не потрібен, вистачить текстового редактора.
Найважче тут вибрати посилання. Інструментам ШІ потрібні від вас саме ті сторінки, які вже відповідають на запитання людей.
Тож складіть свій файл за цією схемою, а найкращі сторінки поставте на початок. Наш інструмент «Перевірка органічного трафіку» показує органічний трафік, тобто людей, які знаходять вас у Google без реклами, і перелічує сторінки, що залучають найбільше відвідувачів.
Проведіть аудит файлу очима краулера
Мати файл замало. Він має дійти звичайним текстом до краулера, тобто програми, яка сама обходить сторінки.
Тож ми запросили файл у кожного сайту так, як це зробив би краулер.
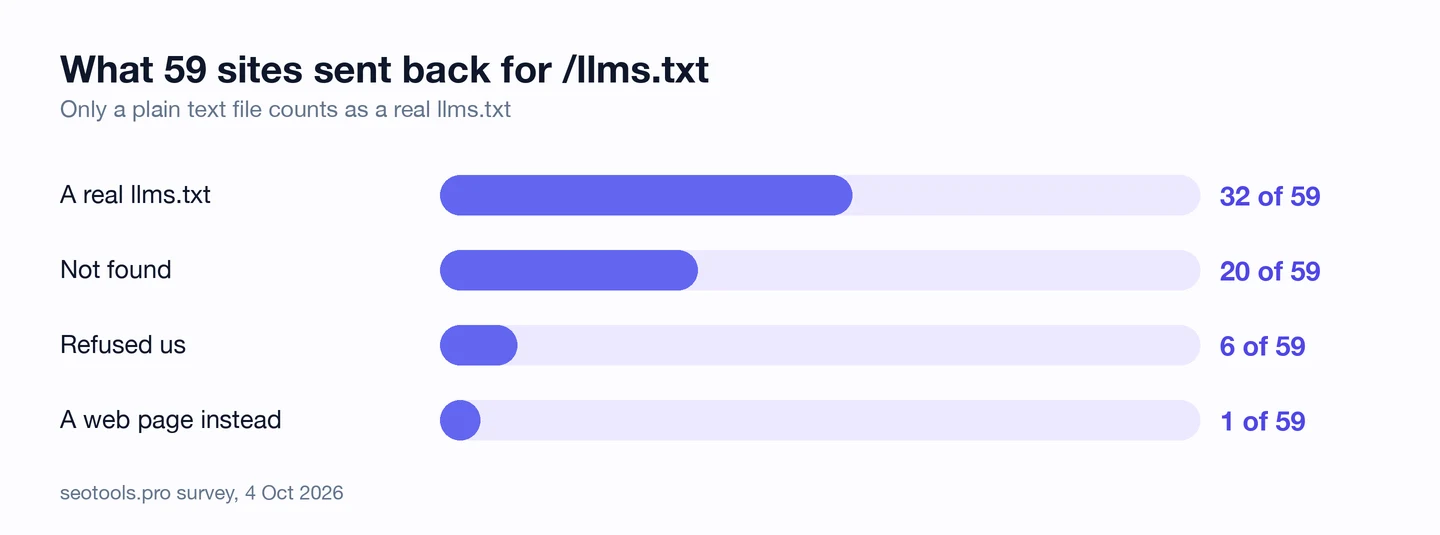
32 сайти надіслали справжній файл, а у 20 його не було. Тут усе просто.
Але 6 сайтів нам відмовили. 5 відповіли «доступ заборонено», а сайт Investopedia попросив заплатити.
Часто за цим стоїть файрвол, який не пускає незнайомих відвідувачів. Якщо він блокує нас, то може блокувати й інструменти ШІ, і тоді від вашого файлу немає жодної користі.
Найдивніше повівся wikiHow. Він відповів кодом успіху «OK», але надіслав вебсторінку, а не текстовий файл.
Тож самому коду відповіді вірити не можна. Треба дивитися, що насправді приходить.
Ось як швидко перевірити себе. Відкрийте свій сайт, натисніть значок seotools.pro у нашому розширенні для браузера і подивіться на блок AI search readiness.
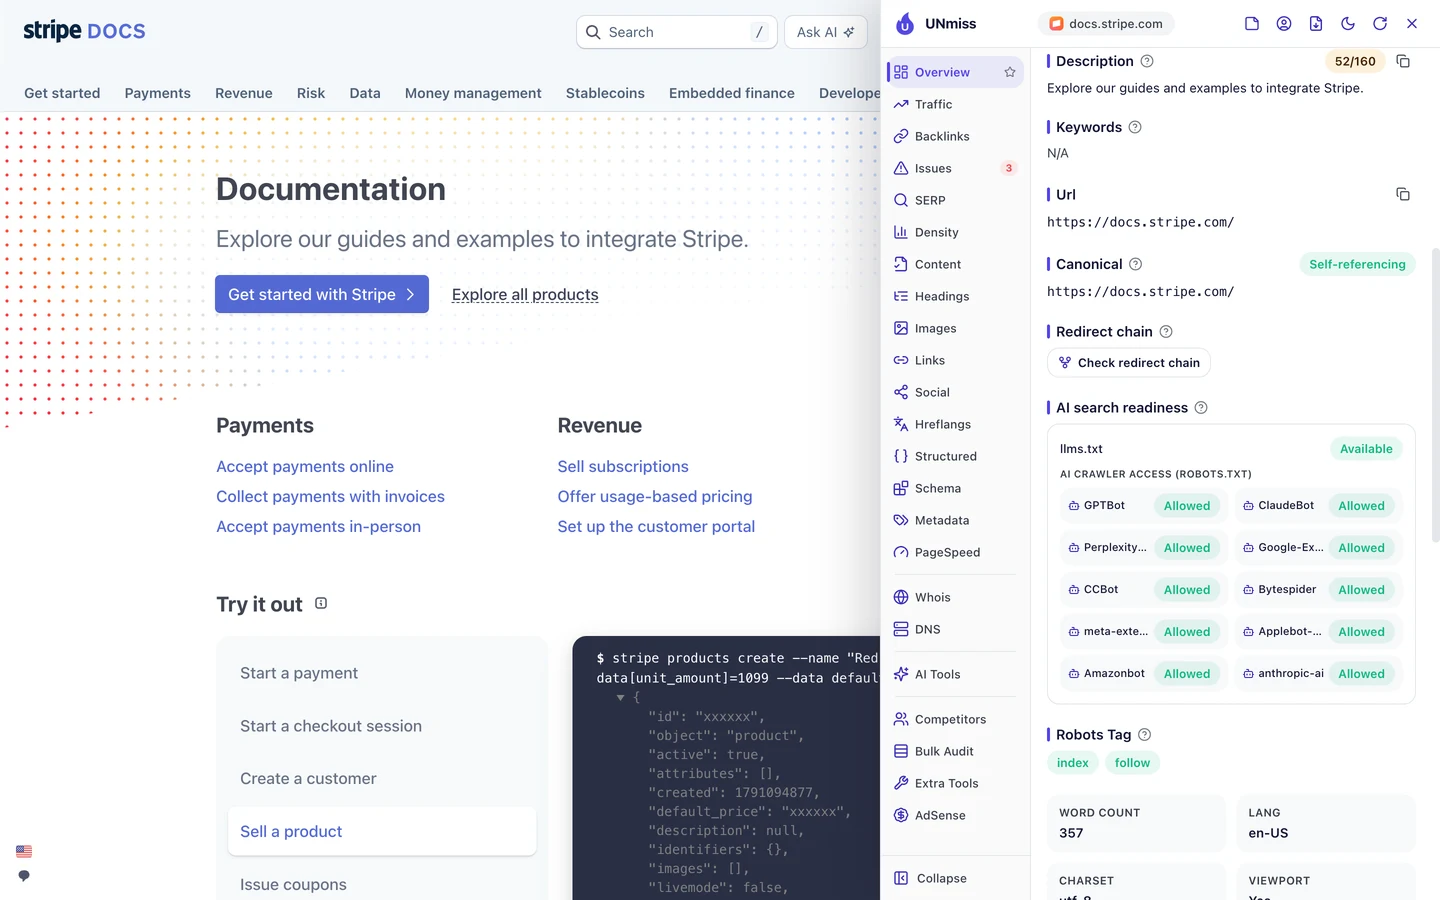
У документації Stripe розширення знаходить файл і показує, що всім ШІ-краулерам відкрито доступ. Саме так файл і має працювати.
Потім перевірте весь сайт. Наш Аудит сайту обходить ваші сторінки і на вкладці Technical SEO перевіряє llms.txt і доступ ШІ-краулерів, поруч з іншими показниками здоров’я сайту.
Ось ця картка для сайту NHS з аудиту, який ми провели того ж тижня.
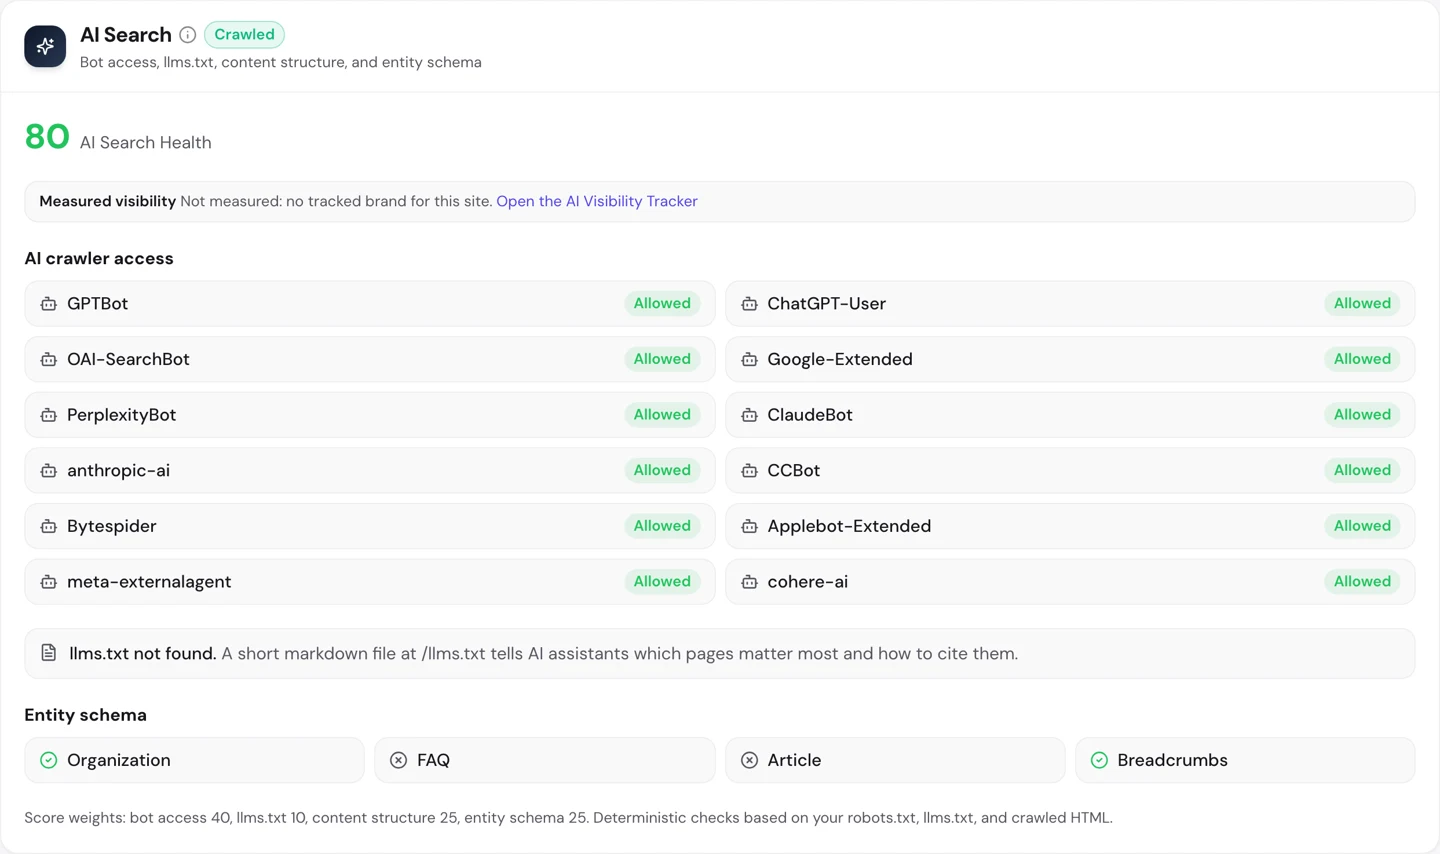
Сайт NHS пускає всіх ШІ-краулерів, але llms.txt на ньому поки немає.
Тож раз на кілька місяців відкривайте yoursite.com/llms.txt у приватному вікні. Переконайтеся, що бачите звичайний текст, а не вебсторінку чи помилку, і запускайте аудит після кожної великої зміни.
Узгодьте з ним robots.txt
Файл llms.txt запрошує інструменти ШІ на сайт. Але справжні правила записані в robots.txt, файлі, який каже краулерам, що їм можна читати.
На прикладі The New York Times видно, який вигляд мають зачинені двері.
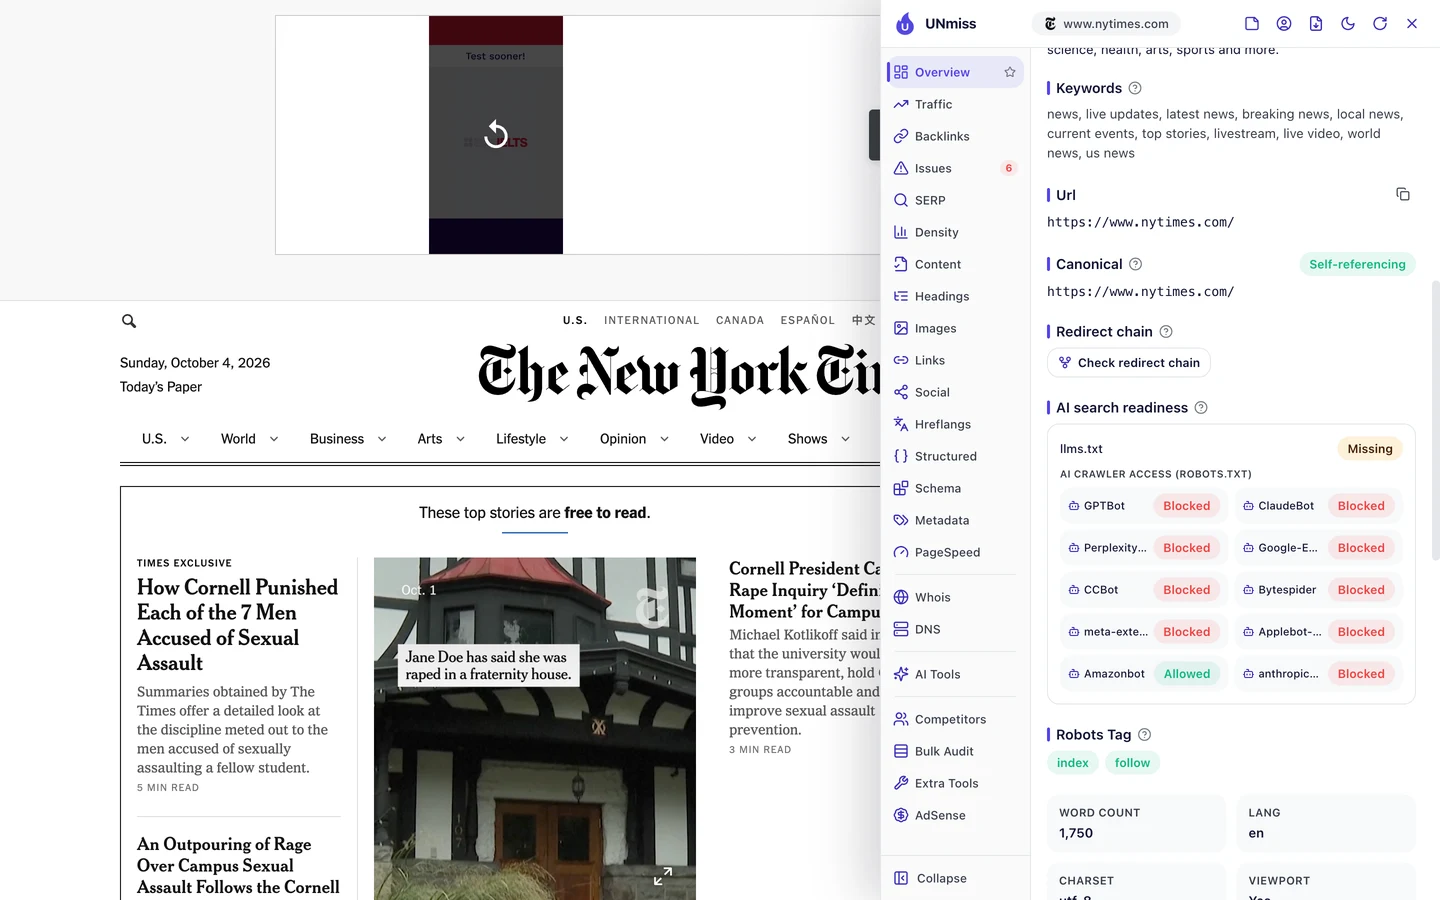
Файлу llms.txt там немає, а robots.txt блокує 9 із 10 ШІ-краулерів, яких перелічує наше розширення. Пройти може лише Amazonbot.
Це чіткий вибір, і обидва сигнали кажуть одне й те саме. Позиція Times цілком зрозуміла.
Документація Stripe, як ви бачили вище, відчиняє двері навстіж. MDN, довідник для програмістів, який ми теж розбирали, так само пускає всіх ШІ-краулерів.
Помилка в тому, щоб подавати суперечливі сигнали. Meetup, який ми теж розбирали, має llms.txt, але блокує GPTBot, краулера компанії, що створила ChatGPT.
Не всі ШІ-краулери роблять одне й те саме. Одні збирають сторінки для навчання моделей ШІ, а інші завантажують сторінку, щоб відповісти на запитання просто зараз.
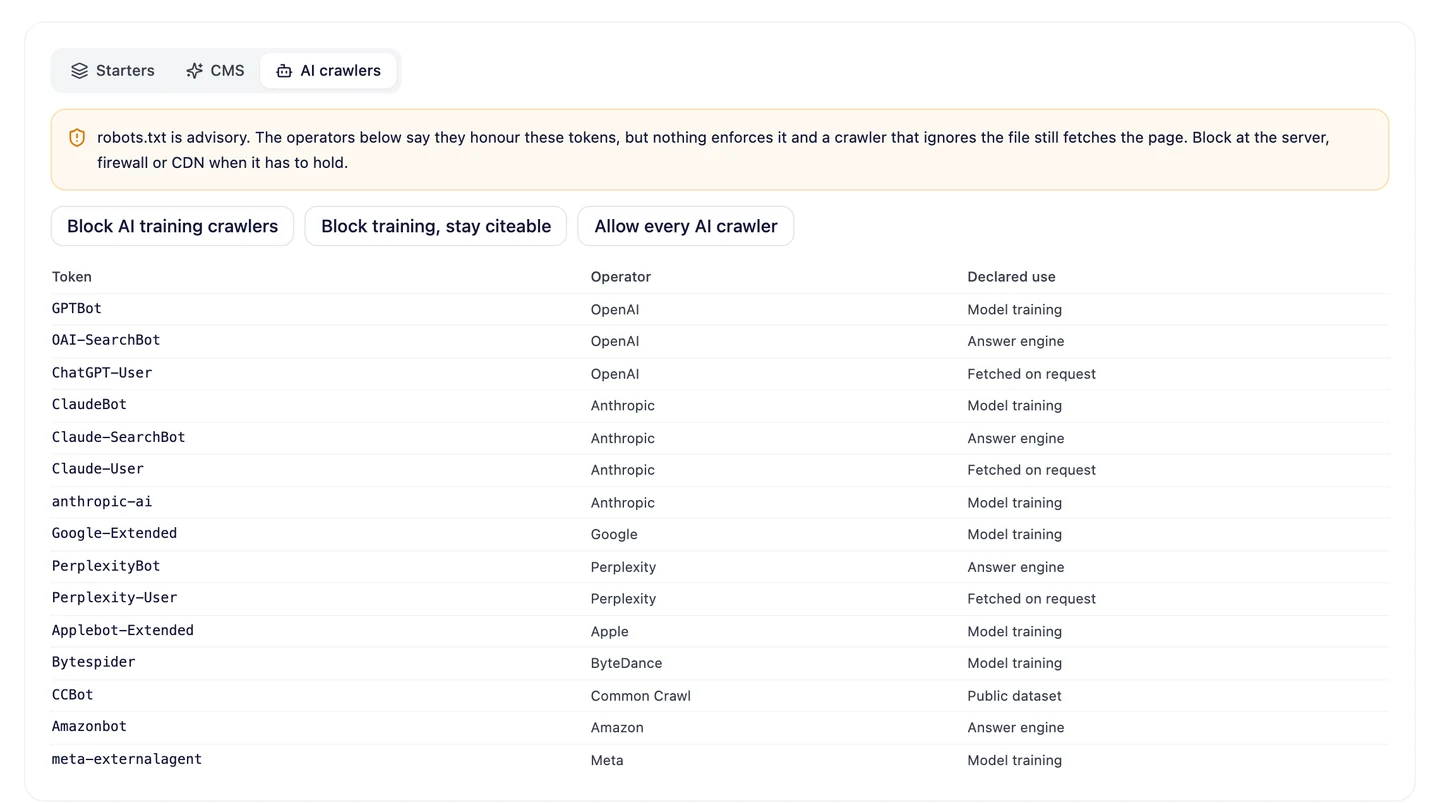
Отже, можна заборонити навчання й водночас дозволити сервісам відповідей цитувати вас. Наше дослідження robots.txt, яке ми теж провели, детальніше розповідає, хто яких краулерів блокує.
Тож спершу вирішіть, а потім зробіть так, щоб обидва файли казали те саме. Наш Robots.txt Generator пише правила і має готовий набір для кожного варіанту.
Більшість софтверних сайтів уже дають інструментам ШІ путівник, а більшість медіа їх не пускає. Ми допоможемо вам визначитися, а потім налаштуємо llms.txt і robots.txt так, щоб вони казали те саме.
- Напишемо короткий llms.txt на основі ваших найкращих сторінок
- Налаштуємо правила robots.txt для кожного ШІ-краулера
- Перевіримо, що файл доходить до інструментів ШІ звичайним текстом
- SEO і GEO, щоб вас цитували й у відповідях ШІ
Вважайте файл дешевим експериментом
А тепер чесно. Жодна ШІ-компанія не підтвердила, що читає llms.txt так, як пошукові системи читають robots.txt.
Навіть ШІ-лабораторії не дійшли згоди. Лише 3 із 7 перевірених нами мають файл на основному сайті, хоча в документації він є в більшості.
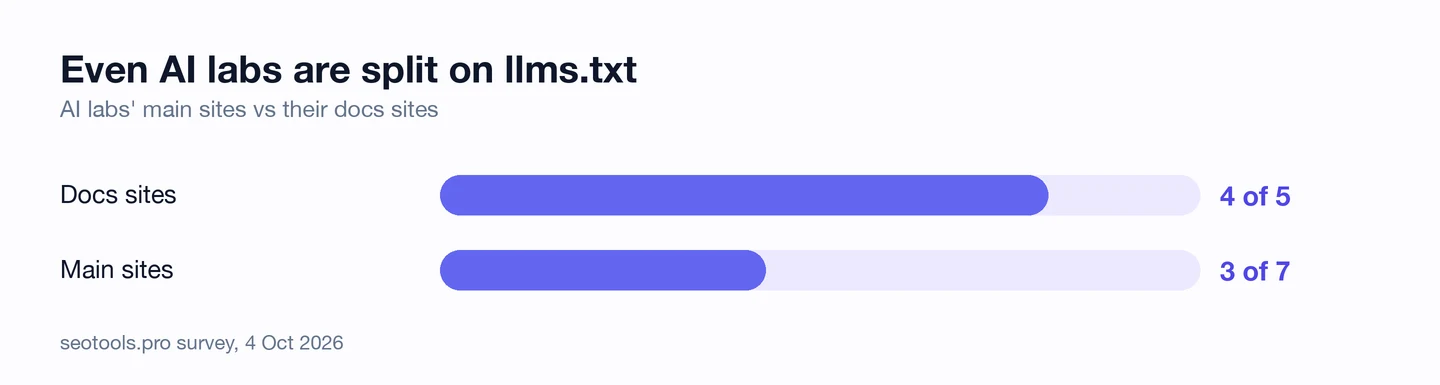
І не розраховуйте, що файл підніме вас у Google. Це записка для інструментів ШІ, а не для Google.
Зате він майже нічого не коштує. Хороший файл займає приблизно сторінку тексту, і написати його можна за півдня.
Якщо інструменти ШІ почнуть його читати, ви вже готові. Якщо ні, ви майже нічого не втратили.
Коли перевірятимете, дивіться не лише на згадки, а й на посилання. Наше дослідження цитувань у ШІ, яке ми теж провели, показало, що інструменти ШІ раз у раз називають бренди, але не ставлять на них посилань.
Тож додайте файл, запишіть дату й стежте, що зміниться. Наш інструмент «Перевірка видимості в ШІ» показує, чи згадують вас інструменти ШІ, і ви зможете порівняти, як було і як стало.
Stripe і The New York Times ми перевіряли саме цією панеллю. Наше розширення для браузера показує, чи є на сайті llms.txt і яких ШІ-краулерів пускає його robots.txt.
- Та сама панель ШІ, якою ми користувалися в цьому дослідженні
- Чи дозволено доступ кожному великому ШІ-краулеру
- Перевіряйте так само й сайти конкурентів
Що скопіювати не вийде
Почнімо з того, чого не повторити: з документації, яку люди вже читають щодня.
У Stripe, GitHub і Vercel файли ведуть на сторінки, якими програмісти постійно користуються. Файл не додасть вашим сторінкам цінності, тож спершу подбайте про самі сторінки.
Тепер кілька чесних зауважень про цифри.
Ми запросили файл у кожного сайту 4 жовтня 2026 року. Файли часто змінюються, тож коли ви це читатимете, деякі з них можуть бути вже іншими.
Ми не брали до вибірки компанії, що роблять SEO-сервіси, зокрема й нашу, щоб ніхто не оцінював сам себе.
Ми зараховували файл, лише якщо він приходив звичайним текстом. 6 сайтів нам відмовили, тож ми не знаємо, чи є в них файл.
Ми перевіряли корінь кожного основного сайту, а також 8 сайтів документації. Компанія може зберігати файл там, куди ми не зазирали.
Скриншоти файлів Vercel, Twilio та Anthropic на кілька тижнів старші за дослідження. Відтоді файли могли змінитися.
І це 59 відомих сайтів, а не весь інтернет. Дослідження показує, що роблять великі бренди, а не що працює найкраще.
Одне число, яке варто запам’ятати
32.
Саме в стількох із 59 перевірених нами сайтів є llms.txt. Майже всі вони продають софт, а на сайтах документації файл трапляється ще частіше.
Хороші файли короткі, прості, і в них багато посилань на сторінки, які відповідають на запитання. Погані перетворюються на звалище або взагалі не доходять до читача звичайним текстом.
Напишіть свій так, як це зробив Vercel, розмістіть його поруч зі своїми відповідями і переконайтеся, що robots.txt йому не суперечить.
Кожну з цих перевірок можна запустити для свого сайту й для сайтів конкурентів і побачити ті самі цифри на власні очі.
Часті запитання
Чи може llms.txt заборонити інструментам ШІ використовувати мій контент?
Ні. Це запрошення, а не правило. Щоб не пустити краулера, потрібен robots.txt, і навіть він діє лише на тих краулерів, які самі вирішили його дотримуватися.
Що таке llms-full.txt?
Деякі сайти додають другий файл, де весь текст документації зібрано в одному місці. Залиште llms.txt коротким путівником, а якщо створите повний файл, поставте на нього посилання з llms.txt.
Чи варто цим займатися малому бізнесу чи блогу?
Варто, якщо люди питають інструменти ШІ про вашу сферу. Залиште у файлі лише ключові сторінки: про те, чим ви займаєтеся, ціни, найкращі посібники й контакти.
Чи може llms.txt зашкодити моєму сайту?
Сам по собі ні. Тільки пам’ятайте, що його може прочитати будь-хто, тож ніколи не додавайте туди закриті сторінки, тестові сторінки чи будь-що, чого ви не показали б незнайомій людині.
Чи потрібні мені текстові копії сторінок?
Ні. Деякі сайти посилаються на чисті текстові версії кожної сторінки, але звичайні посилання теж добре працюють. Почніть із простого, а текстові копії додасте пізніше, якщо захочете.
Як дізнатися, чи прочитав мій файл інструмент ШІ?
Пошукайте в журналах сервера запити до /llms.txt. У кожному запиті вказано ім’я відвідувача, тож ви побачите, які ШІ-краулери запитували файл і коли.
Як часто його оновлювати?
Щоразу, коли ви додаєте, переносите чи видаляєте ключову сторінку. Посилання, яке веде на помилку, робить увесь файл схожим на закинутий.
А якщо мій сайт має кілька мовних версій?
Напишіть файл основною мовою і додайте короткий розділ із посиланнями на кожну мовну версію. Якщо кожна мова має власний піддомен, зробіть для кожного окремий файл.