Мы поискали файл llms.txt на 59 крупных сайтах и нашли его у 32, но почти все они продают софт, а новостные сайты и магазины без него обходятся.
Файл llms.txt написан обычным текстом и лежит в корне сайта. Он коротко рассказывает ИИ-инструментам вроде ChatGPT, о чем сайт, и дает ссылки на самые важные страницы.
4 октября 2026 года мы запросили этот файл у каждого сайта и прочитали, что пришло в ответ.
Ниже 7 уроков, которые можно перенять, и то, что повторить не выйдет.
Посмотрите, что делают конкуренты
Начнем с общей картины. Мы разбили сайты на 5 групп и в каждой проверили, у кого есть файл.
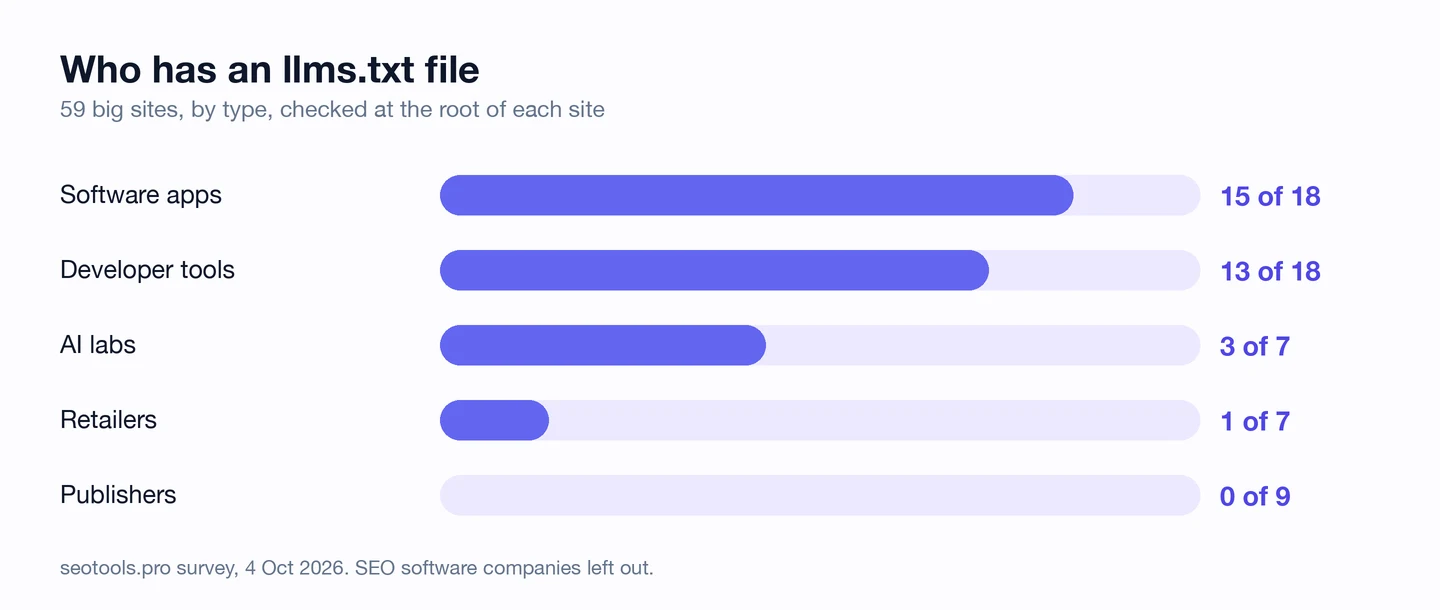
Приложения и инструменты для разработчиков обгоняют всех с огромным отрывом. Файл есть у Slack, Notion, Shopify, Stripe и GitHub.
У издателей 0 из 9. Ни у The New York Times, ни у BBC, ни у CNN.
Zapier, который мы тоже разбирали, как раз из тех приложений, у которых файл есть.
Среди крупных магазинов и маркетплейсов файл есть только у Etsy. У Amazon, eBay и Airbnb его нет.
Догадка у нас простая. Софтверным компаниям нужно, чтобы ИИ-инструменты рассказывали об их продукте и советовали его.
А многие издатели зарабатывают на своих текстах, поэтому предпочитают держать ИИ-инструменты подальше.
Так что прежде чем писать свой файл, узнайте, как принято в вашей нише. Откройте главную страницу конкурента, нажмите на значок seotools.pro в нашем бесплатном расширении для браузера, и в ИИ-панели будет видно, есть ли у конкурента llms.txt.
Разместите файл в документации
А вот что удивляет. Чаще всего этот файл встречается на сайтах документации, то есть в разделах, где компания объясняет, как работает ее продукт.
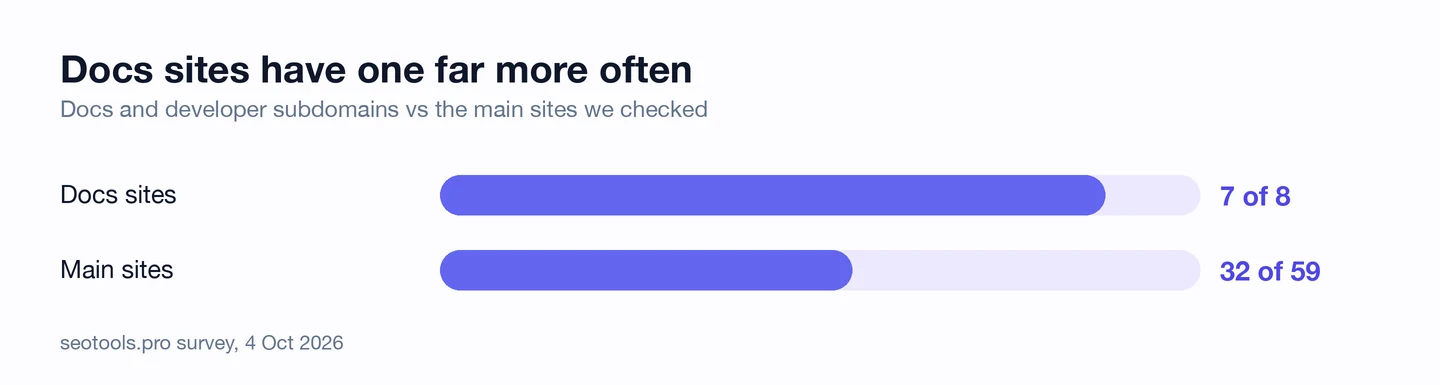
Из 8 проверенных нами сайтов документации файл есть у 7. Среди основных сайтов таких лишь около половины.
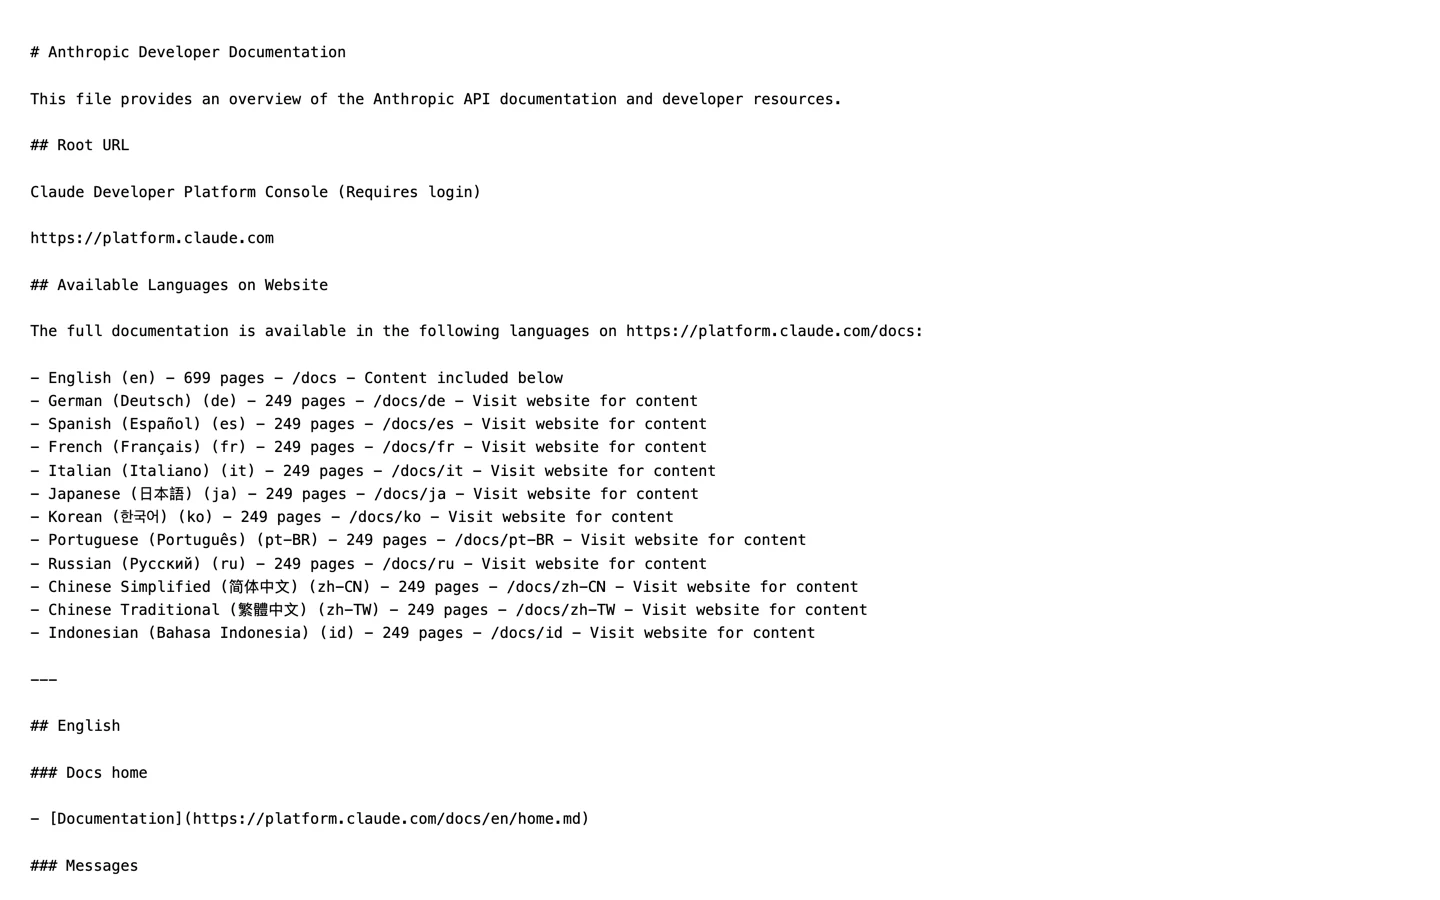
Возьмем Anthropic, компанию, которая создала Claude. На ее основном сайте llms.txt нет, а в документации для разработчиков есть.
У Stripe файл есть и на основном сайте, и в документации. В документацию приходят программисты, чтобы узнать, как встроить Stripe в свой продукт.
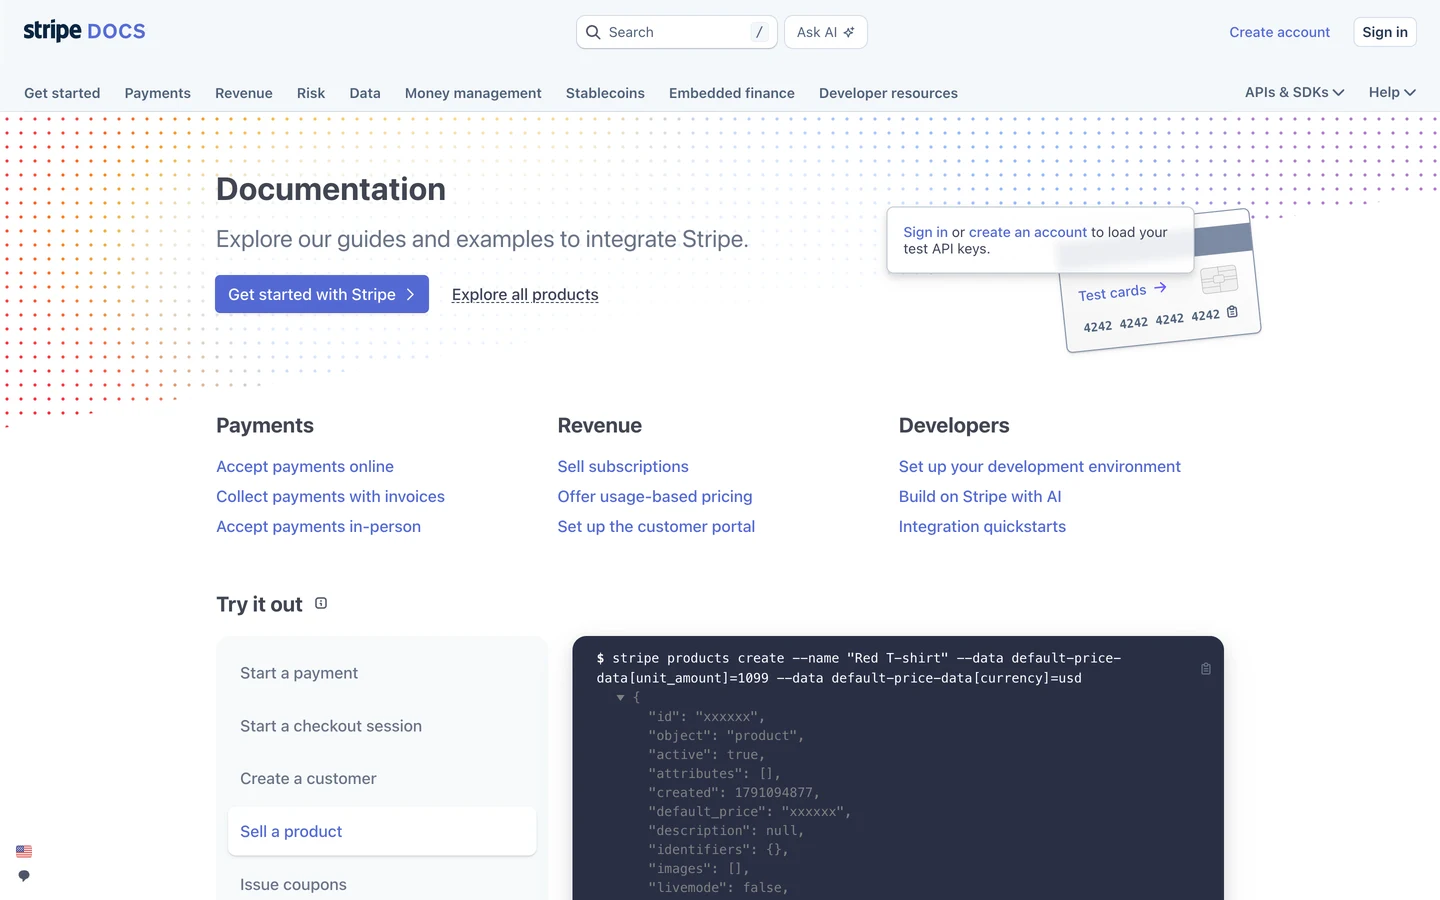
Каждая ссылка на этой странице отвечает на вопрос, который начинается со слов «как сделать». Люди целыми днями задают такие вопросы ИИ-инструментам.
Поэтому путеводитель для ИИ-инструментов полезнее всего там, где лежат ваши ответы. Главная страница продает, а документация объясняет.
Так что если у вас есть документация, справочный центр или руководства, заведите для этой части сайта отдельный файл. А потом задайте нашему инструменту «Проверка видимости в ИИ» вопросы ваших покупателей и посмотрите, упоминают ли вас ИИ-инструменты.
Сделайте файл коротким
Файл llms.txt задуман как краткая сводка. Большинство найденных нами файлов так и выглядят, но несколько оказались огромными.
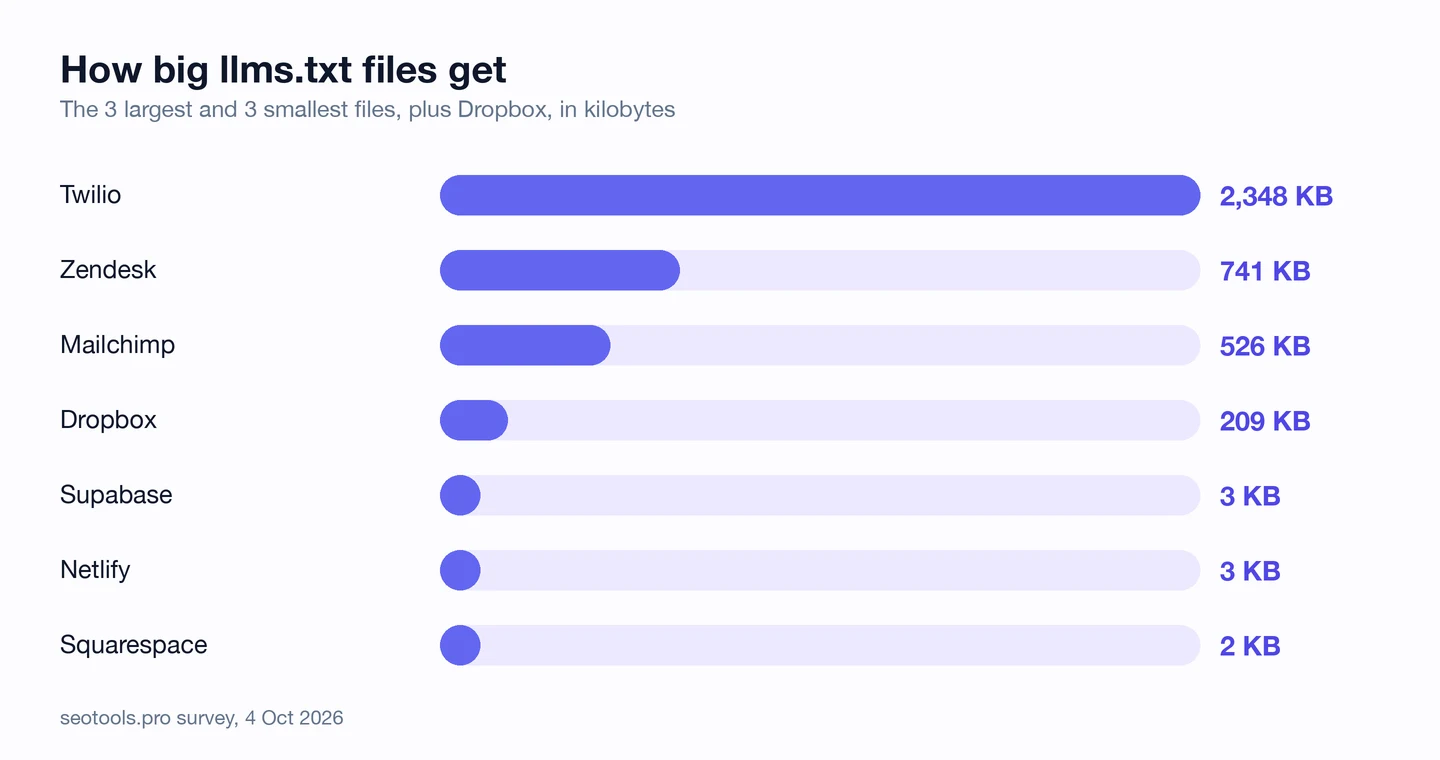
Самые маленькие настоящие файлы весят от 2 до 3 КБ — это примерно страница текста. Такие компактные файлы у Squarespace, Netlify и Supabase.
Файл Twilio весит около 2,3 МБ. Он в 800 с лишним раз больше файла Netlify, и в нем больше 9 тыс. ссылок.
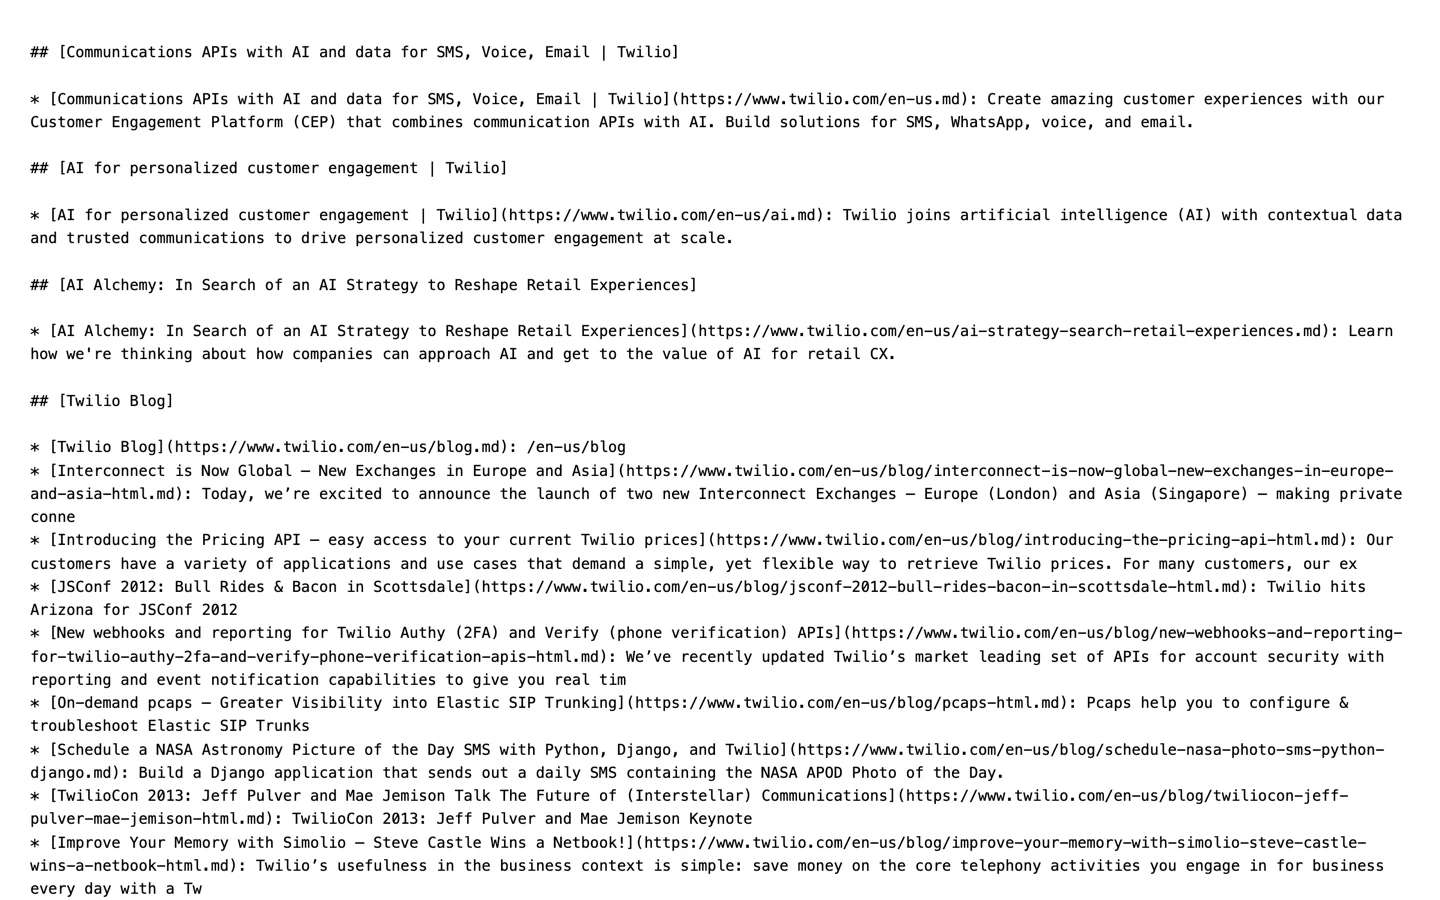
Ни одному ИИ-инструменту не нужен пост о конференции 2012 года, чтобы понять, что продает Twilio. Такой огромный файл перестает быть сводкой и превращается в свалку.
Следом идут Zendesk и Mailchimp с файлами примерно в 740 КБ и 530 КБ.
Для полного списка ваших страниц место уже есть. Это карта сайта, то есть файл со списком страниц для Google.
Так что оставьте в llms.txt только самые важные страницы, а остальные пусть перечисляет карта сайта. Наш Генератор XML-карты сайта создаст этот файл за вас.
Скопируйте простую структуру
Как же выглядит хороший файл? Наглядный пример есть у Vercel: около 5 КБ и 25 ссылок.
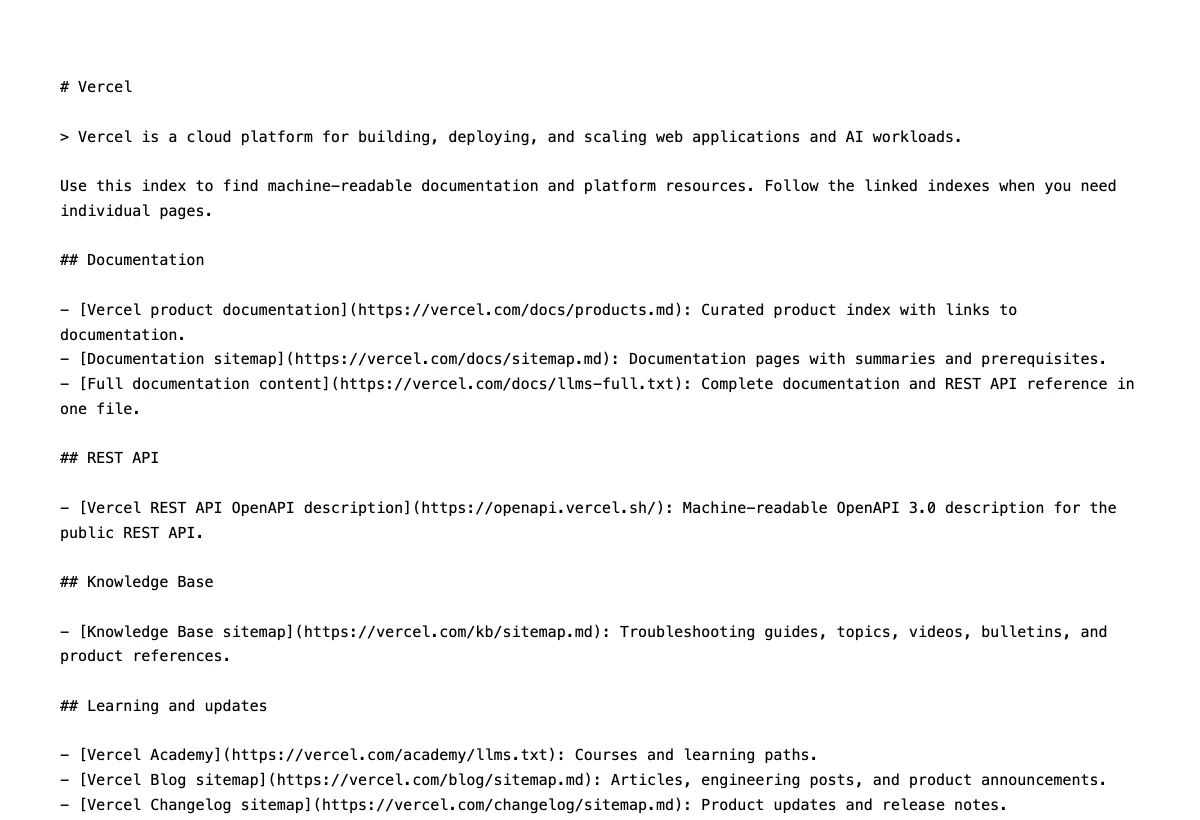
У него та же простая схема, что и у большинства хороших файлов. Сначала название, потом одна строка о том, чем вы занимаетесь.
Дальше идут короткие разделы, например Documentation или Help. В каждой строке ссылка и пара слов о том, что за ней.
Вот и все. Код не нужен, хватит обычного текстового редактора.
Сложнее всего выбрать ссылки. ИИ-инструментам нужны от вас те страницы, которые уже отвечают на вопросы людей.
Так что соберите свой файл по этой схеме, а лучшие страницы поставьте в начало. Наш инструмент «Проверка органического трафика» показывает ваш органический трафик, то есть людей, которые находят вас в Google без рекламы, и выдает список страниц, которые приводят больше всего посетителей.
Проведите аудит глазами краулера
Мало просто завести файл. Нужно, чтобы краулер, то есть программа, которая сама обходит страницы, получил его обычным текстом.
Поэтому мы запрашивали файл у каждого сайта так, как это сделал бы краулер.
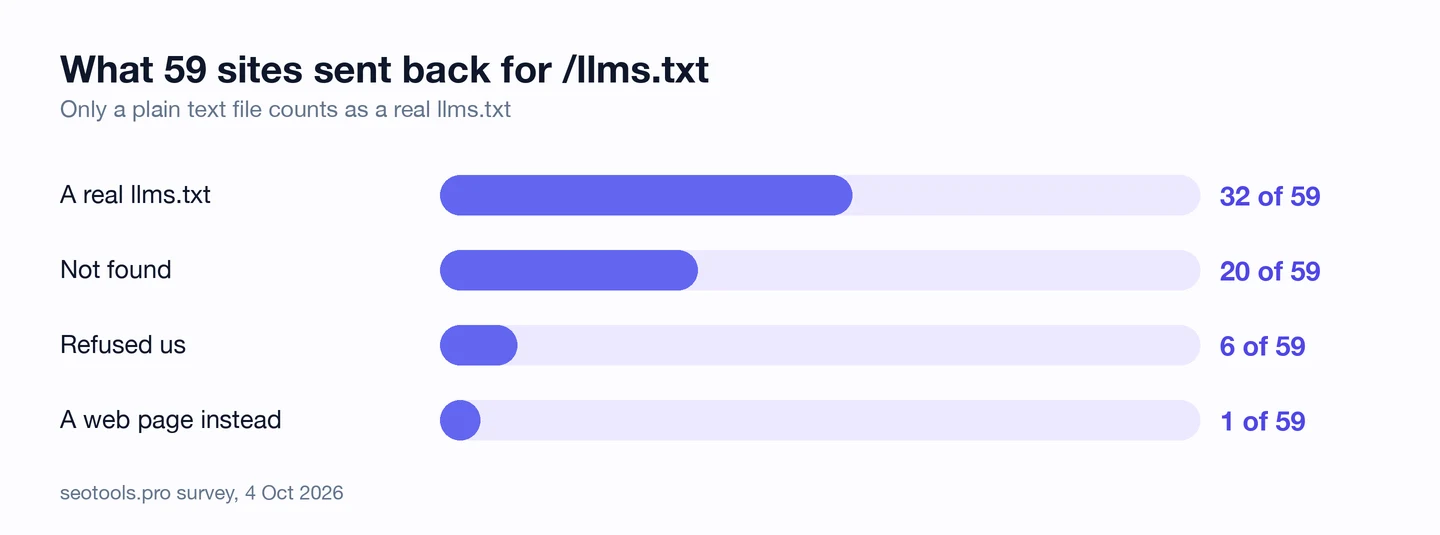
32 сайта прислали настоящий файл, а у 20 его не оказалось. Тут все просто.
Но 6 сайтов нас не пустили. 5 ответили «forbidden» (доступ запрещен), а на Investopedia с нас потребовали оплату.
Часто за этим стоит файрвол, который не пускает незнакомых посетителей. Если он блокирует нас, то может блокировать и ИИ-инструменты, и тогда от вашего файла никакого толку.
Особый случай wikiHow. Сайт ответил «OK» — это код успешного ответа, но прислал веб-страницу, а не текстовый файл.
Так что код ответа сам по себе может соврать. Нужно смотреть, что пришло на самом деле.
Вот как быстро проверить свой файл. Откройте сайт, нажмите на значок seotools.pro в нашем расширении для браузера и посмотрите на блок AI search readiness (готовность к ИИ-поиску).
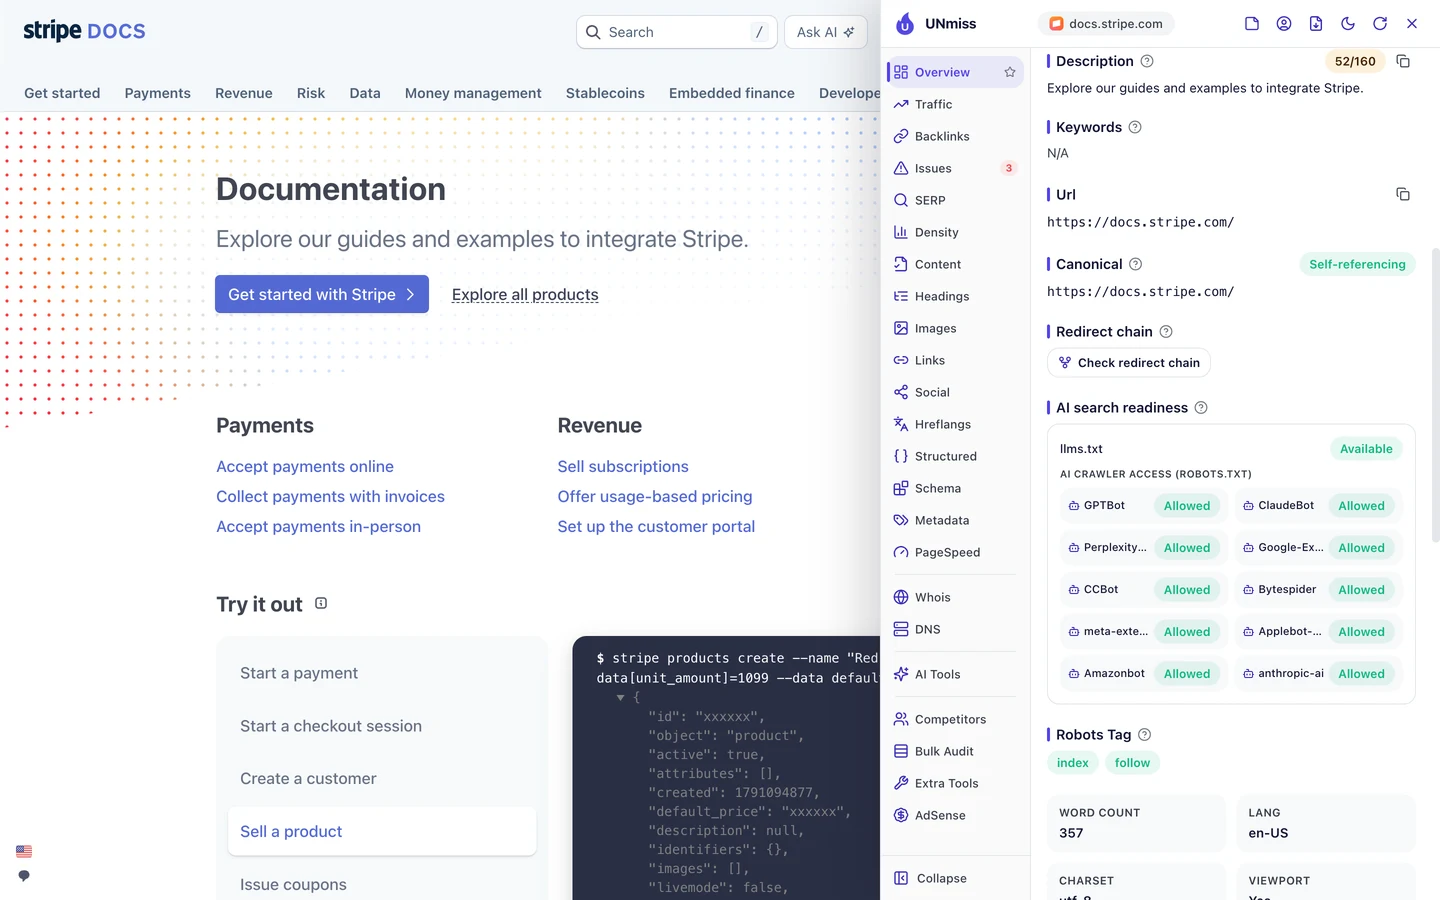
В документации Stripe расширение находит файл и показывает, что всем ИИ-краулерам открыт доступ. Вот так выглядит файл, который делает свое дело.
Потом проверьте весь сайт. Наш Аудит сайта обходит ваши страницы и проверяет llms.txt и доступ ИИ-краулеров. Результат будет во вкладке Technical SEO (техническое SEO), рядом с остальными показателями здоровья сайта.
Вот эта карточка для сайта NHS из аудита, который мы провели на той же неделе.
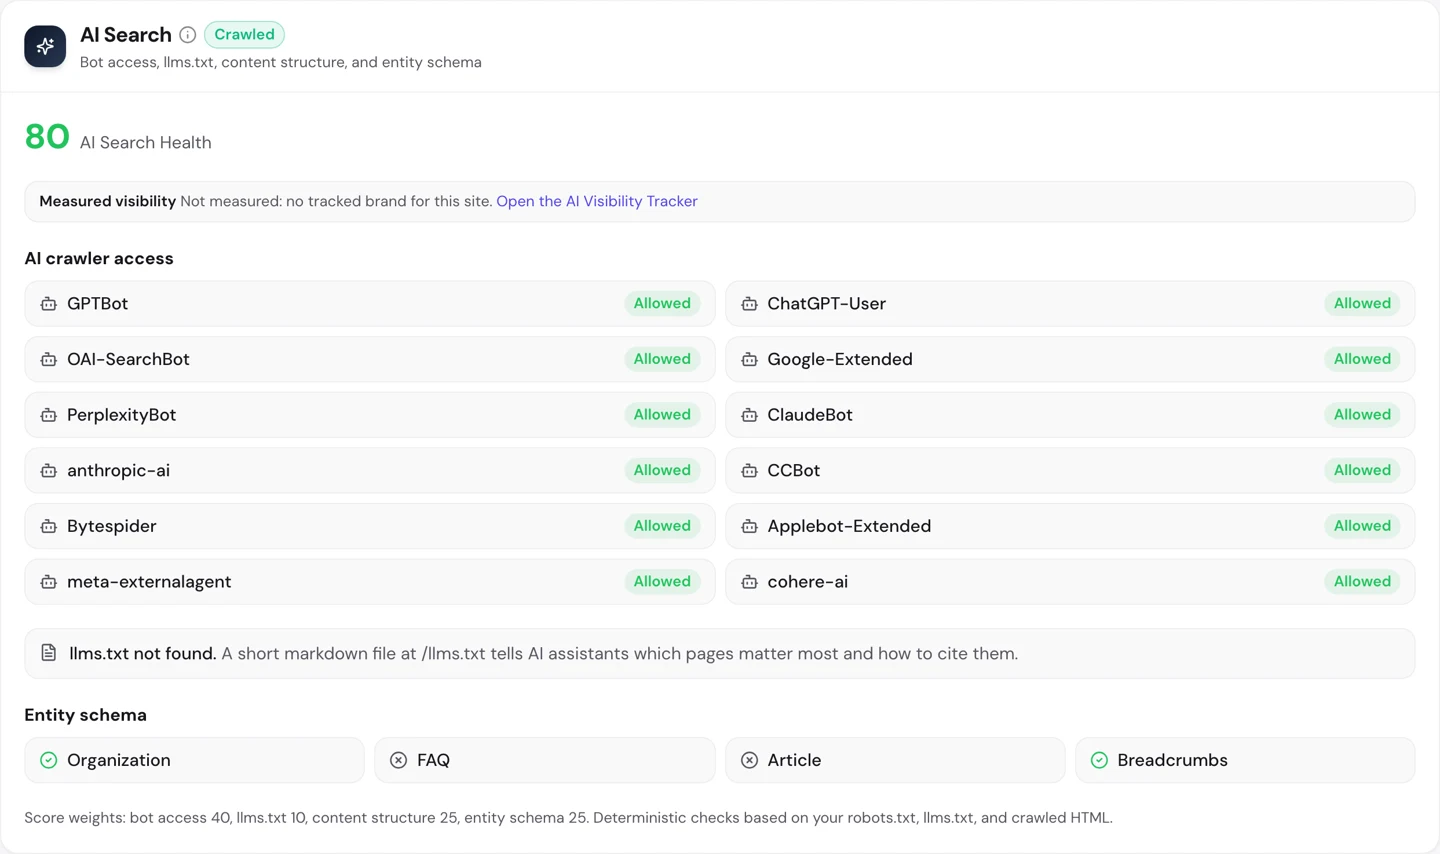
Сайт NHS пускает всех ИИ-краулеров, но llms.txt на нем пока нет.
Так что раз в несколько месяцев открывайте yoursite.com/llms.txt в приватном окне. Убедитесь, что видите обычный текст, а не веб-страницу или ошибку. А после каждого крупного изменения запускайте аудит.
Согласуйте robots.txt с llms.txt
Файл llms.txt зовет ИИ-инструменты на сайт. Но настоящие правила записаны в robots.txt. Это файл, который говорит краулерам, что им можно читать.
Как выглядит закрытая дверь, хорошо видно на примере The New York Times.
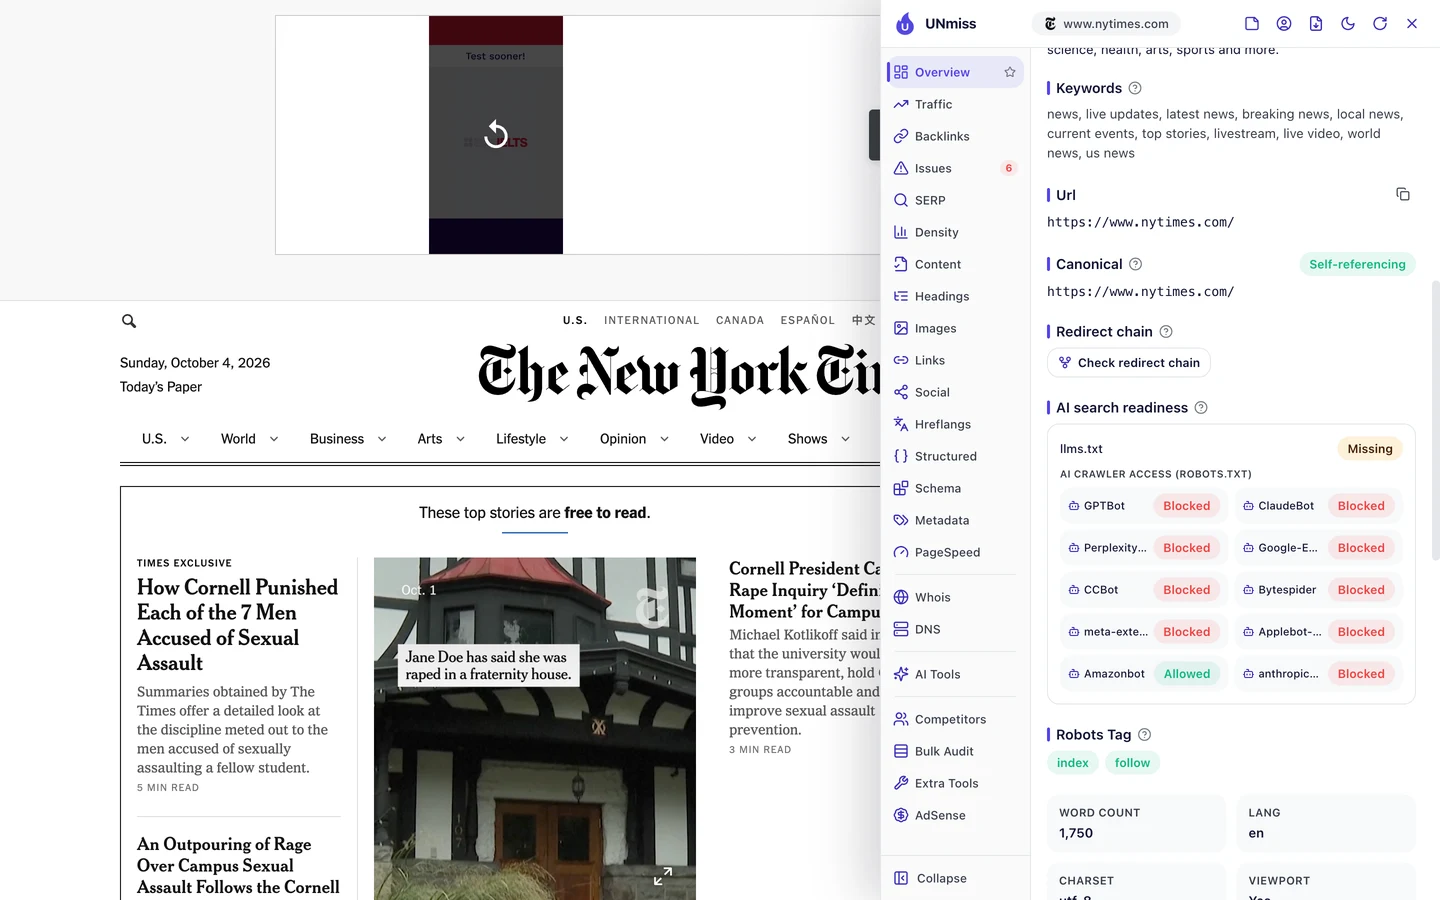
Файла llms.txt у издания нет, а его robots.txt блокирует 9 из 10 ИИ-краулеров, которых показывает наше расширение. Пройти может только Amazonbot.
Это осознанный выбор, и оба сигнала говорят одно и то же. Сразу понятно, как Times к этому относится.
Документация Stripe, как вы уже видели, открыта настежь. MDN, справочник для программистов, который мы тоже разбирали, точно так же пускает всех ИИ-краулеров.
Ошибиться легко, если подать противоречивые сигналы. У Meetup, который мы тоже разбирали, есть llms.txt, но сайт блокирует GPTBot, краулера компании, которая создала ChatGPT.
Не все ИИ-краулеры заняты одним и тем же. Одни собирают страницы, чтобы обучать ИИ-модели, а другие открывают страницу, чтобы ответить на вопрос прямо сейчас.
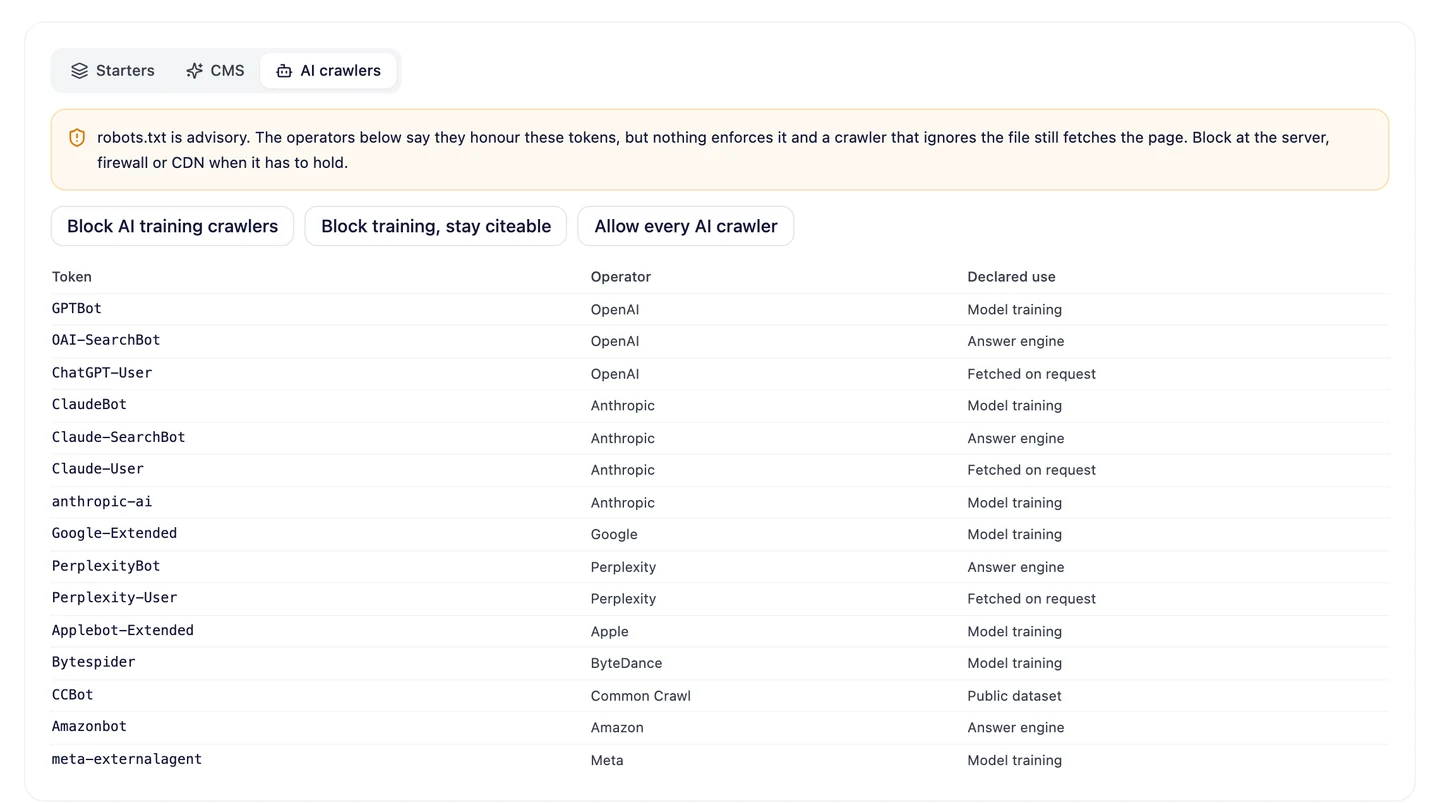
Значит, можно запретить обучение и при этом разрешить ИИ-инструментам, которые отвечают на вопросы, цитировать вас. Подробнее о том, кто какого краулера блокирует, мы рассказали в нашем исследовании robots.txt.
Так что сначала примите решение, а потом сделайте так, чтобы оба файла говорили одно и то же. Наш Robots.txt Generator пропишет правила, и для каждого варианта в нем есть готовый набор.
Большинство софтверных сайтов уже дают ИИ-инструментам путеводитель, а издатели в основном их не пускают. Мы поможем сделать выбор, а потом настроим llms.txt и robots.txt так, чтобы они не противоречили друг другу.
- Пишем короткий llms.txt на основе ваших лучших страниц
- Настраиваем правила robots.txt для каждого ИИ-краулера
- Проверяем, что файл доходит до ИИ-инструментов обычным текстом
- SEO и GEO, чтобы вас цитировали и в ответах ИИ
Считайте это дешевым экспериментом
А теперь честно. Ни одна ИИ-компания не подтвердила, что читает llms.txt так же, как поисковики читают robots.txt.
Даже среди ИИ-лабораторий нет единства. На основном сайте файл есть только у 3 из 7 проверенных, хотя в документации он есть у большинства.
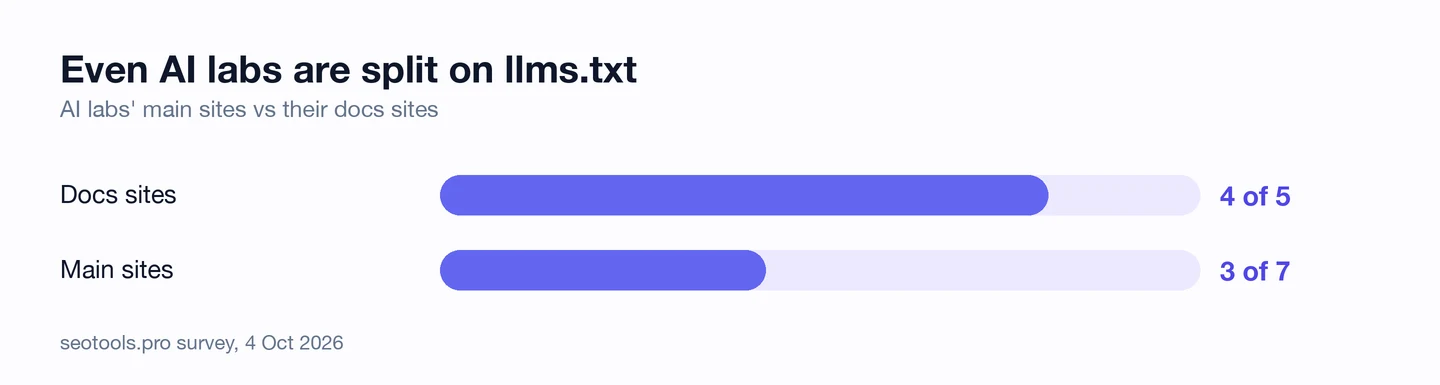
И не заводите его в надежде подняться в выдаче Google. Это записка для ИИ-инструментов, а не для Google.
Зато это дешево. Хороший файл занимает примерно страницу текста, и написать его можно за полдня.
Если ИИ-инструменты начнут его читать, вы уже готовы. Если нет, вы почти ничего не потеряли.
Когда будете проверять, смотрите не только на упоминания, но и на ссылки. В другом нашем исследовании ИИ-цитирования мы заметили, что ИИ-инструменты раз за разом называют бренды, но не ставят на них ссылки.
Так что заведите файл, запишите дату и следите за изменениями. Наш инструмент «Проверка видимости в ИИ» показывает, упоминают ли вас ИИ-инструменты, и вы сможете сравнить, что было до и что стало после.
Stripe и The New York Times мы проверяли в этой же панели. Наше расширение для браузера показывает, есть ли у сайта llms.txt и каких ИИ-краулеров пускает его robots.txt.
- Та же ИИ-панель, которой мы пользовались в этом исследовании
- Доступ открыт или закрыт для каждого крупного ИИ-краулера
- Проверяйте и сайты конкурентов
Что повторить не получится
Сначала о том, что скопировать нельзя. Это документация, которую люди и так читают каждый день.
В файлах Stripe, GitHub и Vercel стоят ссылки на страницы, которыми программисты пользуются постоянно. Файл не сделает ваши страницы полезными, поэтому сначала нужны сами страницы.
Теперь несколько честных замечаний о цифрах.
Мы запросили файл у каждого сайта 4 октября 2026 года. Файлы часто меняются, так что к тому времени, как вы это читаете, некоторые могут выглядеть иначе.
Мы не включали в выборку компании, которые делают SEO-софт, в том числе себя, чтобы никто не проверял собственную домашку.
Мы засчитывали файл, только если он приходил обычным текстом. 6 сайтов нам отказали, поэтому сказать, есть ли у них файл, мы не можем.
Мы проверяли корень каждого основного сайта и еще 8 сайтов документации. Компания может держать файл там, куда мы не заглядывали.
Скриншоты файлов Vercel, Twilio и Anthropic на несколько недель старше исследования. С тех пор эти файлы могли измениться.
И это 59 известных сайтов, а не весь интернет. Так что видно, как поступают крупные бренды, а не то, что работает лучше всего.
Одно число, которое стоит запомнить
32.
Именно у стольких из 59 проверенных нами сайтов есть llms.txt. Почти все они продают софт, а у сайтов документации файл встречается еще чаще.
Хорошие файлы короткие, простые, и в них много ссылок на страницы, которые отвечают на вопросы. Плохие превращаются в свалку или вообще не доходят до читателя обычным текстом.
Напишите свой файл по примеру Vercel, держите его рядом со своими ответами и проследите, чтобы robots.txt ему не противоречил.
Каждую из этих проверок можно запустить на вашем сайте и на сайтах конкурентов и своими глазами увидеть те же цифры.
Частые вопросы
Может ли llms.txt запретить ИИ-инструментам брать мой контент?
Нет. Это приглашение, а не правило. Чтобы не пустить краулера, нужен robots.txt, и даже он работает только с теми краулерами, которые сами решают его соблюдать.
Что такое llms-full.txt?
Некоторые сайты добавляют второй файл, где весь текст их документации собран в одном месте. Оставьте llms.txt коротким путеводителем, а если сделаете полный файл, поставьте на него ссылку из llms.txt.
Стоит ли возиться с ним малому бизнесу или блогу?
Стоит, если люди спрашивают ИИ-инструменты о вашей сфере. Оставьте только ключевые страницы: что вы делаете, сколько это стоит, ваши лучшие руководства и как с вами связаться.
Может ли llms.txt навредить сайту?
Сам по себе нет. Просто помните, что прочитать его может кто угодно, поэтому никогда не добавляйте в него закрытые и тестовые страницы и вообще все, что вы не показали бы незнакомцу.
Нужны ли текстовые копии моих страниц?
Нет. Некоторые сайты ставят ссылки на чистые текстовые версии каждой страницы, но обычные ссылки на страницы тоже отлично работают. Начните с простого, а текстовые копии добавьте потом, если захотите.
Как понять, что ИИ-инструмент прочитал мой файл?
Поищите в логах сервера запросы к /llms.txt. В каждом запросе указано имя посетителя, так что видно, какие ИИ-краулеры запрашивали файл и когда.
Как часто его обновлять?
Каждый раз, когда вы добавляете, переносите или удаляете важную страницу. Из-за ссылки, которая ведет на ошибку, весь файл кажется заброшенным.
Что делать, если у сайта несколько языковых версий?
Напишите файл на основном языке и добавьте короткий раздел со ссылками на каждую языковую версию. Если у каждого языка свой поддомен, заведите на каждом свой файл.