Все проверенные нами издатели закрываются от ИИ-краулеров в robots.txt, а из 41 IT-компании хоть одного краулера блокируют только 5.
В небольшом файле robots.txt сайт сообщает краулерам, то есть программам, которые обходят интернет, какие страницы им можно читать. Мы прочитали этот файл на 57 крупных сайтах и поискали в нем 18 ИИ-краулеров по именам.
Картина вышла четкая. Издатели продают свои тексты, поэтому держат их под замком.
IT-компании хотят, чтобы ИИ-инструменты их рекомендовали, поэтому оставляют дверь открытой.
Ниже 8 уроков, которые можно перенять, и то, чего повторить не выйдет.
Считайте свои тексты товаром
Начнем с общей картины. Сайт блокирует краулера, если файл закрывает от него все страницы.
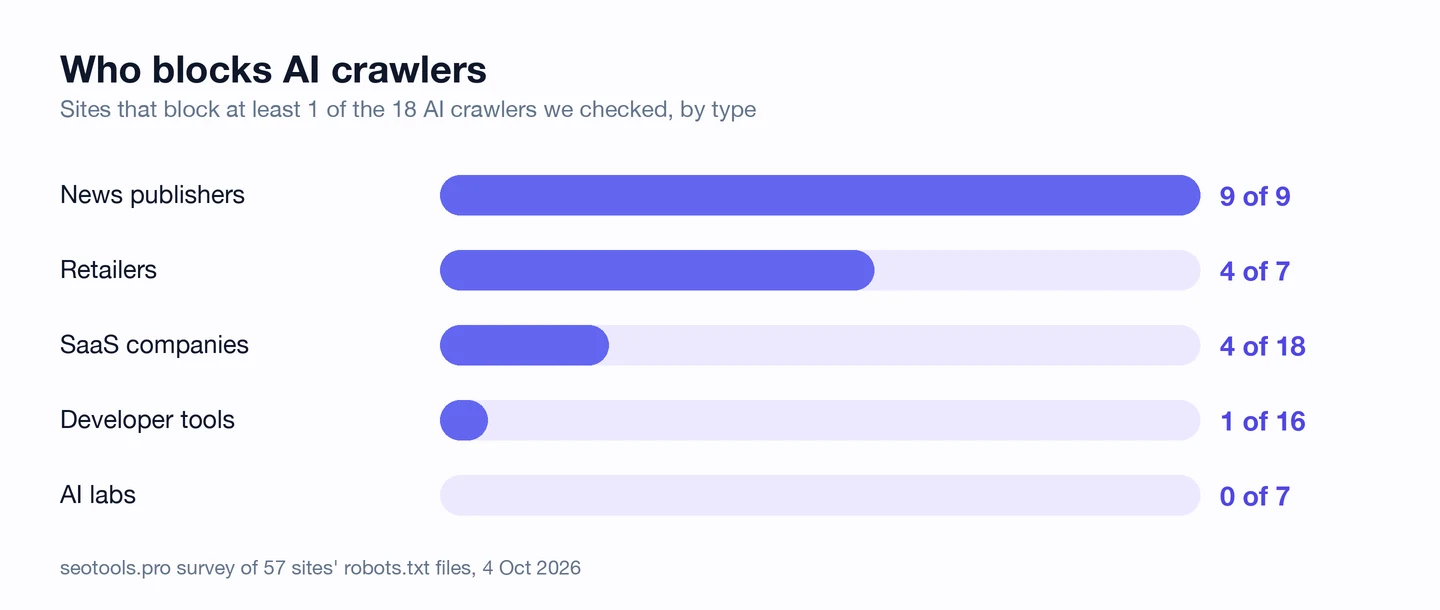
Все 9 издателей блокируют хотя бы одного ИИ-краулера. The New York Times, CNN и wikiHow блокируют по 17 из 18 краулеров, которых мы искали.
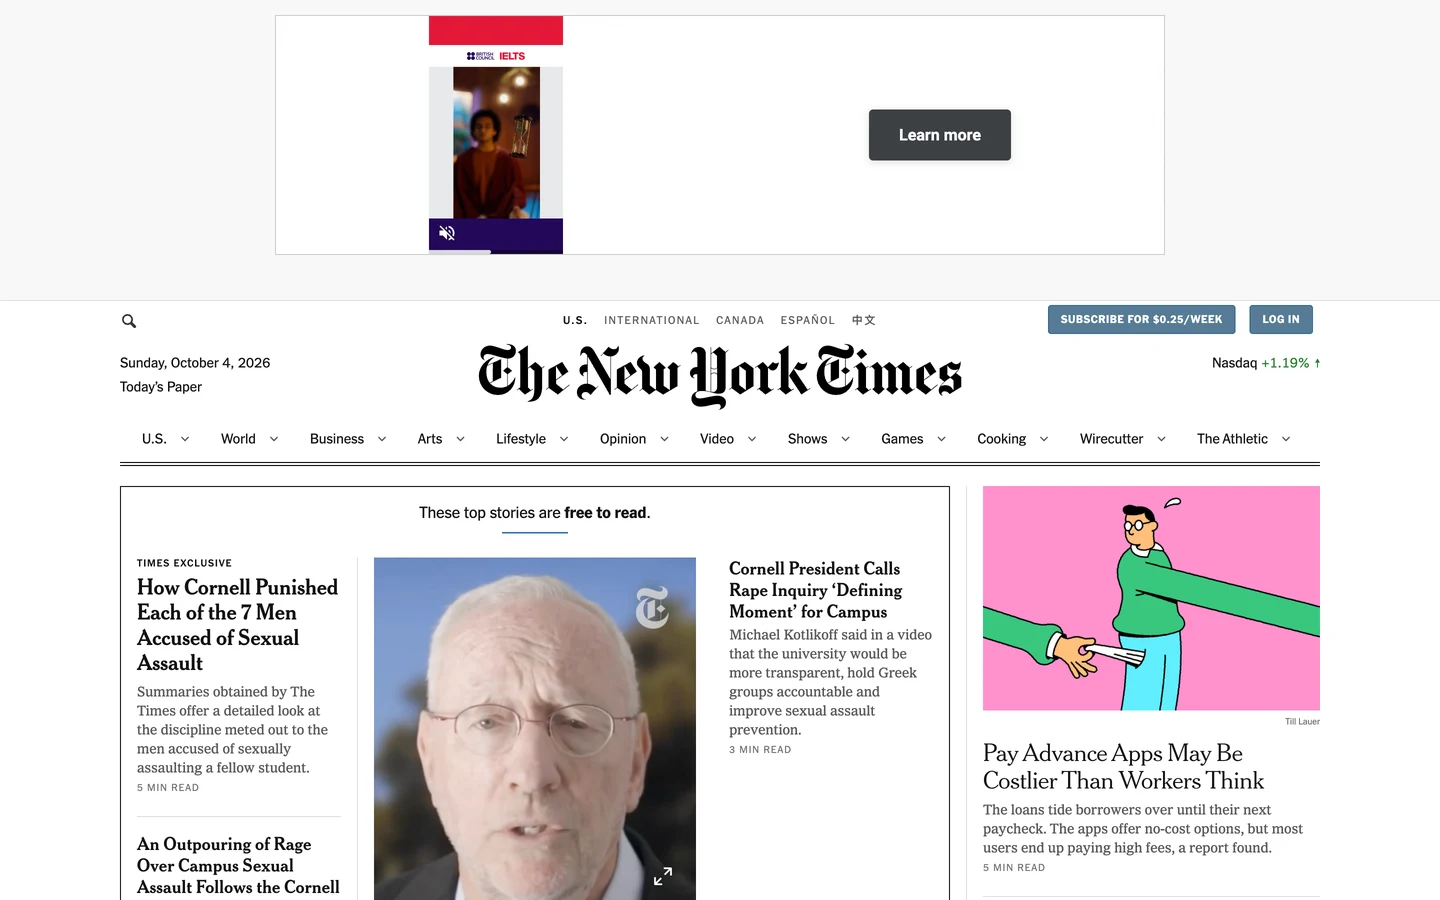
Вот что они берегут. The Times продает свои статьи, а на главной странице у нее отдельно помечены самые важные материалы, которые можно прочитать бесплатно.
Файл robots.txt у The Times начинается с понятного примечания на английском. В нем сказано, что статьи нельзя использовать для создания ИИ или больших языковых моделей без письменного разрешения.
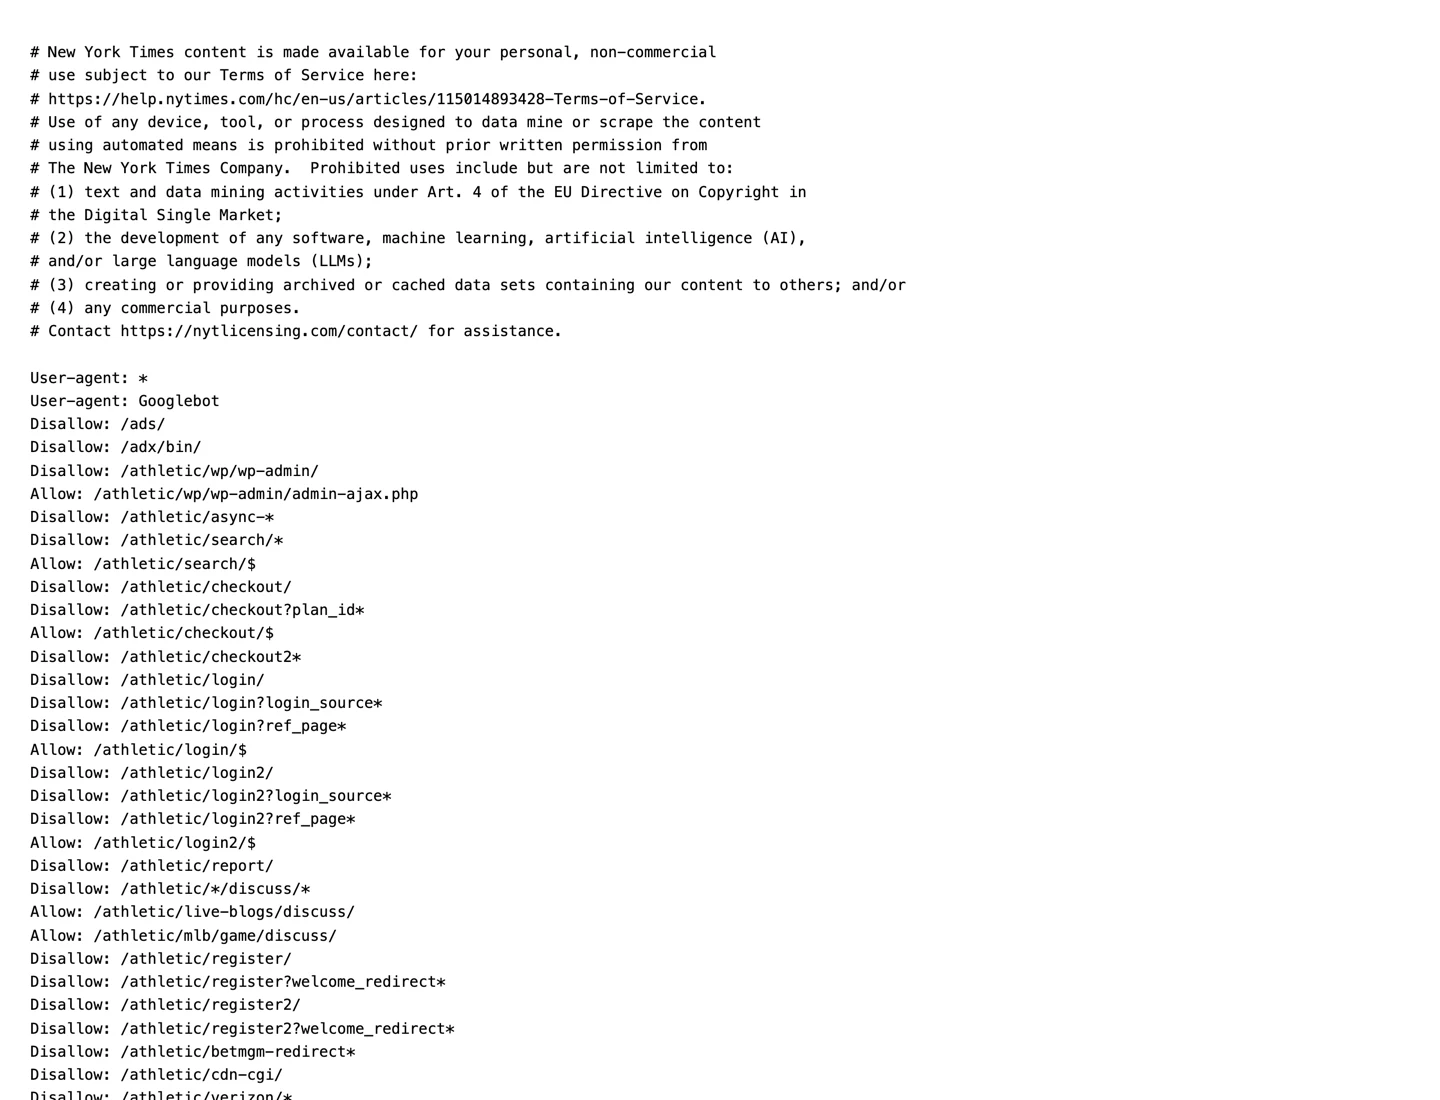
В конце примечания указан контакт для лицензирования. Проще говоря, тексты продаются.
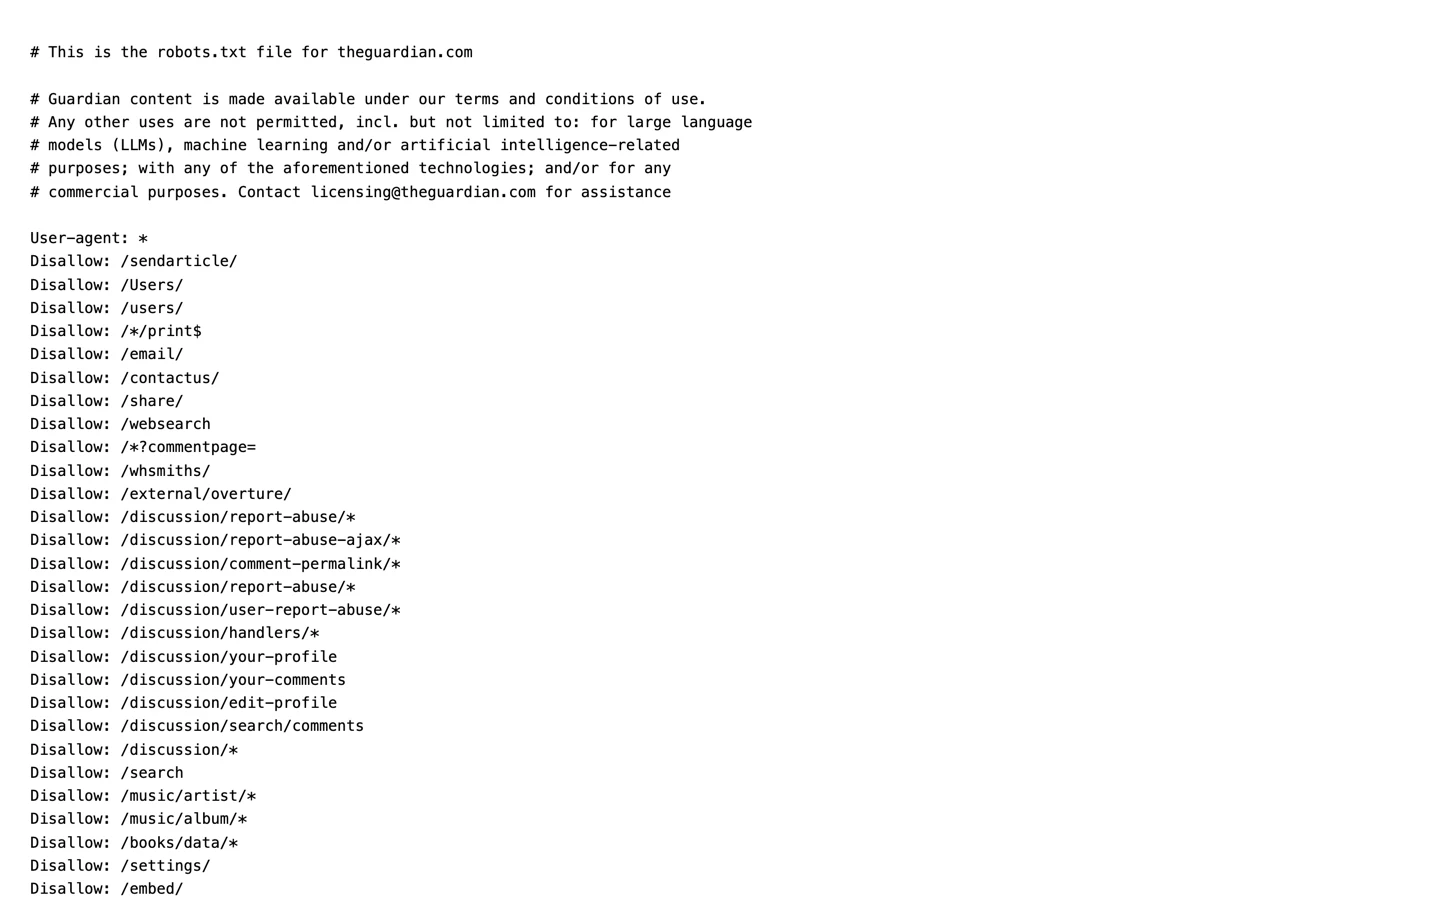
В файле The Guardian написано почти то же самое. ИИ и большие языковые модели там прямо названы среди запрещенных способов использования.
wikiHow, который мы тоже разбирали, блокирует 17 ИИ-краулеров. Healthline, еще один сайт из наших разборов, блокирует 11.
Так что если вы продаете именно тексты, не пускайте ИИ-краулеров, которые их копируют. Наш генератор robots.txt напишет эти правила за вас.
Откройте ИИ свои продающие страницы
IT-компании поступают наоборот. Из 41 проверенной компании хоть одного ИИ-краулера блокируют только 5.
Эти компании продают не тексты. Они продают продукт, а их страницы служат рекламой.
Хороший пример — главная страница Stripe. Когда кто-то спрашивает ИИ-инструмент, как принимать платежи онлайн, Stripe хочет попасть в ответ.
Наше бесплатное расширение для браузера показывает, что разрешает robots.txt сайта. Откройте любую страницу, нажмите на значок seotools.pro и прокрутите до раздела AI search readiness (готовность к ИИ-поиску).
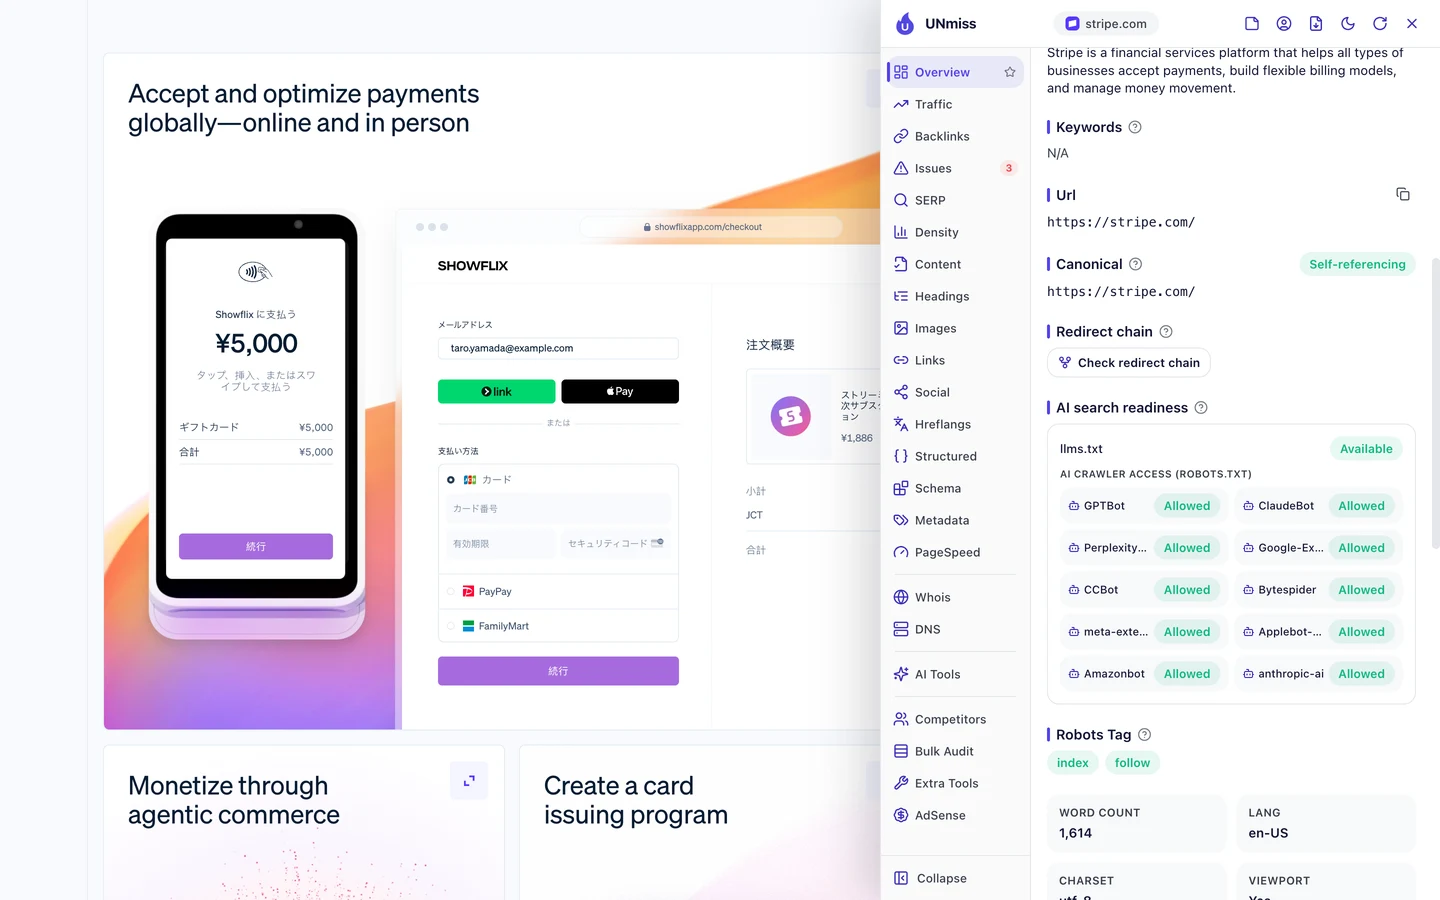
Stripe пускает все 10 краулеров из списка на панели. А еще у него есть llms.txt, короткий файл, который объясняет ИИ-инструментам, что это за сайт.
Даже ИИ-лаборатории, то есть компании, которые сами создают этих ботов, не блокируют ни одного. GitHub блокирует всего одного, Bytespider.
Figma и Canva, которую мы тоже разбирали, выбиваются из этого ряда. Они блокируют по 11 краулеров.
Правда, открытый доступ еще не гарантирует ссылку. Наше исследование ИИ-цитирований показало, что ИИ-инструменты часто называют бренд, но не ставят на него ссылку, а в исследовании llms.txt мы выясняли, у кого есть этот файл-путеводитель.
Так что если ваши страницы продают продукт, пустите к ним ИИ-инструменты. А потом проверьте в нашем инструменте «Проверка видимости в ИИ», называют ли они вас на самом деле.
Блокируйте обучение, а не ответы
ИИ-краулеры работают по-разному. Одни собирают страницы для обучения, то есть скармливают их ИИ, чтобы он на них учился.
Другие открывают страницу, чтобы ответить на вопрос прямо сейчас. Такие боты могут назвать вас, поставить ссылку и привести к вам посетителей.
Наш генератор robots.txt показывает для каждого ИИ-краулера, какая компания за ним стоит и для чего, по ее словам, он нужен.
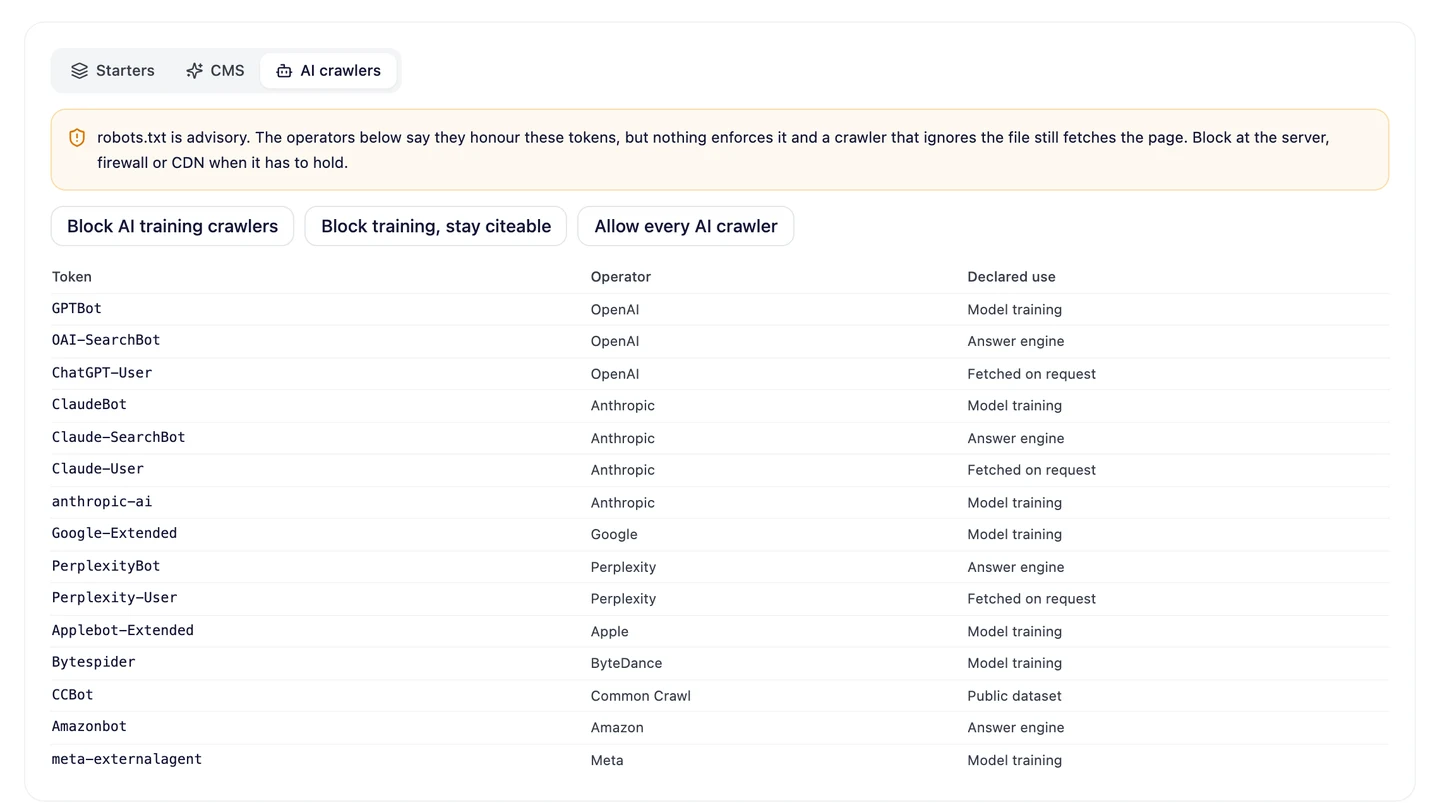
Возьмем OpenAI. GPTBot помечен как бот для обучения моделей, а OAI-SearchBot как бот для ИИ-поиска, который отвечает на вопросы.
И к этим 2 ботам сайты относятся очень по-разному. Вот сколько из 57 сайтов блокируют каждого краулера.
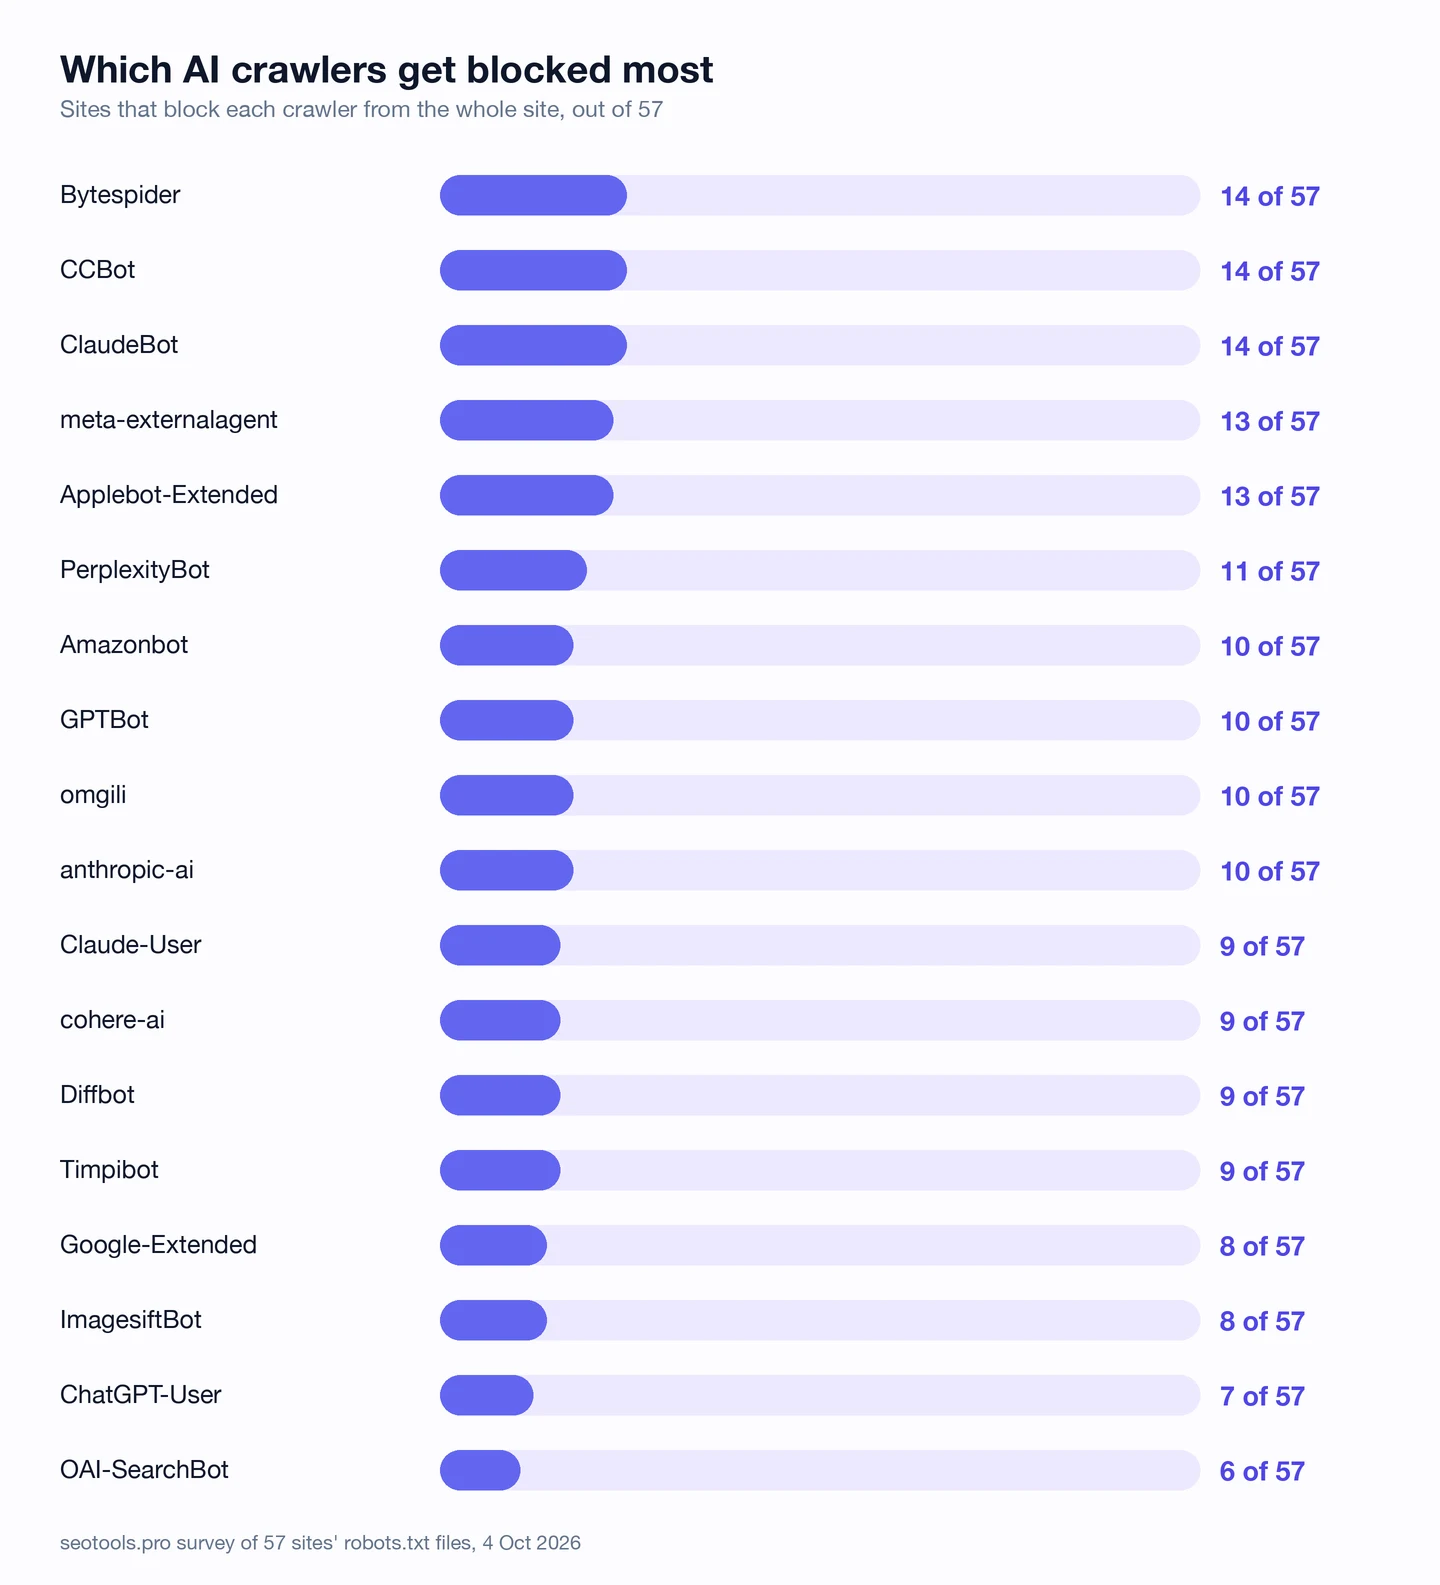
Чаще всех блокируют ClaudeBot, CCBot и Bytespider, каждого на 14 сайтах. Все 3 собирают страницы для обучения или для открытых датасетов.
Реже всех из 18 блокируют OAI-SearchBot. Его не пускают только 6 сайтов, а GPTBot блокируют 10.
Правило работает не всегда. PerplexityBot нужен для ответов, но его все равно блокируют 11 сайтов.
В генераторе есть готовый набор правил, построенный на этой идее. Он называется «Block training, stay citeable» (закрыть обучение, но остаться в цитатах). Попасть в цитаты значит, что ИИ-инструмент называет вас и ставит ссылку на вашу страницу.
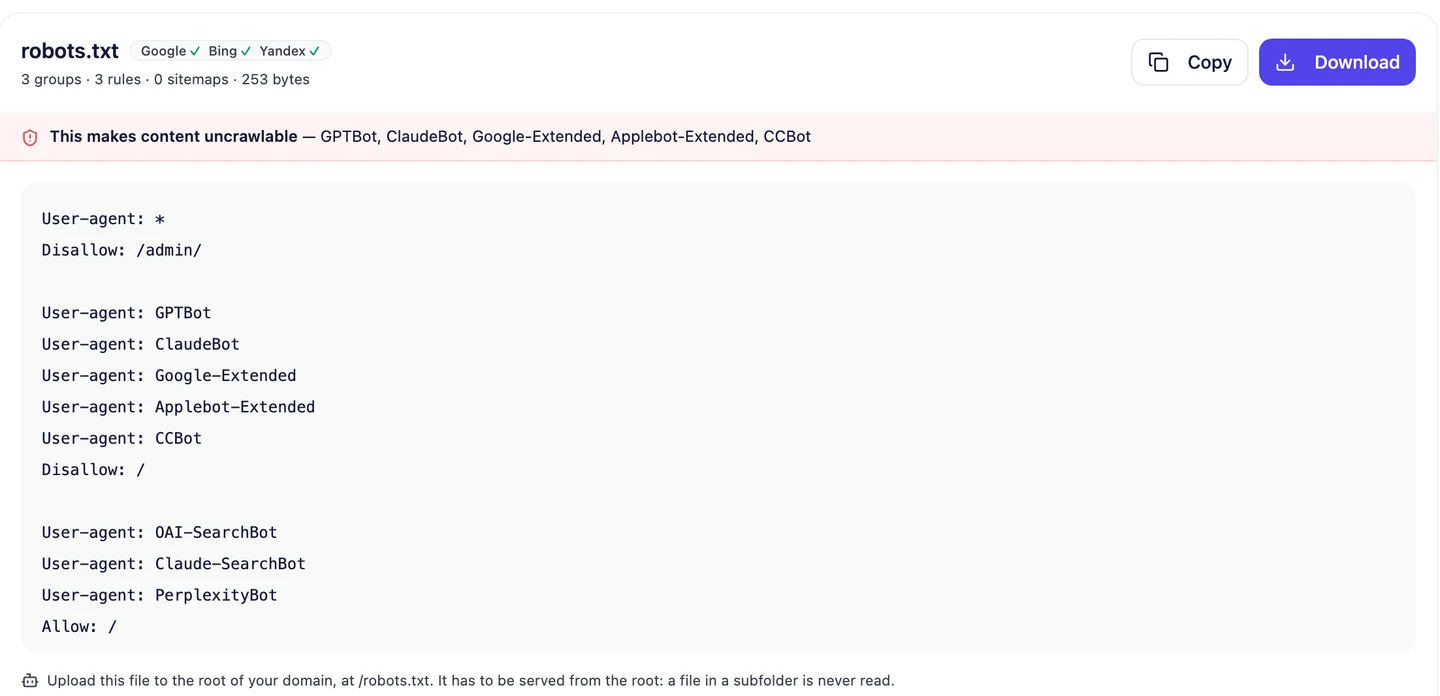
Этот набор закрывает весь сайт от 5 краулеров, среди них GPTBot и ClaudeBot, и пускает 3 бота для ответов. Весь файл умещается в 3 короткие группы.
Так что, если хотите, не отдавайте свои страницы на обучение, но пусть боты для ответов их читают. Выберите этот набор в нашем генераторе robots.txt и скопируйте файл.
Издатели закрываются от ИИ-краулеров, а IT-компании их пускают. Мы определим, какой путь подходит вашему сайту, настроим правила для каждого бота и поможем сделать так, чтобы ИИ в ответах называл вас и ссылался на ваш сайт.
- Проверяем, каких ИИ-краулеров ваш сайт блокирует сейчас
- Пишем правила, которые не пускают ботов для обучения и пускают ботов для ответов
- Следим, называют ли вас ИИ-инструменты и ссылаются ли на вас
- SEO и GEO, чтобы вас находили и в Google, и в ответах ИИ
Решайте по каждому боту отдельно
Даже издатели блокируют не всех ботов. Посмотрите, скольких не пускает каждый из них.
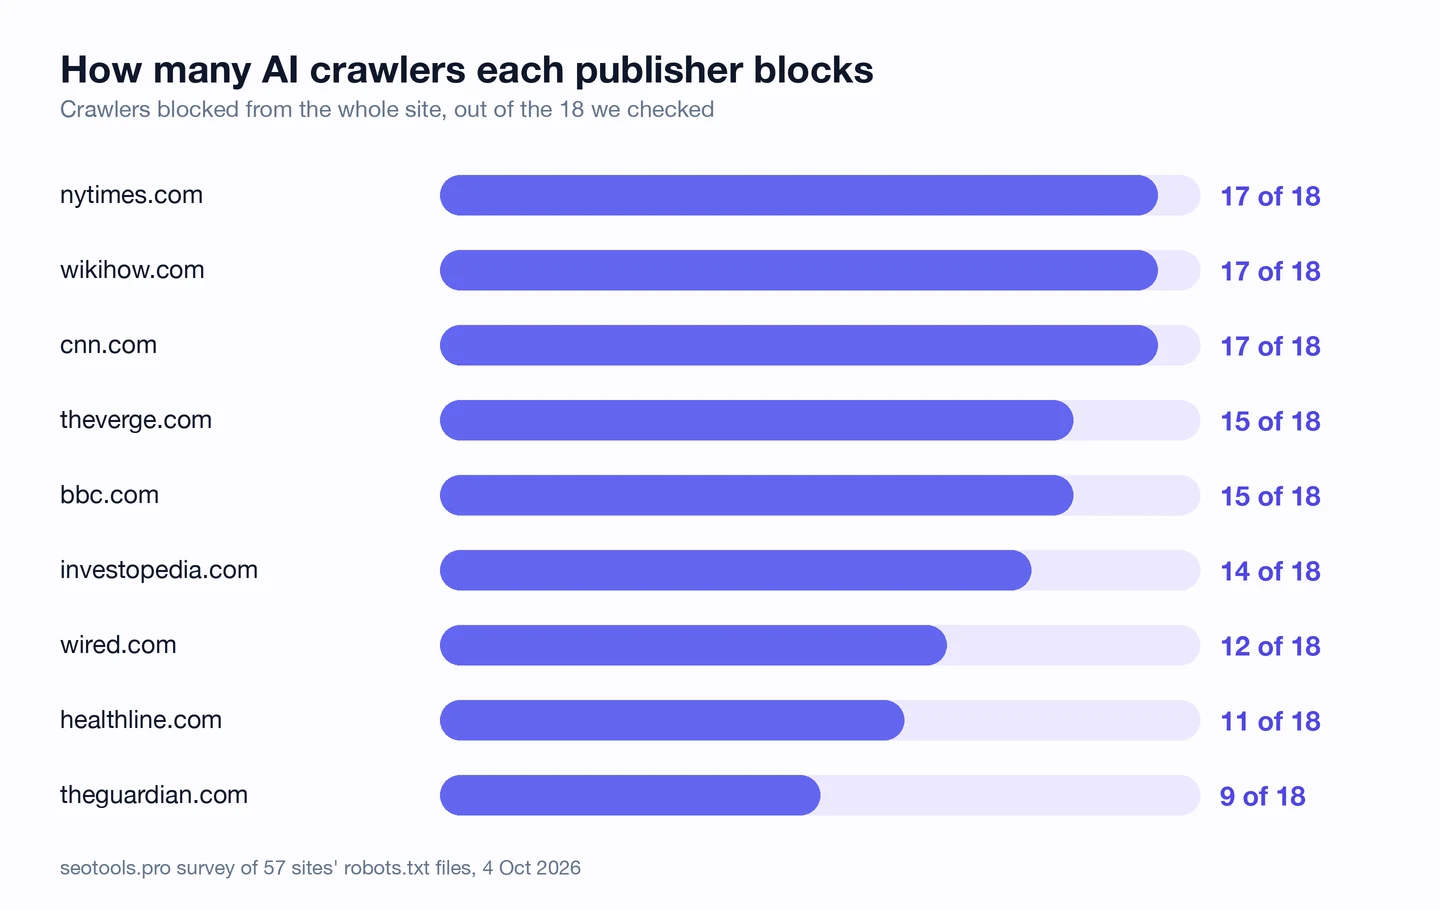
Первые 3 блокируют по 17 из 18. The Guardian блокирует всего 9.
Пробелы похожи на осознанный выбор, а не на забывчивость. Investopedia блокирует 14 краулеров, но не трогает 3 краулера OpenAI, хотя все 3 упомянуты в ее файле.
The Guardian блокирует ботов Anthropic и Perplexity. А ботов OpenAI и Google не трогает.
Снаружи причин не видно. Но ясно, что каждому боту отвечают «да» или «нет» отдельно.
Вот как это делается в файле. В строке User-agent указывают имя, под которым представляется бот, и над одним правилом можно перечислить сразу много имен.
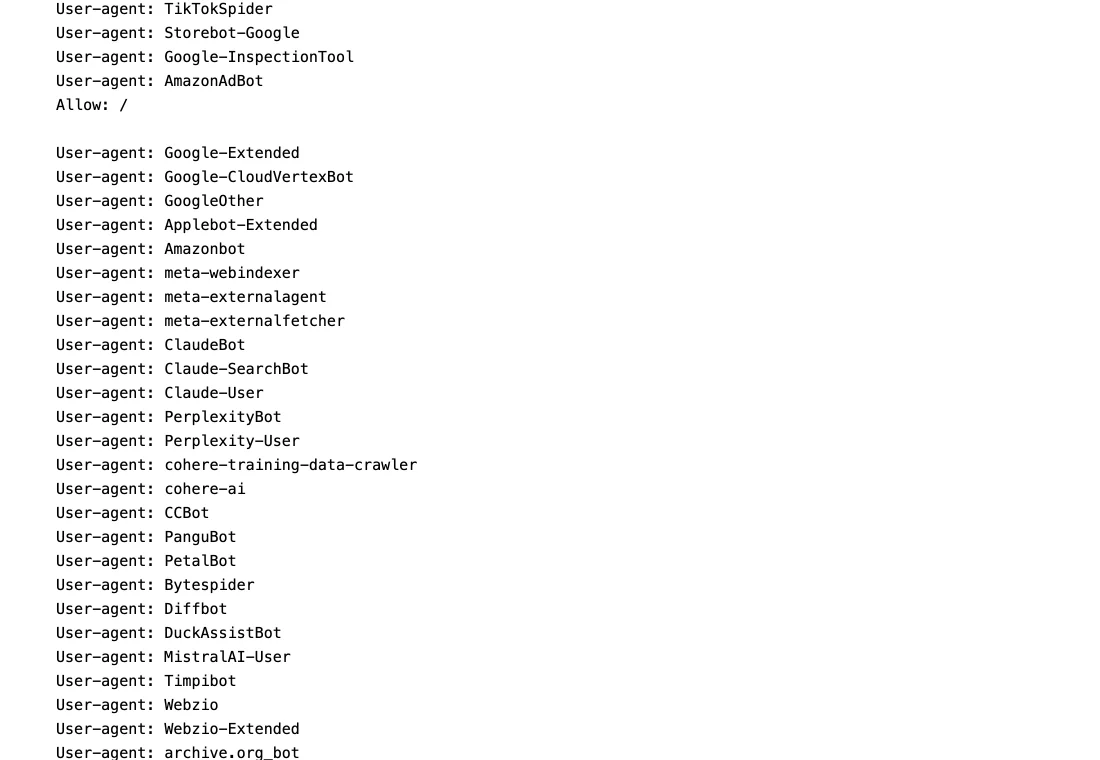
Wired собирает в одну группу целый список ИИ-краулеров. По нашим данным, он блокирует 12 из 18 краулеров, которых мы искали.
Так что решайте по каждому боту, а не по принципу «все или ничего». Наш генератор robots.txt показывает задачу каждого бота, так что вы будете знать, кому именно отказываете.
Решите, что ИИ увидит в магазине
Магазины где-то посередине. Из 7 проверенных ритейлеров хотя бы одного ИИ-краулера блокируют 4.
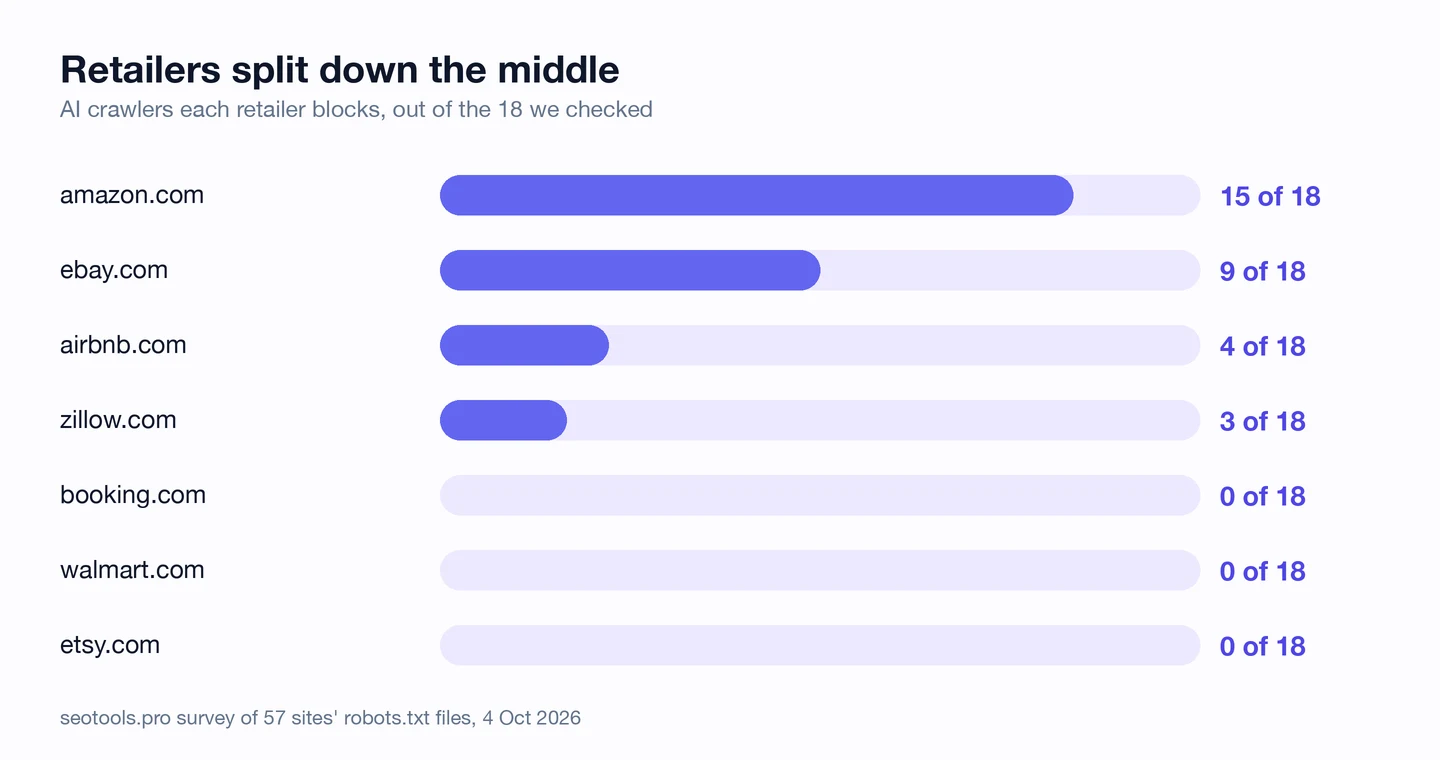
Amazon блокирует 15 из 18. Но собственного краулера, Amazonbot, не трогает.
eBay блокирует 9. Walmart, Etsy и Booking.com не блокируют вообще никого.
Подумайте, о чем покупатель спрашивает ИИ-инструмент, например «what's a good tent for a beginner?» (какую палатку взять новичку). Если ваши правила не пускают ботов для ответов, ваших палаток в этом ответе не будет.
У Amazon свой краулер и свой огромный магазин, поэтому он может позволить себе отказать. А большинству магазинов важен каждый ответ, в который они могут попасть.
Так что если вы что-то продаете, откройте ботам для ответов страницы товаров. А чтобы они нашли каждый товар, сделайте карту сайта, то есть файл со списком всех страниц, в нашем «Генераторе XML-карты сайта».
Не путайте упоминание с блокировкой
Вот ловушка, в которую легко попасть. Во многих файлах ИИ-краулеры упомянуты, но вовсе не заблокированы.
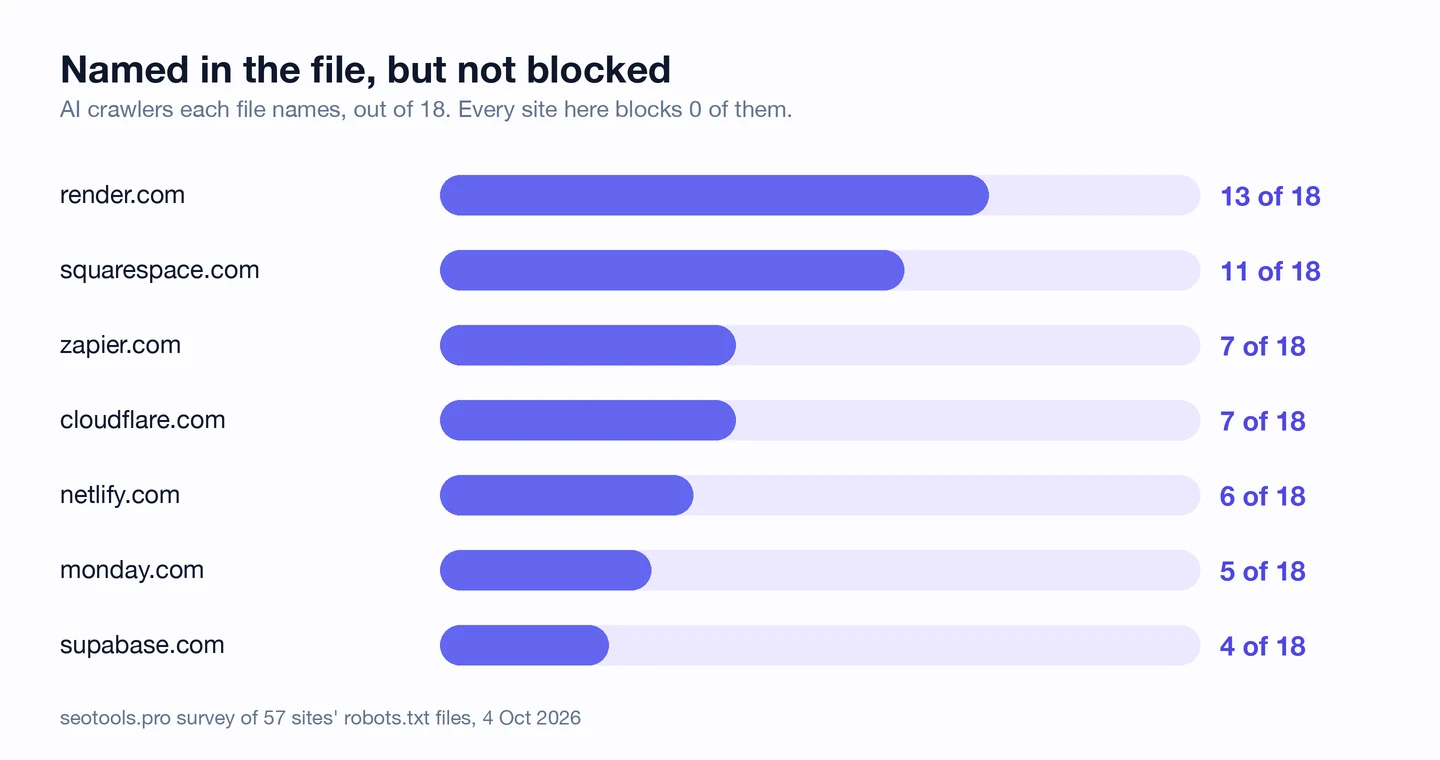
В файле Render упомянуты 13 ИИ-краулеров. Заблокированных среди них 0.
Zapier, который мы тоже разбирали, упоминает 7 и не блокирует ни одного. Squarespace, Netlify и еще несколько сайтов поступают так же.
Имя в файле может значить что угодно. Оно может стоять над правилом для одной папки, над строкой Allow или вообще внутри комментария.
Закрыть боту доступ ко всему сайту может только одно правило. Это Disallow: / под именем бота, и оно значит «не заходи ни на одну страницу».
Так что читайте правило под каждым именем, а не только само имя. Панель ИИ-краулеров в нашем расширении для браузера прочитает правила за вас и пометит каждого бота как Allowed (разрешен) или Blocked (заблокирован).
Делайте аудит файла раз в квартал
Файлы меняются, а новые ИИ-краулеры появляются постоянно. Поэтому проверяйте свой файл и файлы конкурентов каждые 3 месяца.
Быстрее всего проверить через расширение. Откройте сайт, нажмите на значок seotools.pro и посмотрите раздел AI search readiness.
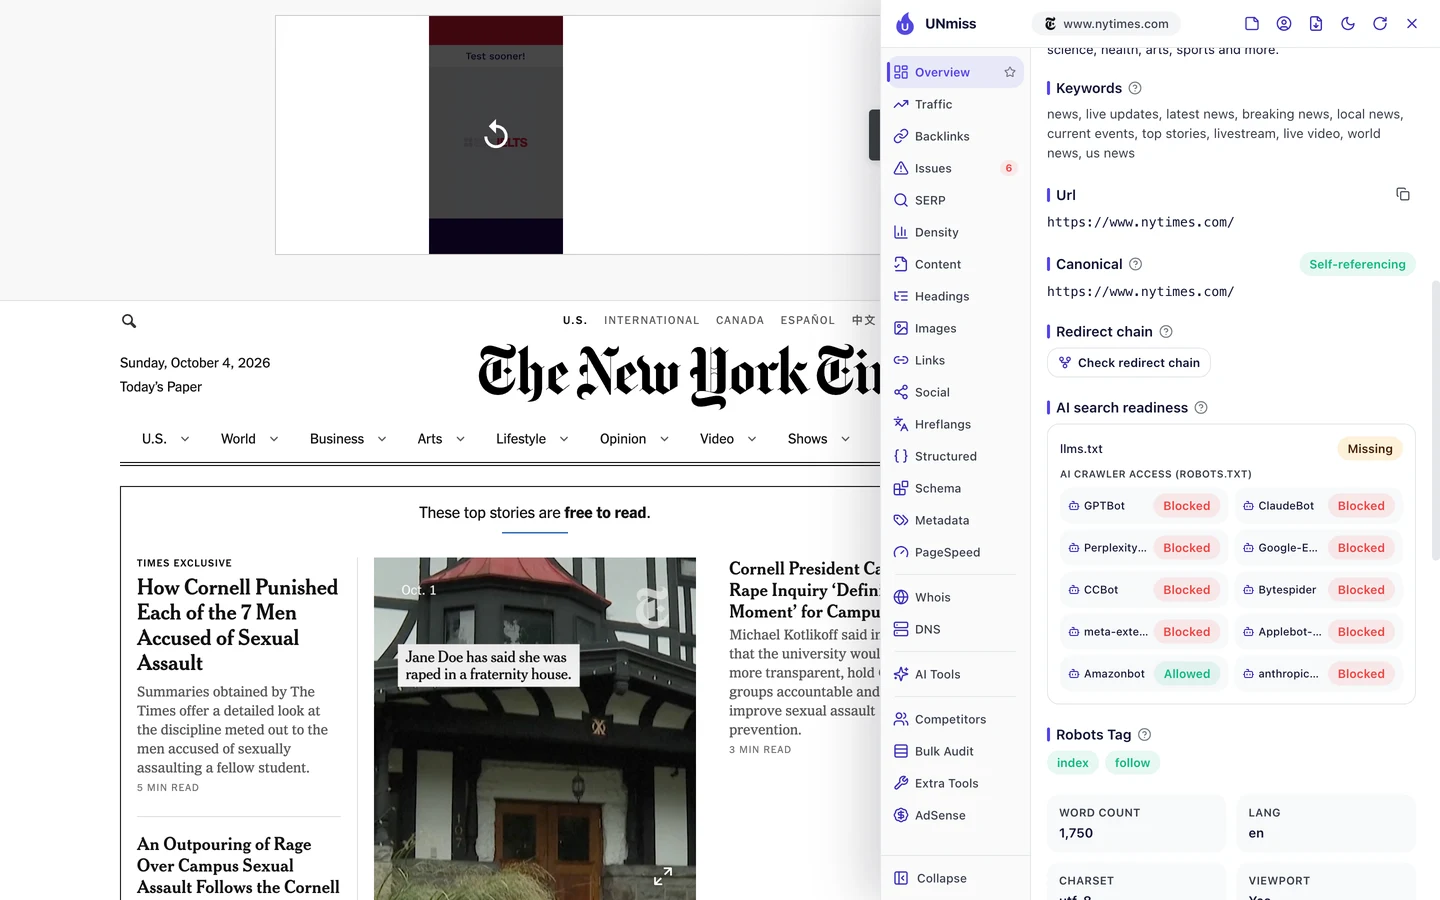
На сайте New York Times 9 из 10 ботов отмечены как Blocked. Только Amazonbot помечен как Allowed.
А еще панель показывает, что llms.txt нет. Stripe, наоборот, пускает всех ботов, и файл у него есть.
Теперь проверьте так же свой сайт. Не заблокировали ли вы по ошибке бота для ответов?
Потом поищите пробелы. Не забыли ли вы внести в список какого-то нового краулера?
Для всего сайта запустите наш Аудит сайта. Его вкладка Technical SEO (техническое SEO) показывает доступ ИИ-краулеров рядом с остальными проверками состояния сайта.
Вот как эта карточка выглядит для сайта NHS в аудите, который мы провели на той же неделе.
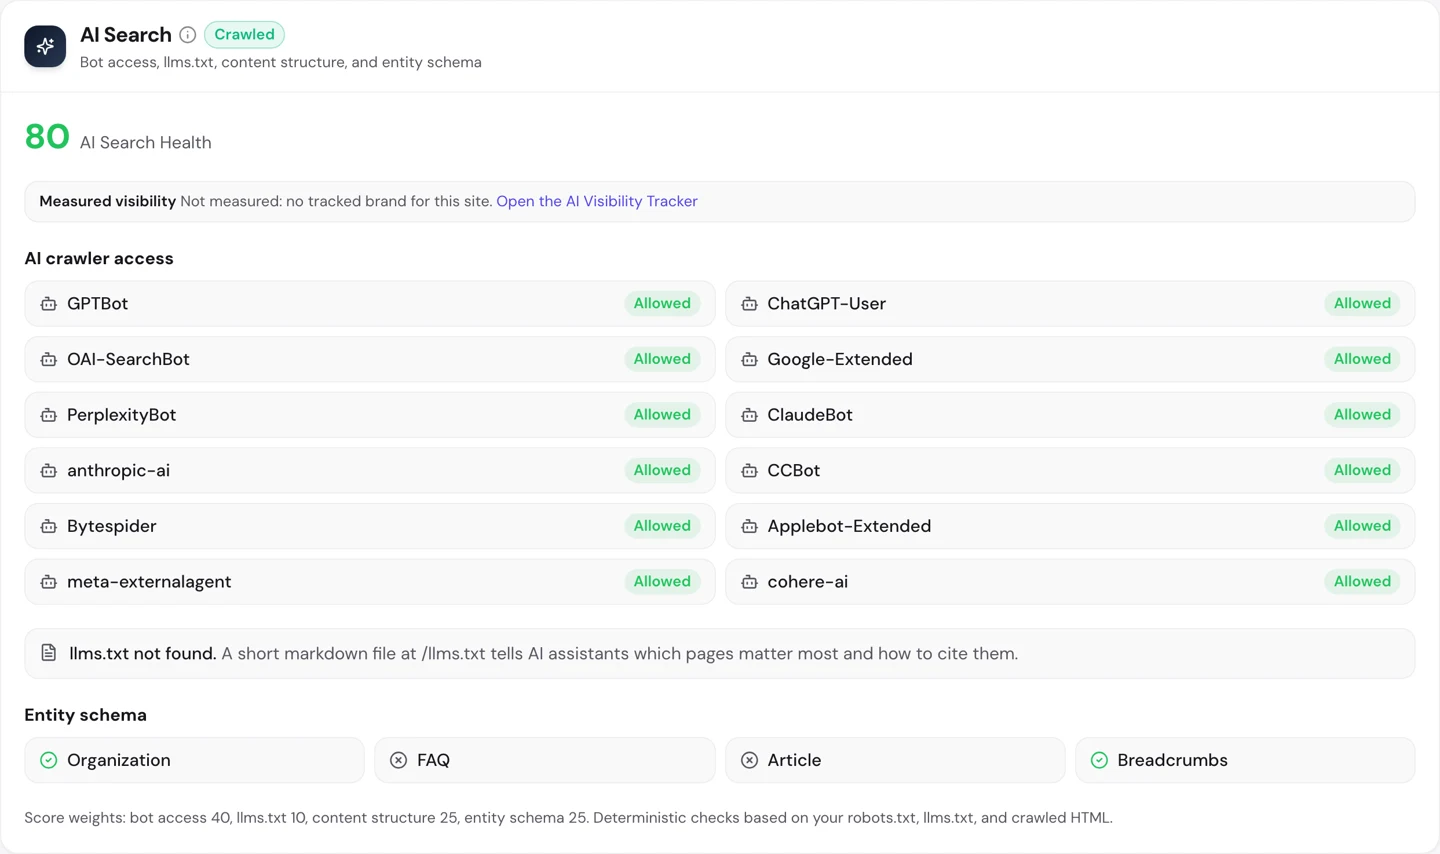
Карточка показывает, допущен или заблокирован каждый ИИ-краулер, и заодно проверяет llms.txt.
Так что поставьте себе в календарь проверку каждые 3 месяца. Запускайте наш Аудит сайта для своего сайта, а расширение для сайтов конкурентов.
Будьте готовы к непослушным ботам
И последнее, что нужно знать. Файл robots.txt работает как просьба, а не как замок.
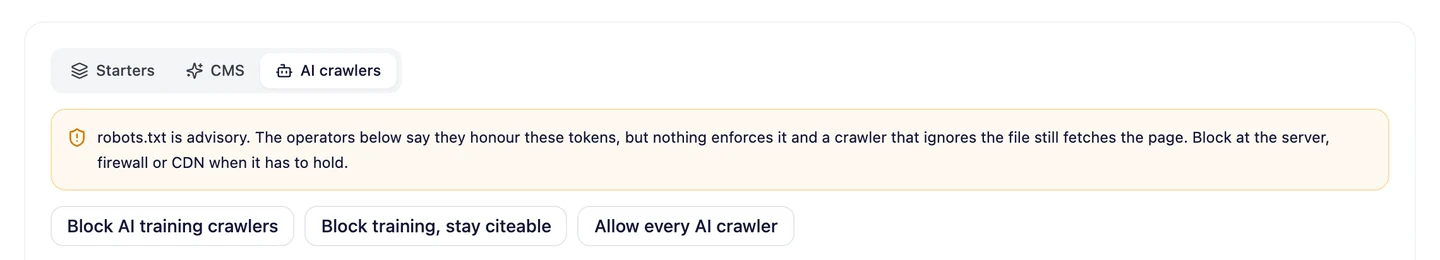
Наш генератор пишет об этом прямо вверху. Крупные ИИ-компании говорят, что соблюдают файл, но ничто не заставляет краулера ему подчиняться.
Бот, который игнорирует файл, все равно может загрузить любую страницу. Так что если страница должна остаться закрытой, одного robots.txt мало.
Для этого заблокируйте бота еще и на сервере или в файрволе. Обычно с настройкой может помочь ваш хостинг.
Так что пишите понятные правила в нашем генераторе robots.txt, а для ботов, которых точно нельзя пускать, добавьте правило в файрвол.
Все проверенные нами издатели блокируют ИИ-краулеров, а большинство IT-компаний нет. Наше расширение для браузера читает robots.txt любого сайта и помечает каждого ИИ-краулера как Allowed или Blocked, так что вы сразу видите, как обстоят дела у вас.
- Та же панель ИИ-краулеров, которой мы проверяли New York Times и Stripe
- Заодно проверяет, есть ли файл llms.txt
- Запускайте ее и на сайтах конкурентов
Что повторить не получится
Сначала о том, чего не скопировать. У The New York Times знаменитое имя и огромный архив, поэтому она может отказать ИИ-инструментам, и ее все равно будут читать.
Stripe может пускать всех ботов по противоположной причине. Он продает софт, поэтому ничего не теряет, когда ИИ читает его страницы.
Большинство сайтов где-то посередине. Поэтому выбор за вами.
Теперь несколько честных замечаний о цифрах.
Все файлы мы прочитали 4 октября 2026 года. Файлы robots.txt могут поменяться в любой день, так что при повторном подсчете цифры могут отличаться.
В подсчет вошли 57 сайтов, и мы искали в них 18 ИИ-краулеров по именам. Еще 2 сайта не ответили, поэтому мы их не учитывали.
Еще мы не включили компании, которые делают SEO-софт, в том числе нашу, чтобы никто не ставил оценки сам себе.
Мы считали, что сайт блокирует краулера, только если файл закрывает от него весь сайт. Правила для одной папки не в счет.
Скриншоты самих файлов New York Times, Guardian и Wired сделаны раньше, во время августовской проверки. А все подсчеты октябрьские.
На панели расширения 10 ИИ-краулеров, а в исследовании мы искали 18. Поэтому панель может показывать меньше блокировок, чем наши диаграммы.
И наконец, robots.txt показывает только то, о чем просит сайт. Слушаются ли его боты на самом деле, по нему не понять.
Одно число, которое стоит запомнить
9 из 9.
Столько проверенных нами издателей блокируют ИИ-краулеров. Их тексты и есть товар, поэтому они их берегут.
IT-компании пошли другим путем, и хоть кого-то блокируют только 5 из 41. Им важнее попасть в ответ.
Ваш выбор сводится к одному вопросу. Вы продаете сами страницы или продаете с их помощью?
Любую из этих проверок можно запустить для своего сайта и сайтов конкурентов, чтобы своими глазами увидеть такие же цифры.
Частые вопросы
Не упадут ли мои позиции в Google, если заблокировать ИИ-краулеров?
Нет. Googlebot, краулер поиска Google, работает отдельно от Google-Extended. Google говорит, что блокировка Google-Extended не влияет на позиции ваших страниц.
Исчезнут ли мои страницы из ИИ-моделей, которые их уже прочитали?
Нет. Блокировка действует только на будущие заходы. Все, что модель узнала до появления правила, в ней и останется.
Можно ли закрыть от ИИ-краулеров только часть страниц?
Да. Добавьте под именем бота правило Disallow для одной папки, например с платными статьями. Остальной сайт останется открытым.
Будут ли ИИ-инструменты упоминать меня, если я их заблокирую?
Могут, опираясь на то, что пишут о вас другие сайты. Но ваши собственные страницы они прочитать не смогут, а значит, не смогут их процитировать или поставить на них ссылку.
Как быстро боты замечают изменения в robots.txt?
Большинство крупных краулеров перечитывают файл часто, обычно примерно в течение суток. Подождите немного, прежде чем смотреть логи сервера.
Где должен лежать файл robots.txt?
В корне домена, например yoursite.com/robots.txt. Копию в подпапке боты никогда не читают, а каждому поддомену нужен свой файл.
Нужен ли llms.txt, если robots.txt уже пускает ИИ?
Это по желанию. Robots.txt говорит, что ботам можно читать, а llms.txt дает ИИ-инструментам короткий путеводитель по вашим лучшим страницам.
А что делать с ИИ-ботами, которые не называют себя?
Robots.txt не может остановить бота, который скрывает, кто он. Подозрительных посетителей видно в логах сервера, а заблокировать их может ваш хостинг или файрвол.