PyPI щомісяця залучає з Google у США близько 153 000 відвідувань, і все завдяки простій сторінці для кожного пакета Python, названій саме так, як програмісти пишуть у пошуку.
Саме в PyPI, каталозі Python Package Index, програмісти беруть пакети, тобто готові доповнення до мови Python. У кожного пакета є власна сторінка.
Ми перевірили PyPI усіма нашими SEO-інструментами. Ми з’ясували, чому ці сторінки виходять у топ і як PyPI стежить, щоб численні старі копії їм не заважали.
Ось 9 уроків, які можна перейняти, і те, чого повторити не вийде.
Створіть сторінку для кожного пакета
Почали ми з нашого інструмента «Перевірка органічного трафіку». Він оцінює органічний трафік сайту, тобто скільки людей знаходять його в Google без реклами.
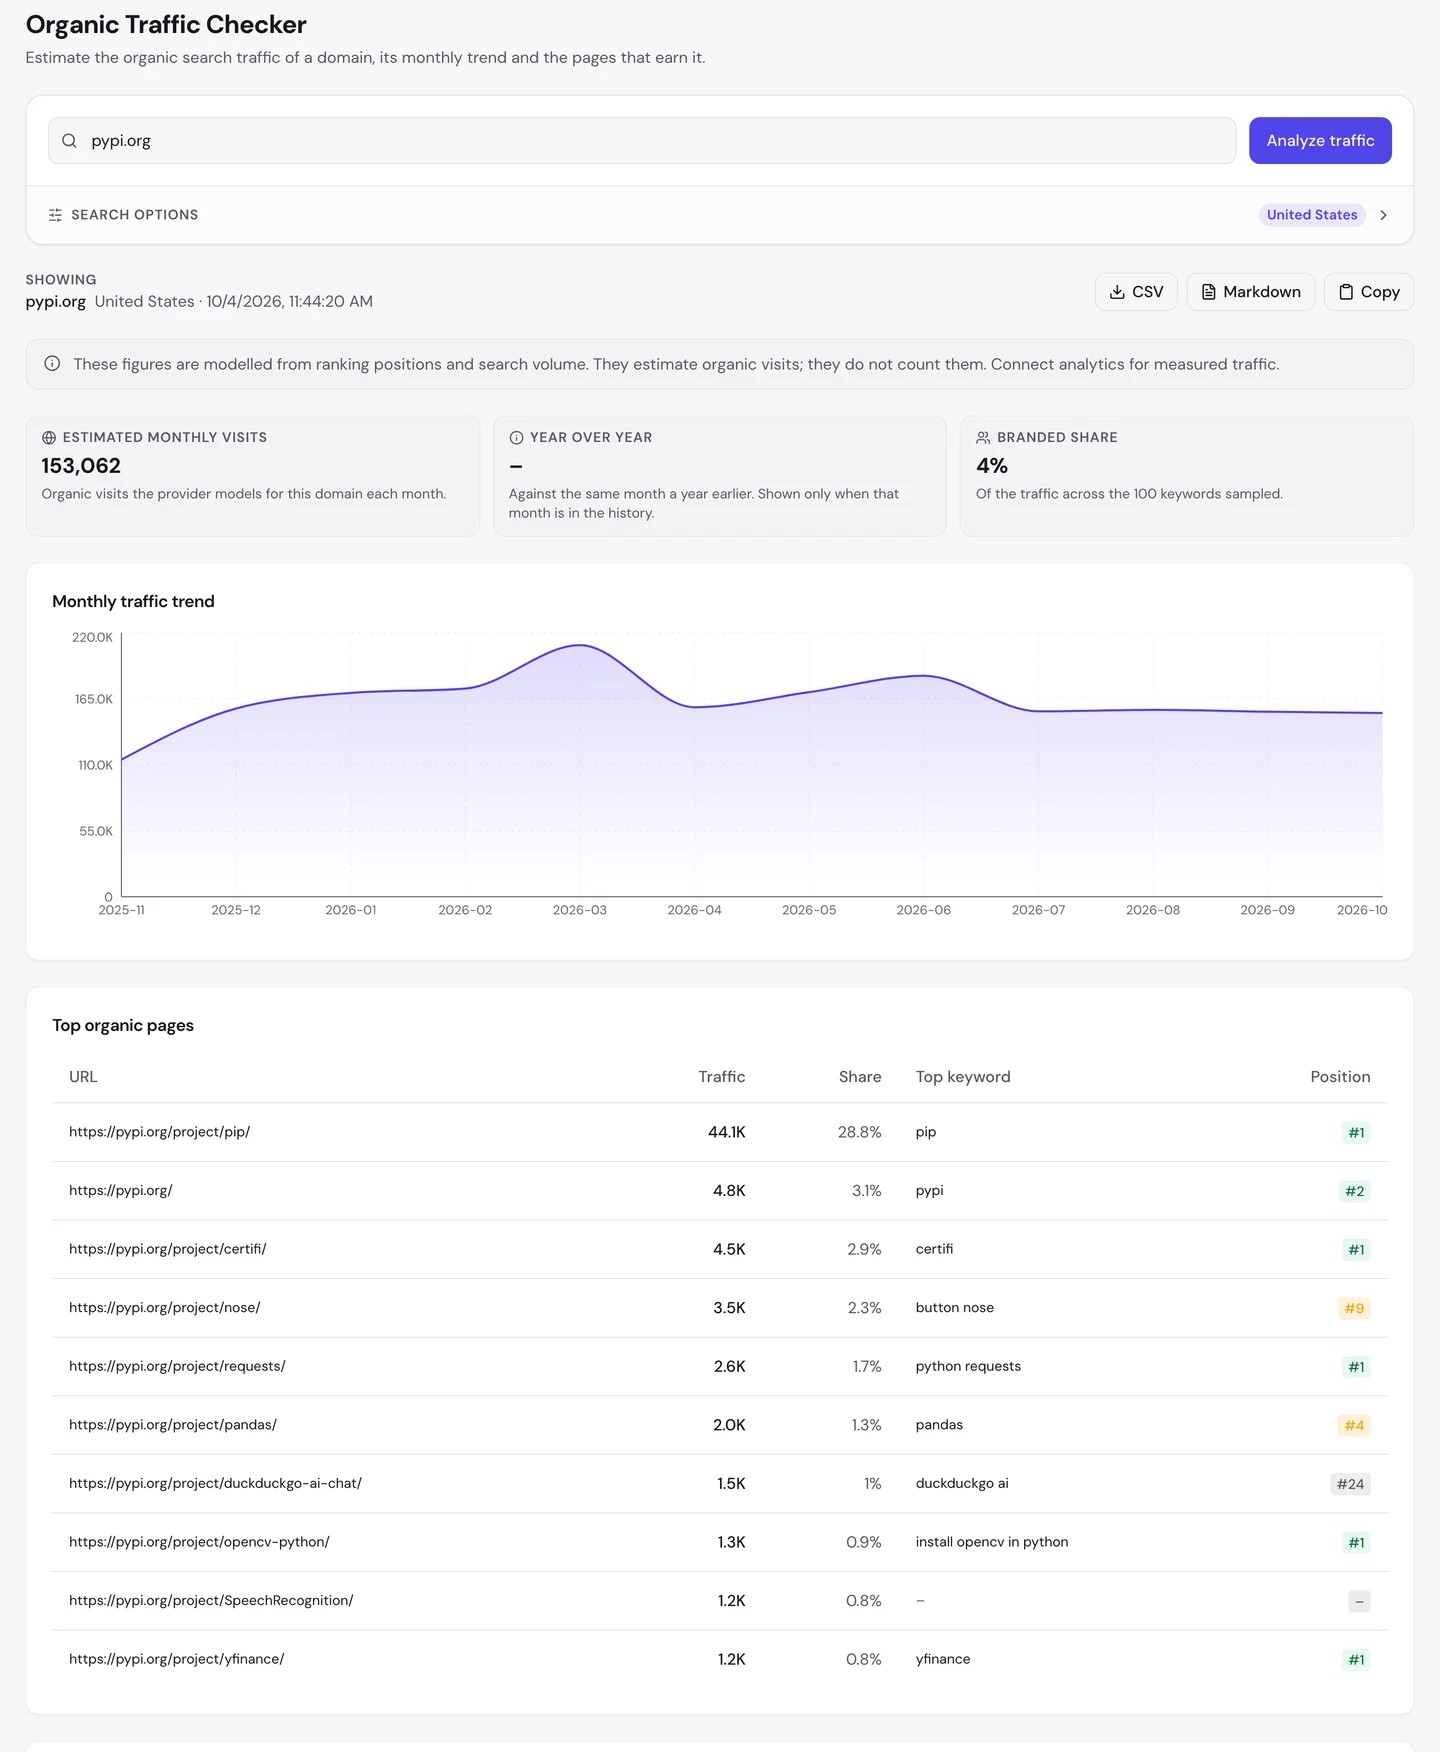
Для pypi.org це близько 153 тис. відвідувань на місяць у США. Лише 4% із них припадає на людей, які вводять назву PyPI.
Тобто приблизно 24 з 25 відвідувачів зовсім не шукали PyPI. Вони ввели назву пакета, і Google привів їх на сторінку цього пакета.
Одна сторінка помітно вирізняється. Сторінка pip залучає близько 44 тис. відвідувань, тобто майже 1 з 3 усіх відвідувань.
За допомогою pip програмісти встановлюють пакети. Ось його сторінка.
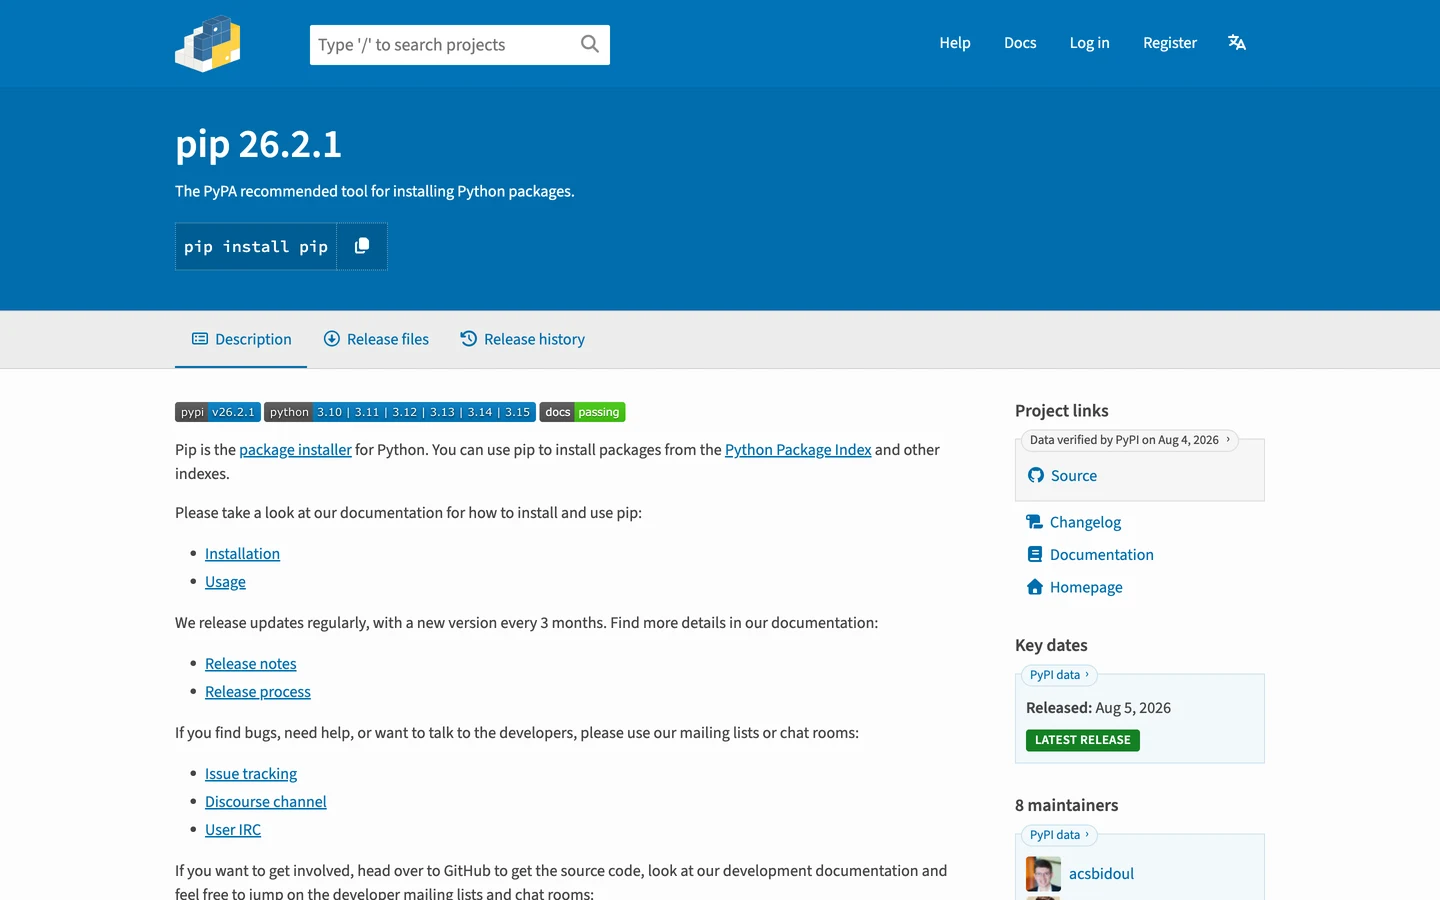
Тут є назва, опис в один рядок і команда, яку ви скопіюєте для встановлення. Якщо ви прийшли встановити пакет, більше нічого й не треба.
Вкладка Traffic у нашому інструменті «Аудит сайту» показує трафік з усього світу, а не лише зі США.
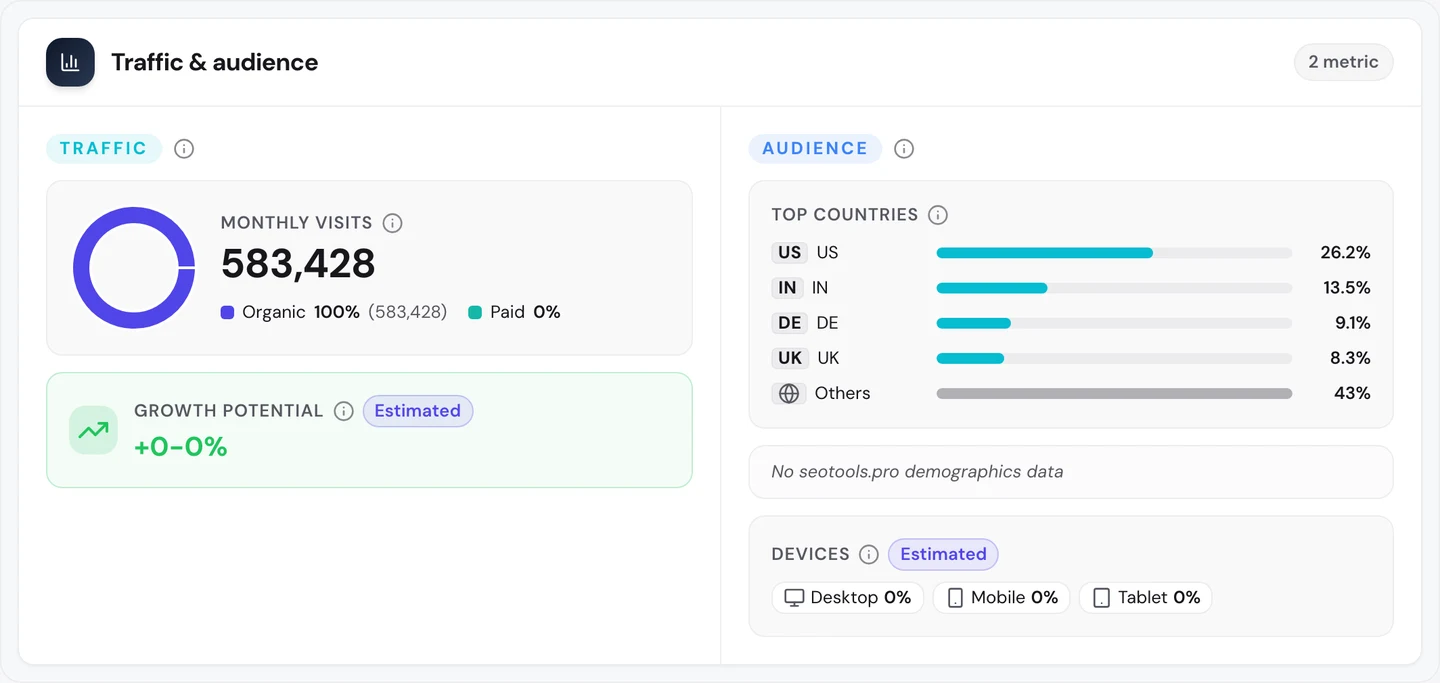
У всьому світі PyPI залучає з пошуку близько 580 тис. відвідувань на місяць і не платить за жодне з них. Приблизно 1 з 4 приходить зі США, а на другому місці Індія.
Docker Hub, який ми теж розбирали, побудований так само: на кожну програму там є окрема сторінка.
Тож дайте кожному своєму продукту окрему сторінку з його назвою. А потім подивіться в нашому інструменті «Перевірка органічного трафіку», які з ваших сторінок залучають відвідувачів.
Називайте сторінки словами з пошуку
Вкладка Keywords у нашому аудиті перелічує запити, за якими сайт з’являється в Google. Ключовим словом називають просто запит, який люди вводять у пошук, а вкладка показує, на якому ви місці і скільки відвідувань приносить кожен запит.
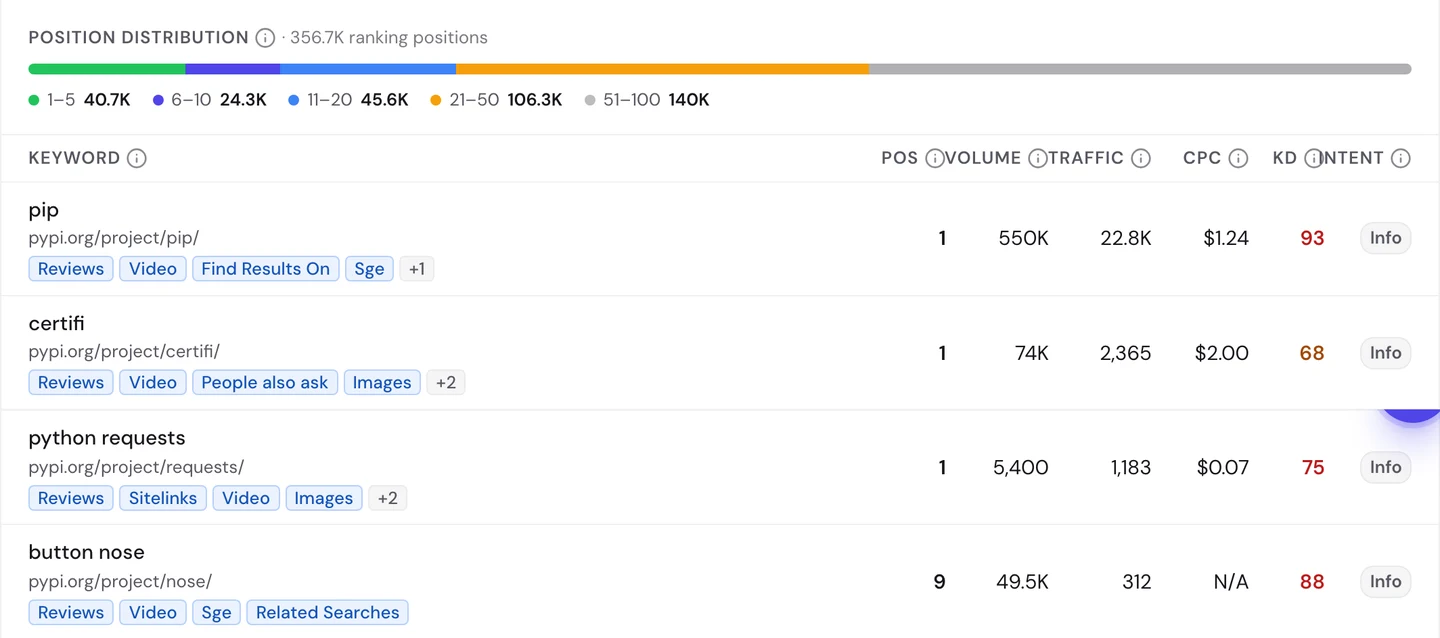
Погляньте на перший рядок. Хтось вводить «pip», і сторінка pip на PyPI стоїть першою у видачі.
Цей запит вводять близько 550 тис. разів на місяць. Сторінка перемагає, бо її назва й адреса слово в слово збігаються з тим, що ви ввели.
Те саме і з certifi, пакетом, який допомагає Python перевіряти захищені сайти. Він теж перший за власною назвою.
Сторінка requests посідає перше місце за запитом «python requests». Пакет requests потрібен, щоб ваш код міг обмінюватися даними із сайтами.
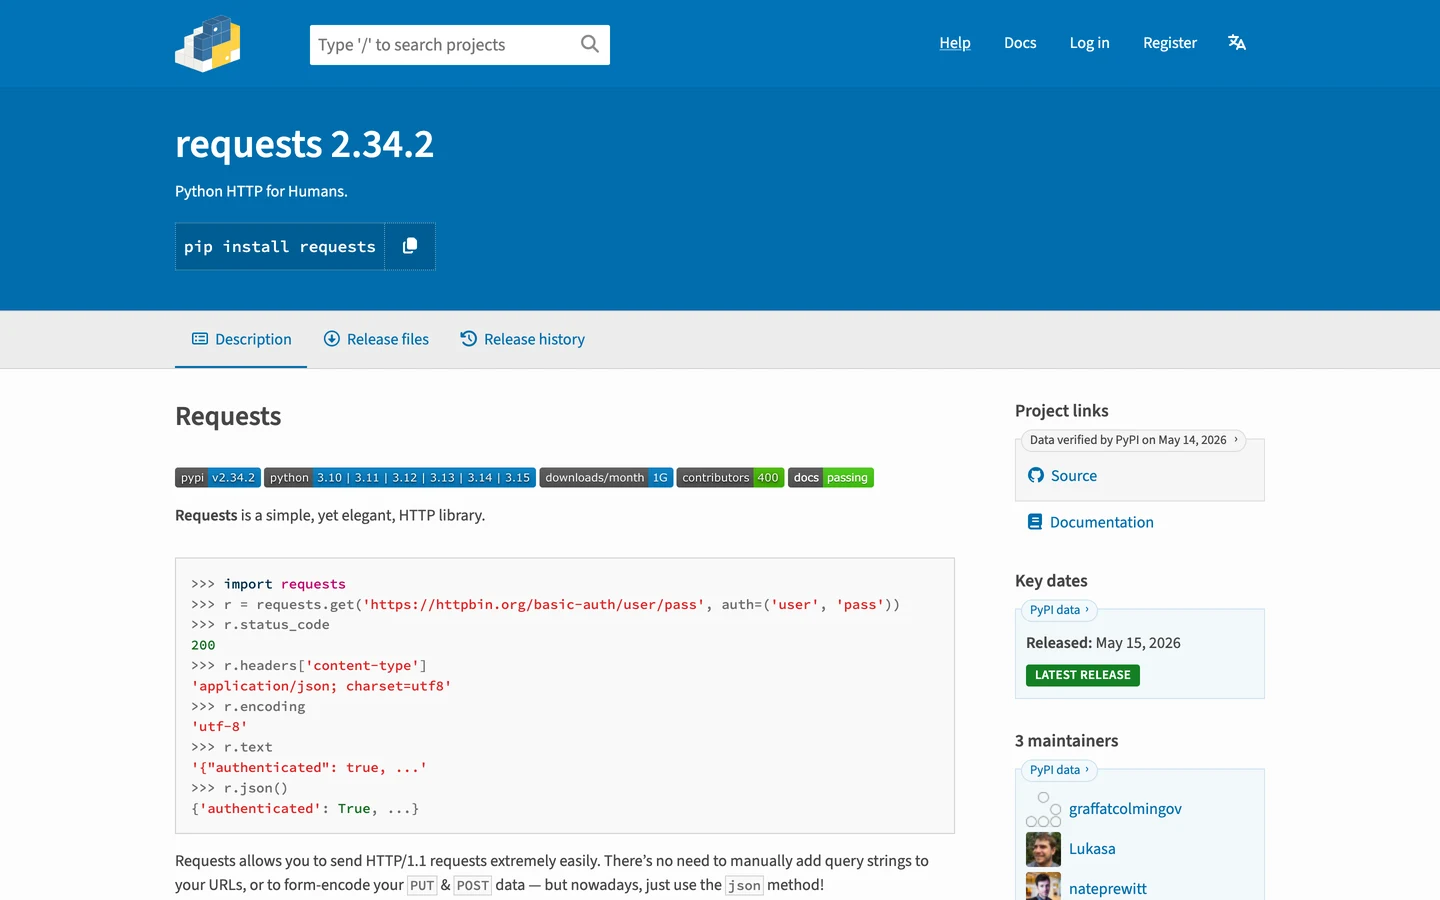
Вона побудована так само, як сторінка pip. Усі такі сторінки зроблені за одним шаблоном, тобто спільним макетом для кожного пакета.
Наш інструмент «Перевірка органічного трафіку» знайшов ще більше таких прикладів. Сторінка opencv-python стоїть першою за запитом «install opencv in python», а yfinance очолює видачу за власною назвою.
Але збіг назви має і зворотний бік. Сторінка nose, старого пакета для тестування, посідає 9-те місце за запитом «button nose».
Цей запит вводять близько 50 тис. разів на місяць. Але люди, які його вводять, шукали милий кирпатий носик, а не шматок коду.
Якщо у вас сайт для програмістів, почитайте ще про PHP.net, сайт ще однієї мови програмування, який ми теж розбирали.
Тож називайте кожну сторінку саме тим словом, яке вводять у пошук, і перевіряйте, за якими запитами кожна з них справді виходить у топ. Наш інструмент «Дослідження ключових слів» покаже, якими словами шукають люди.
Пишіть повніші заголовки й описи
Висока позиція вирішує лише половину справи. Коли ви вже на сторінці результатів, саме заголовок і опис вирішують, чи перейдуть люди до вас.
Наше безкоштовне розширення для браузера показує, як побудована сторінка. Відкрийте сторінку, натисніть значок seotools.pro, і поруч з’явиться панель із 35 SEO-перевірками.
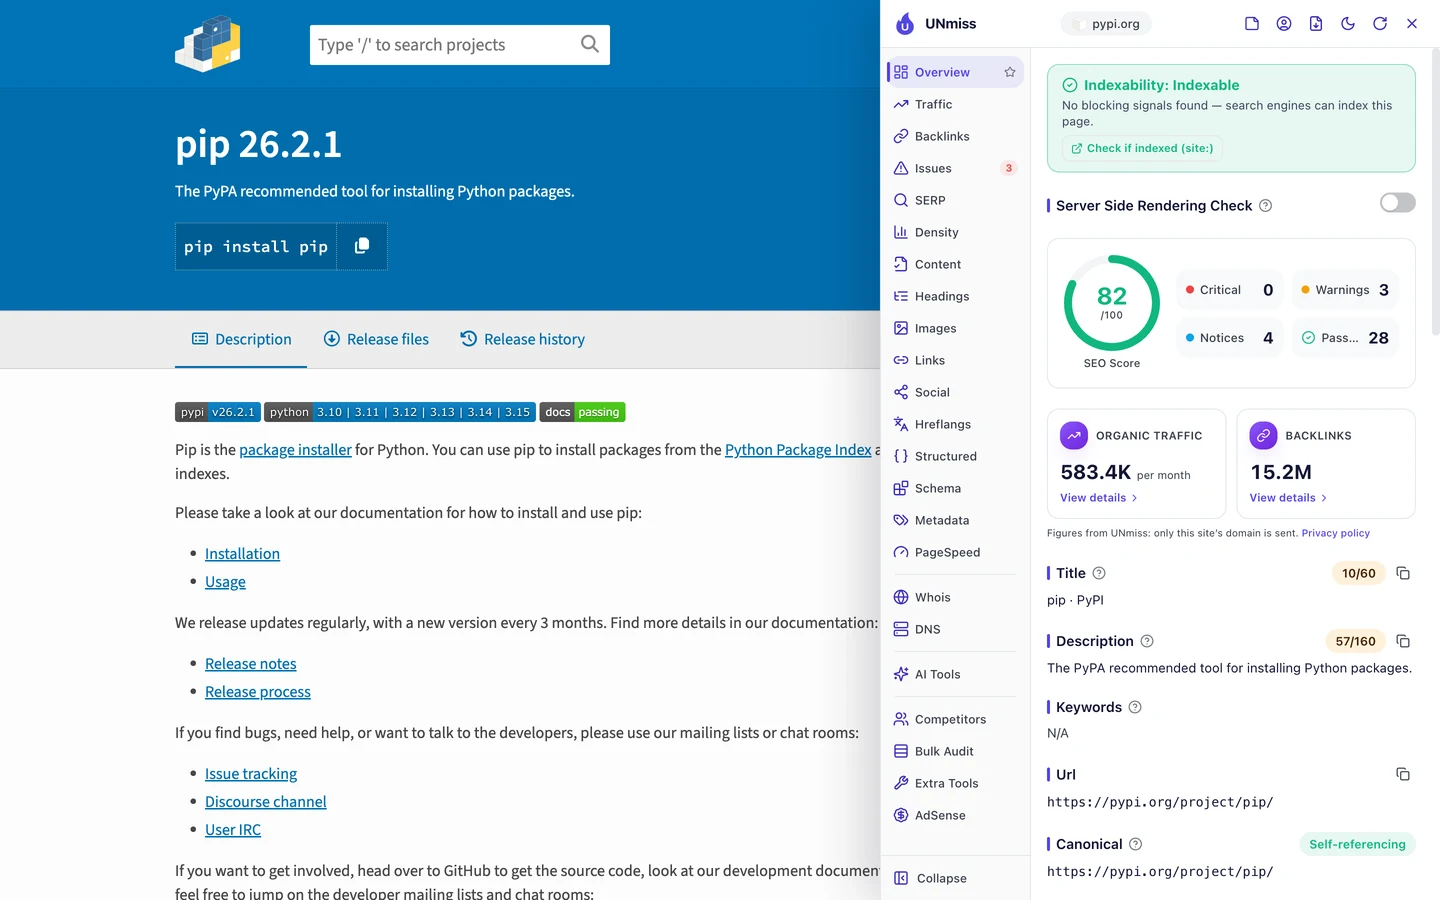
Сторінка pip набирає 82 бали зі 100. Її заголовок «pip · PyPI» займає лише 10 символів.
Описом називають короткий текст, який Google може показати під заголовком. Тут опис складається з одного рядка, який написали автори пакета: «The PyPA recommended tool for installing Python packages.»
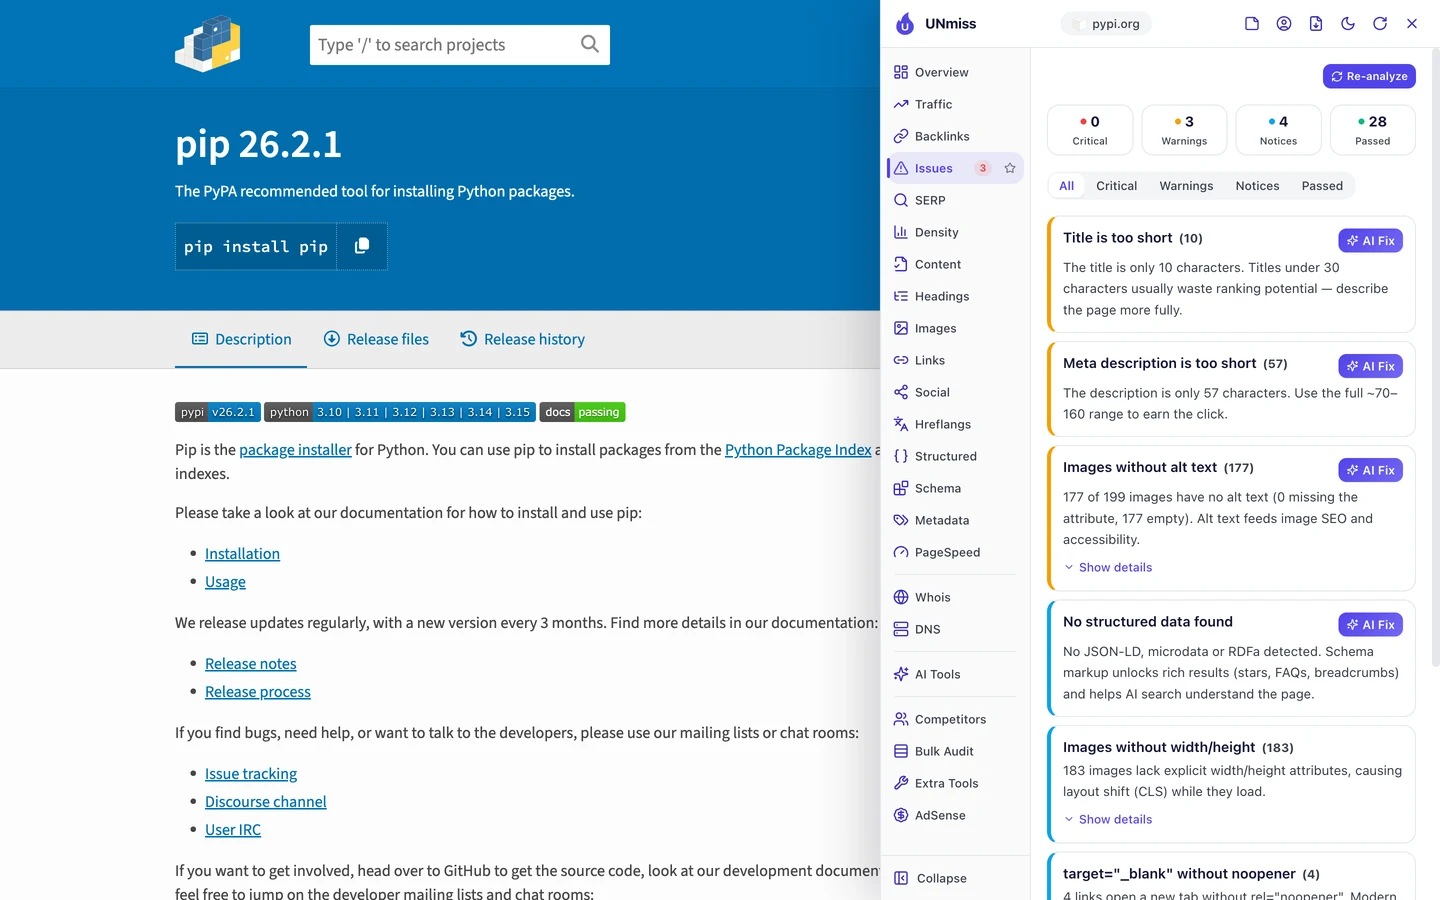
Вкладка Issues ставить обидві проблеми на початок списку. У заголовку можна було б сказати, що робить pip, а в описі є місце ще на 100 символів.
Тепер порівняйте зі сторінкою requests. Вона зроблена за тим самим шаблоном.
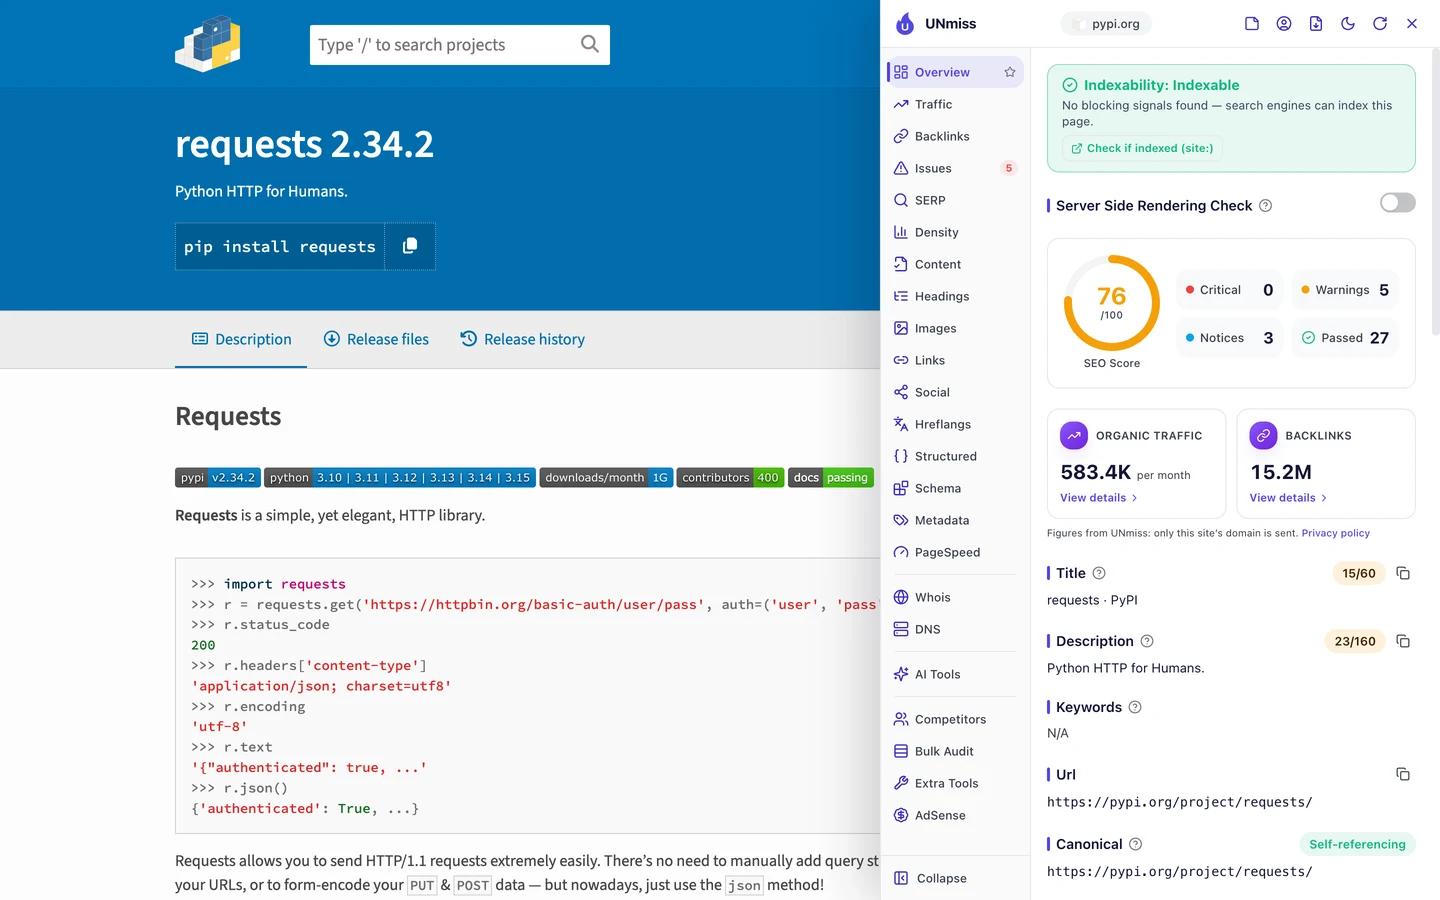
Вона набирає 76 балів. Її опис «Python HTTP for Humans.» звучить як дотепне гасло, але має лише 23 символи, хоча Google може показати близько 160.
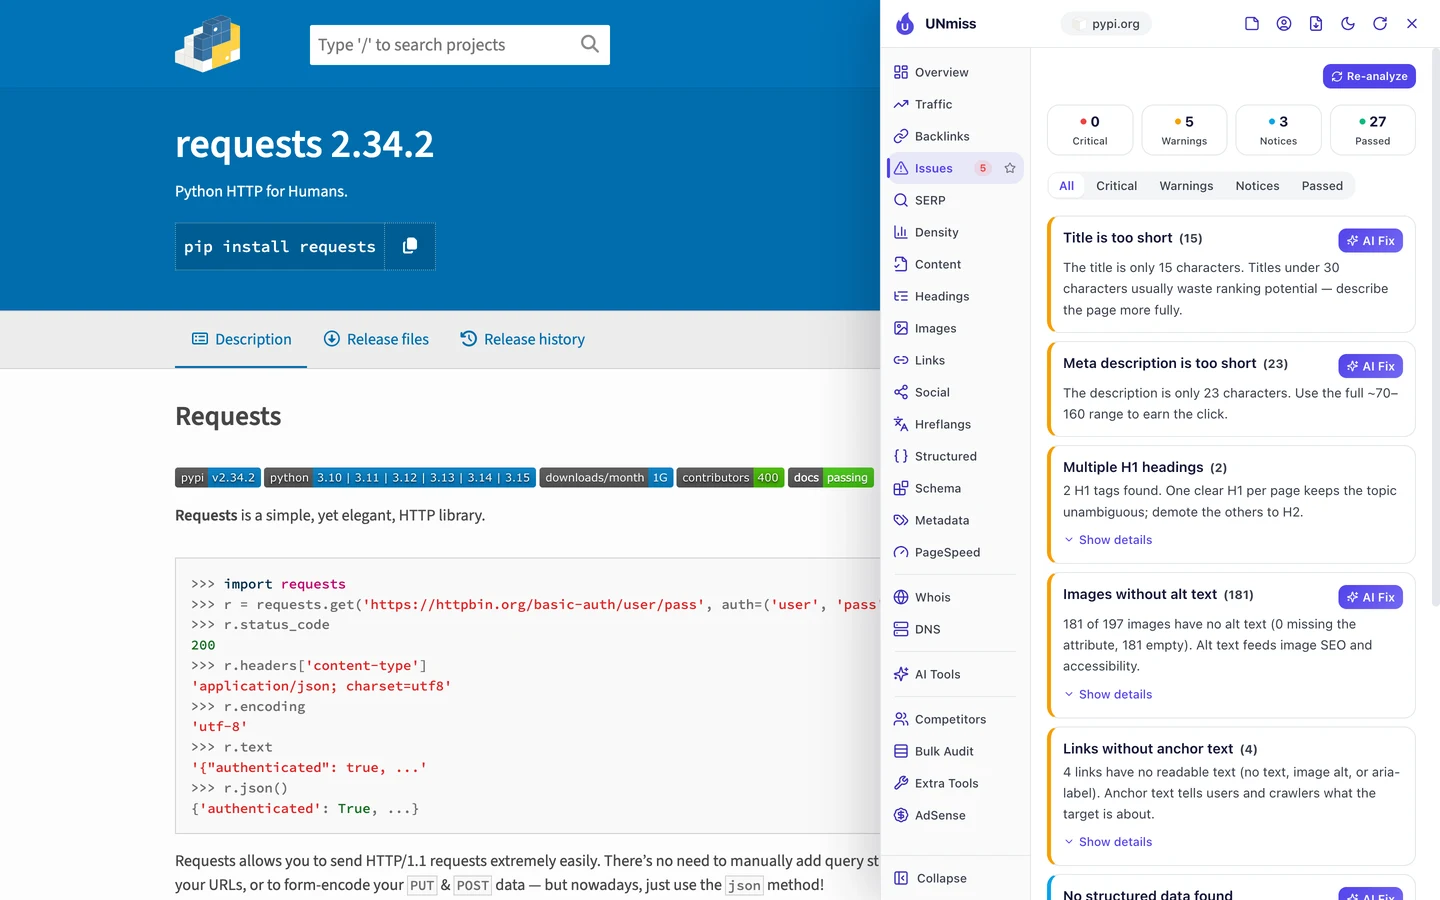
А ще на ній 2 теги H1. Тегом H1 позначають головний заголовок сторінки, і такий заголовок має бути один.
Тут назва пакета стоїть в одному H1, а другим, схоже, став заголовок «Requests» на початку опису. Цю частину пишуть автори пакета, тож шаблон не може повністю на неї вплинути.
Ось у чому заковика з описами, які кожен автор пише сам. Хтось пише повне речення, а хтось гасло.
Тож не пускайте заголовки й описи на самоплив. Додайте в заголовок, що робить сторінка, задайте мінімальну довжину опису й подивіться, який вигляд вони матимуть, у нашому генераторі метатегів.
Опишіть кожен пакет у коді
Структурованими даними називають код, який пояснює Google, що це за сторінка: товар, посібник чи програма. Вкладка Structured у розширенні шукає такий код.
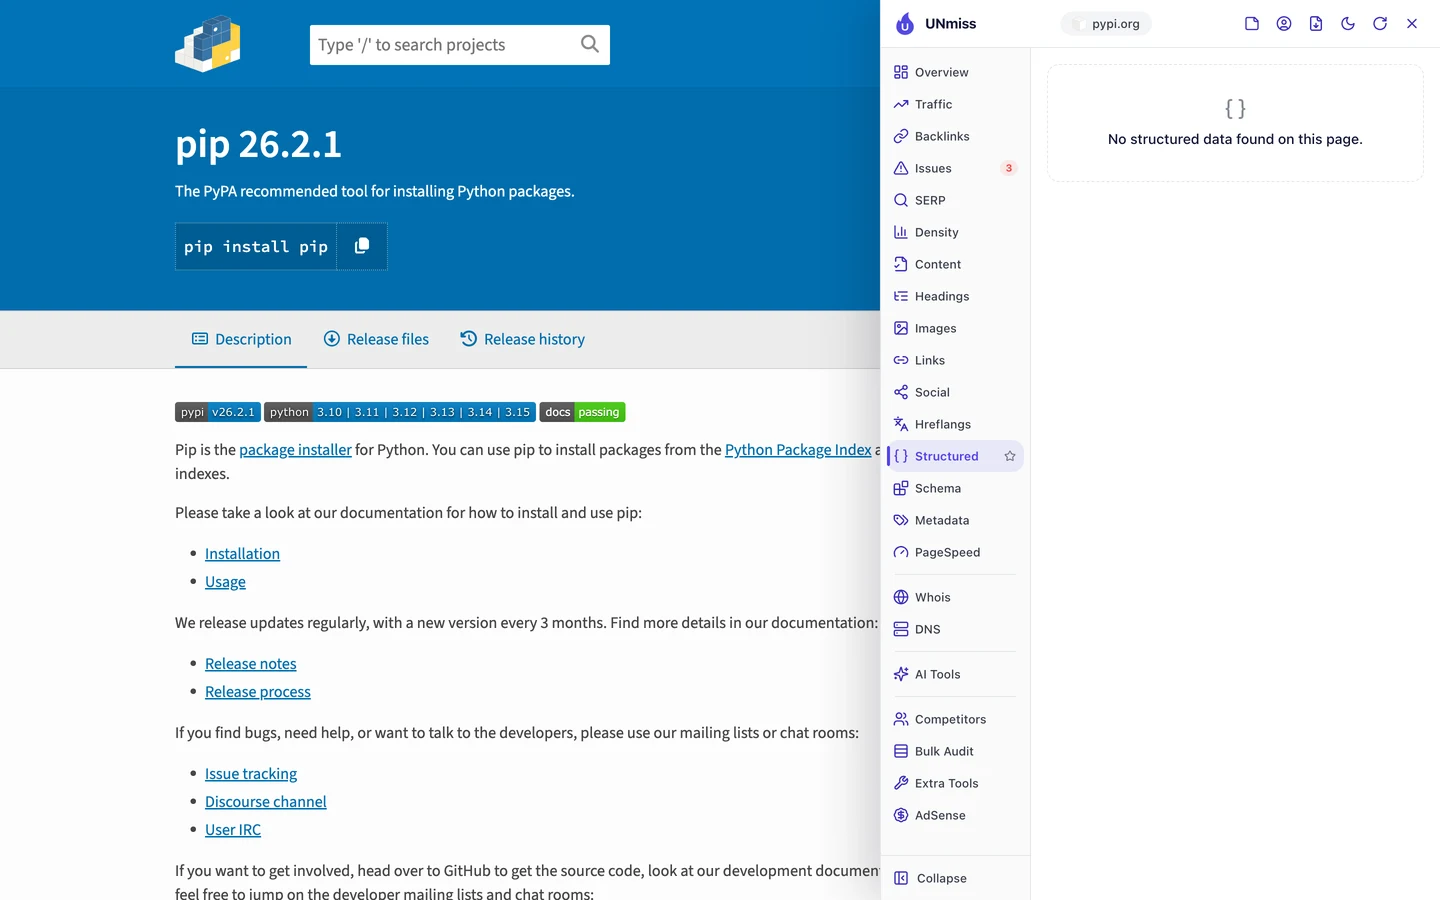
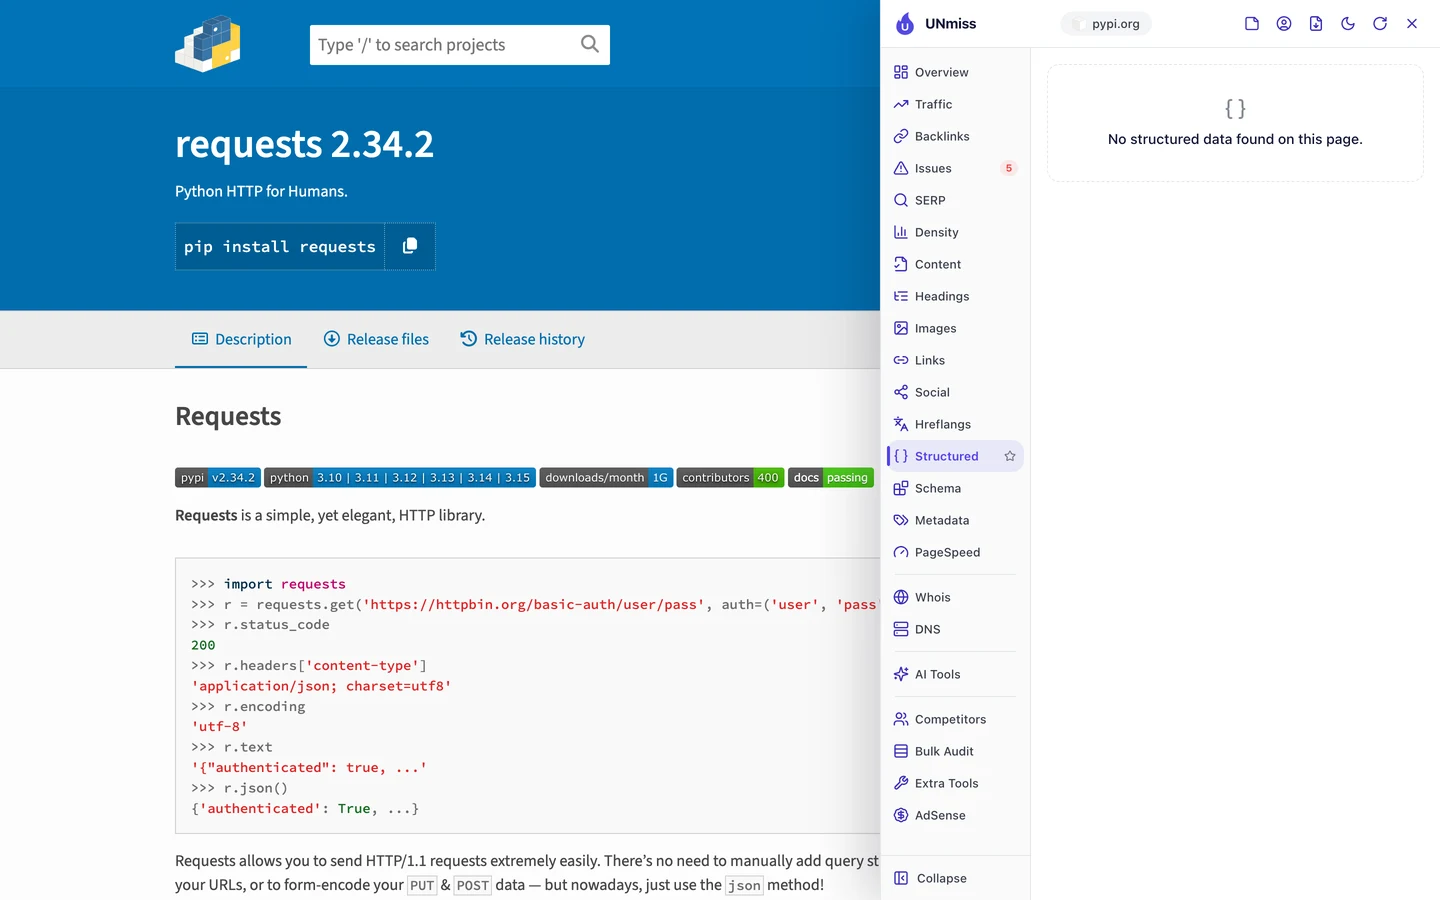
Ні на тій, ні на іншій сторінці нічого такого немає. Проте кожна показує версію, дату випуску і людей, які підтримують пакет.
Усе це можна було б записати в код, який Google читає напряму. Вкладка Content показує, чого бракує.
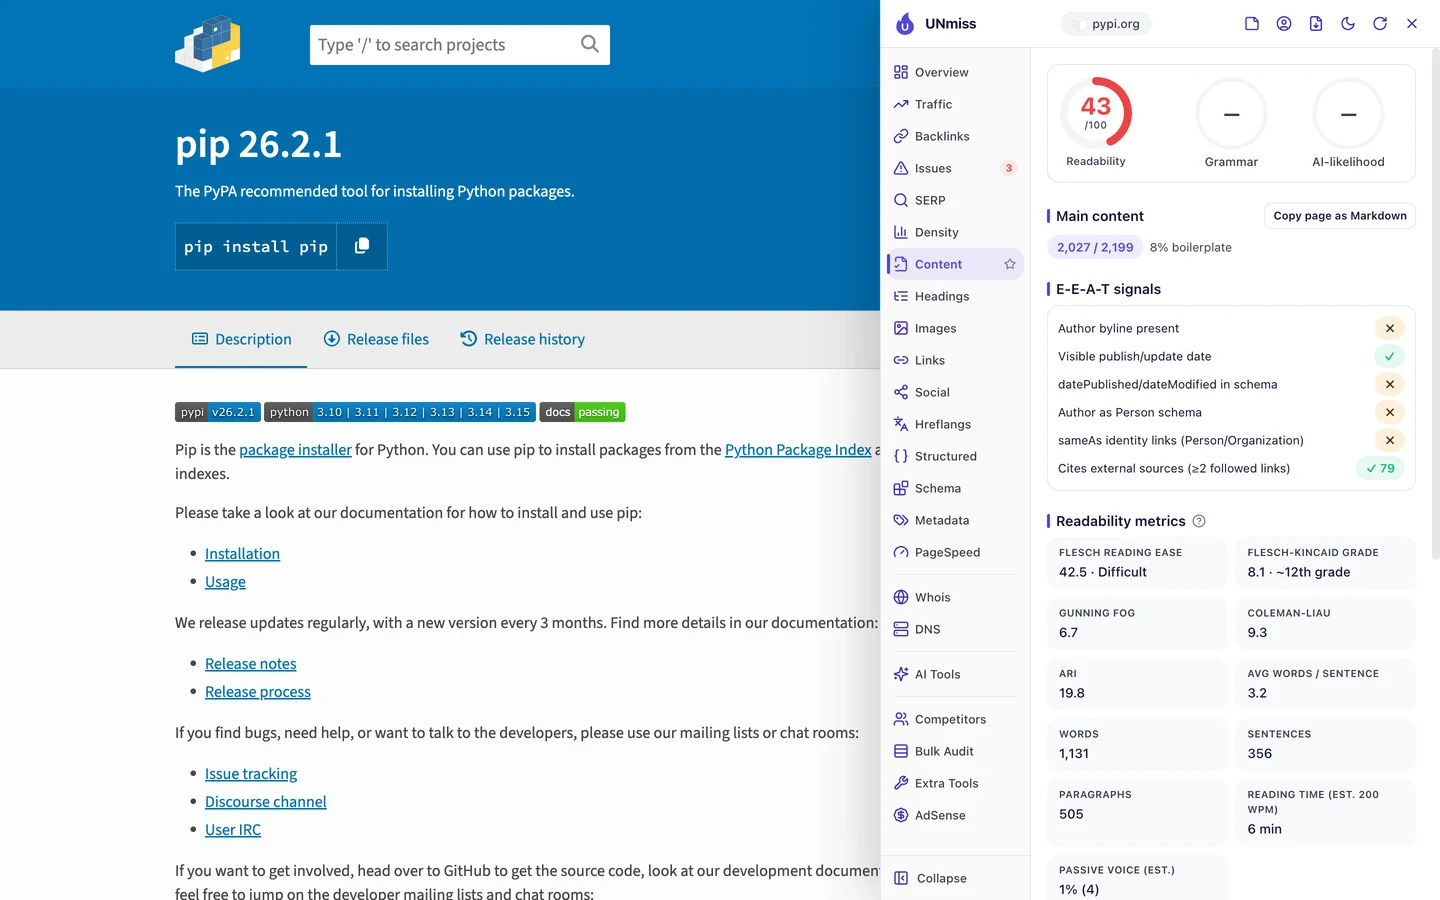
Сторінка pip показує дату випуску і містить чимало посилань на зовнішні джерела. Але дати в коді немає, як немає там і автора.
Без такого коду Google доводиться вгадувати ці факти за самою сторінкою. Здебільшого він не помиляється, але ви все одно покладаєтеся на випадок.
Той самий код допомагає й інструментам ШІ. Чимало програмістів тепер питають ChatGPT чи Claude, який пакет обрати, тож ми перевірили, яким ШІ-краулерам дозволено читати PyPI.
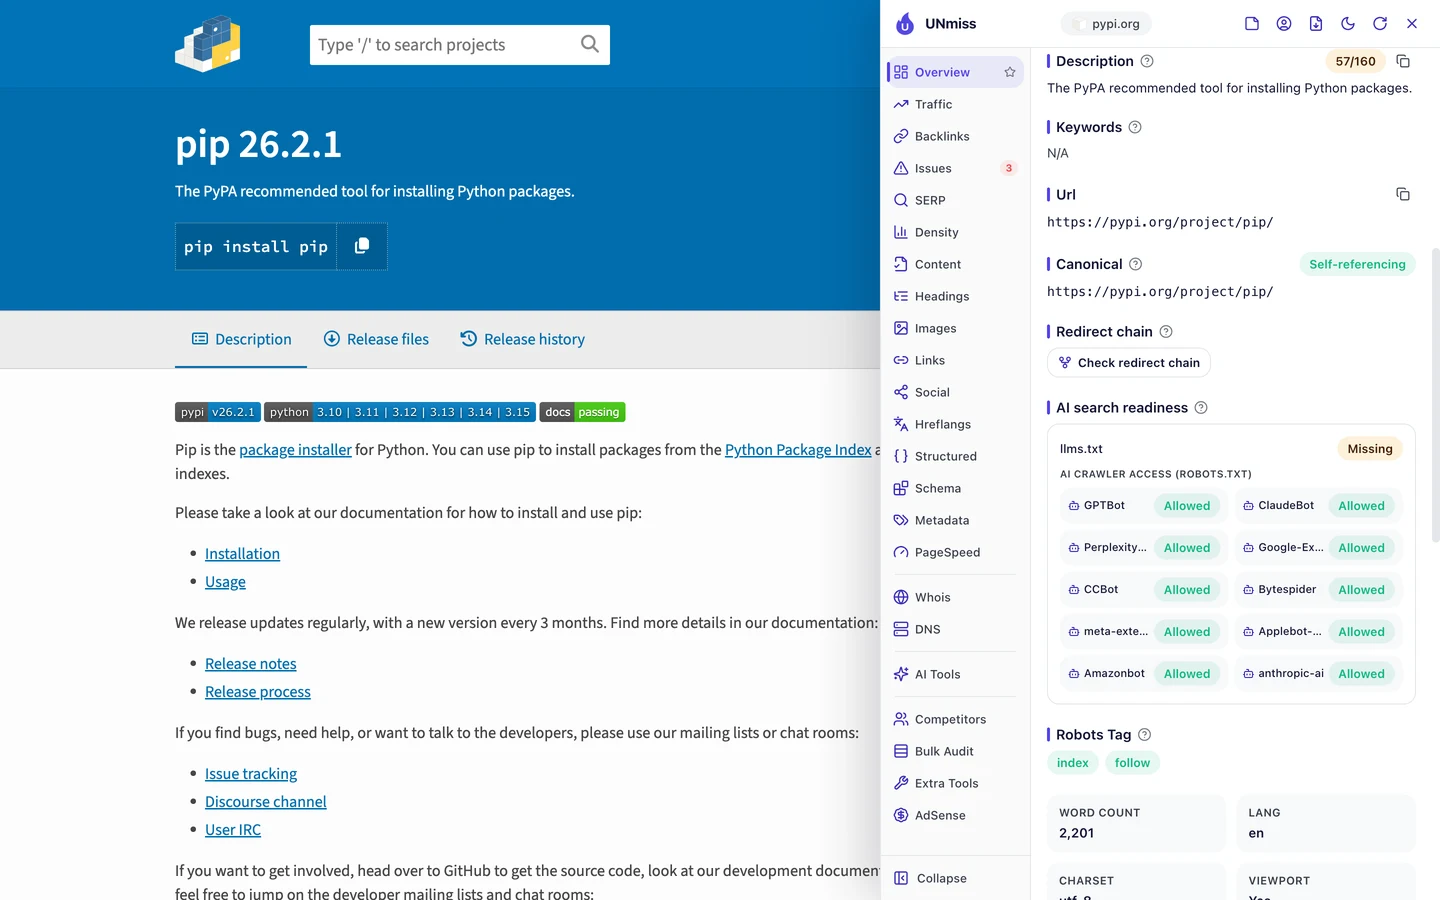
Краулером називають програму, яка відкриває сторінки так само, як Google. Правила для краулерів записані у файлі robots.txt, де сказано, що їм можна читати.
PyPI пускає всіх 10 ШІ-краулерів, яких перевіряє розширення. Але файлу llms.txt, короткого опису сайту для інструментів ШІ, у нього немає.
Якщо вам важливі відповіді ШІ, зазирніть у MDN, сайт документації для програмістів, який ми теж розбирали.
Складіть власні правила для краулерів у нашому генераторі robots.txt. А потім перевірте в нашому інструменті «Перевірка видимості в ШІ», чи згадують вас інструменти ШІ.
Тож додайте код, який повідомляє, що це за сторінка, якої версії вона стосується і коли змінилася. Наш Генератор розмітки Schema напише його за вас.
Проведіть аудит того, що бачать боти
Розширення перевіряє по одній сторінці. А наш «Аудит сайту» запускає власного краулера одразу на сотні сторінок, тож видно, які проблеми повторюються.
Він перевірив 250 сторінок PyPI. Сайт набрав 79 балів зі 100, а звіт оцінює це як задовільний результат.
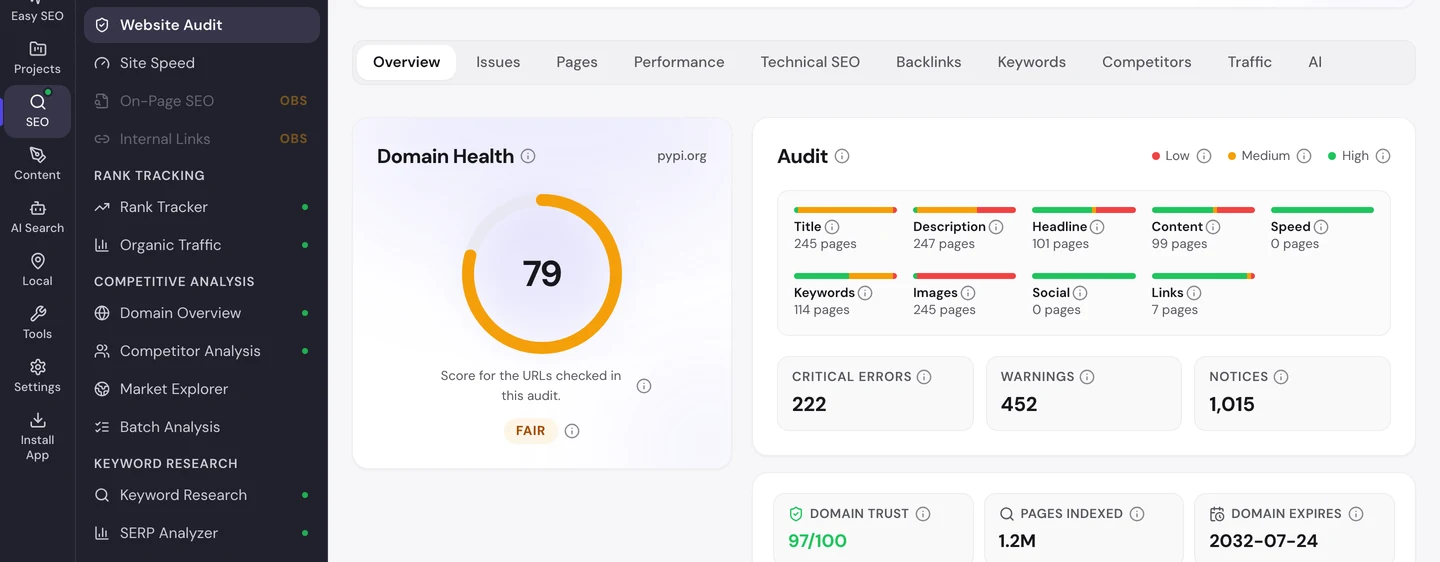
Ще він показує близько 1,2 млн проіндексованих сторінок, тобто внесених до бази Google. Вкладка Issues сортує проблеми за важливістю.
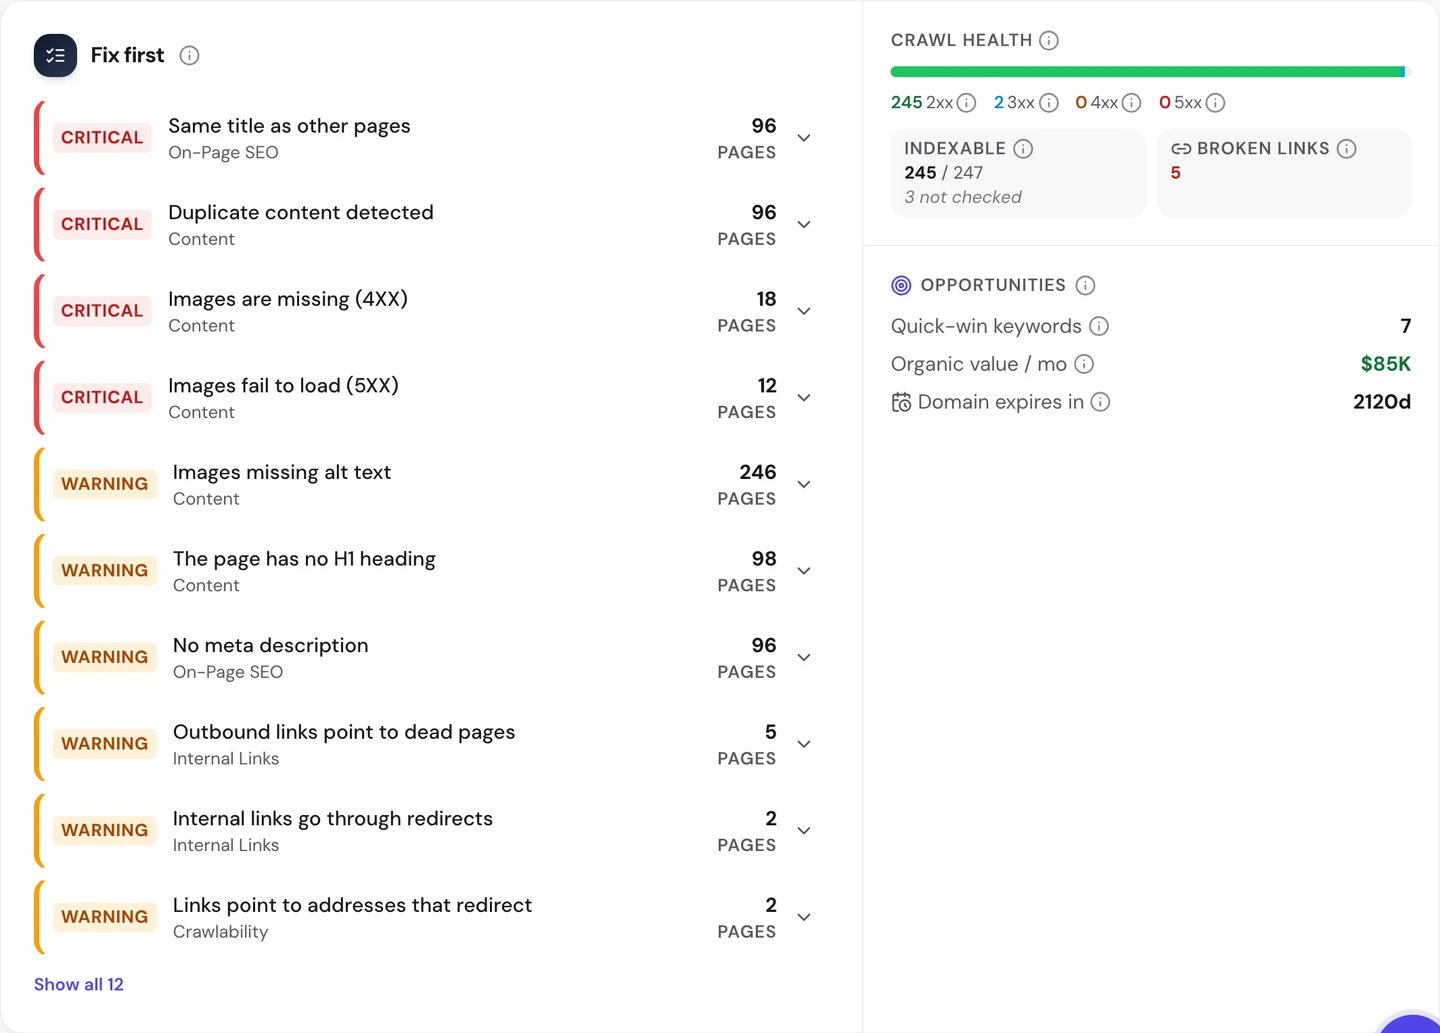
2 головні помилки: однаковий заголовок і однаковий вміст на 96 сторінках. Нижче видно, що на 96 сторінках немає опису, а на 98 немає H1.
Звучить погано, поки не подивитеся, що на цих сторінках написано. На всіх 96 стоїть заголовок «Client Challenge».
Такий вигляд має перевірка на бота. Вона переконується, що відвідувач не програма для копіювання сайту. Замість сторінки пакета наш краулер натрапив саме на неї.
Тож більшість цих помилок насправді не помилки PyPI. Просто ту саму перевірку на бота пораховано 96 разів.
Перевірки на бота захищають популярний сайт від скраперів, тобто програм, які масово копіюють сторінки. Але є ризик, що вони зупинять і Google.
Сторінки PyPI стоять першими за своїми назвами, тож Google явно проходить перевірку. Open Library, яку ми теж розбирали, так само показує перевірку на бота незнайомим відвідувачам.
Вкладка Technical SEO показує, які сторінки Google може додати до пошуку.
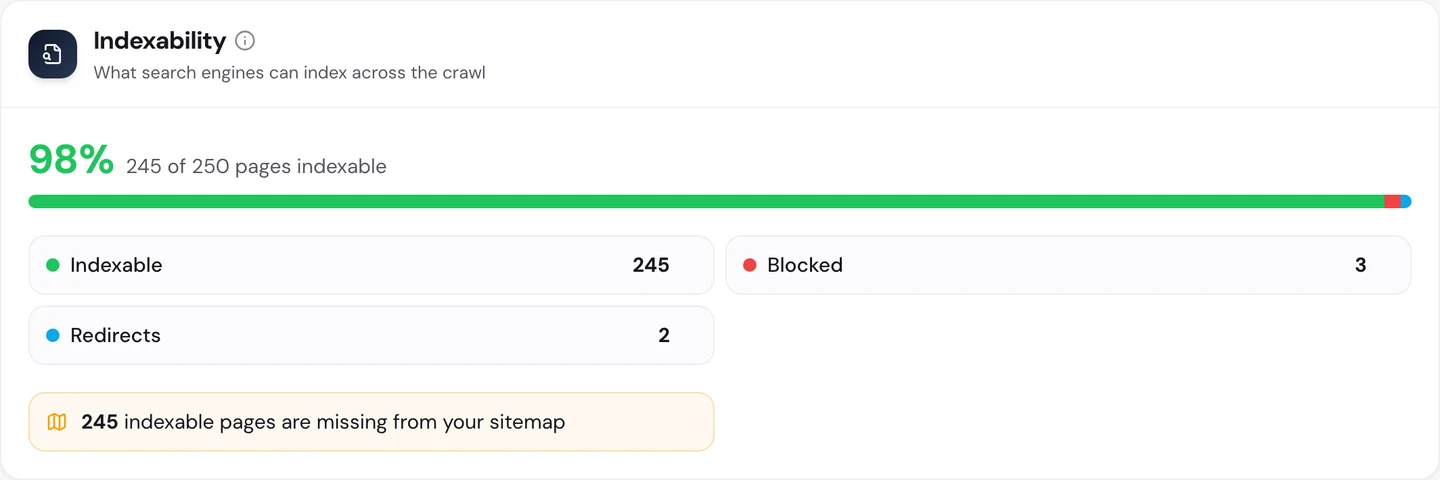
Майже кожна сторінка може потрапити в пошук, і це чудово. Але 245 із них немає в карті сайту, тобто у файлі зі списком сторінок для Google.
Здебільшого це сторінки старих версій, які в карті сайту вам, можливо, і не потрібні. Але все ж варто перевірити, чи є там основна сторінка кожного пакета.
Вам не треба самим ламати голову, що виправляти першим. Вкладка AI в аудиті складає план: коротке резюме, кожну проблему з порадою, як її виправити, і список справ на наступні 3 місяці.
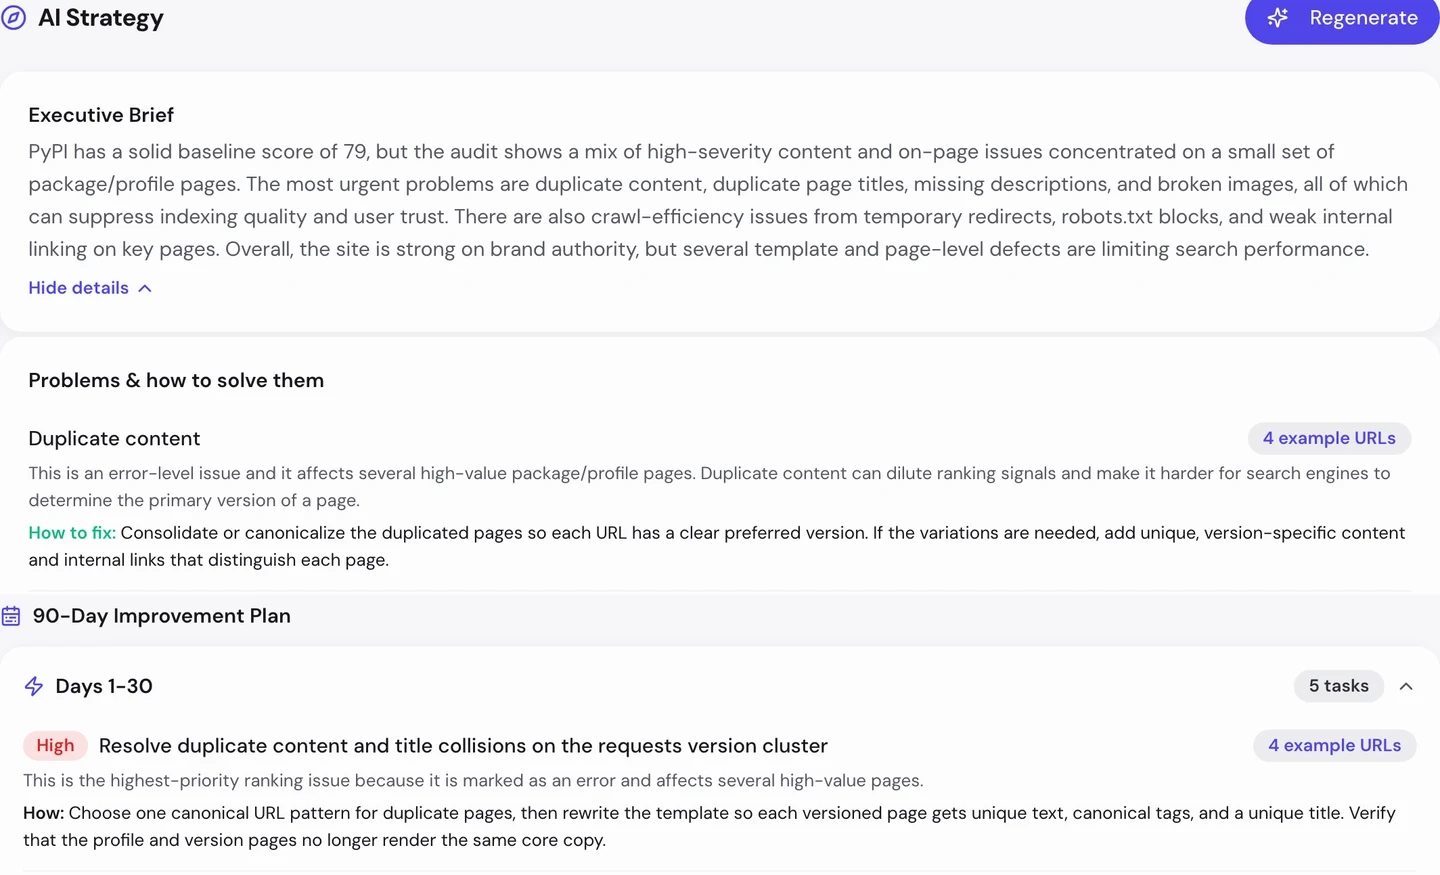
План спирається на ті самі цифри, тож теж рахує сторінки з перевіркою на бота. Але його перше завдання слушне: численні сторінки старих версій requests.
Тож запустіть наш Аудит сайту і відкрийте сторінки з найсерйознішими помилками. Якщо всі вони мають однаковий заголовок на кшталт «Client Challenge», перевірте їх очима Google, перш ніж щось виправляти.
Прив’яжіть старі версії до основної
Щоразу, коли пакет оновлюється, PyPI зберігає сторінку старої версії. Картка Duplicates в аудиті показує, як це виглядає.
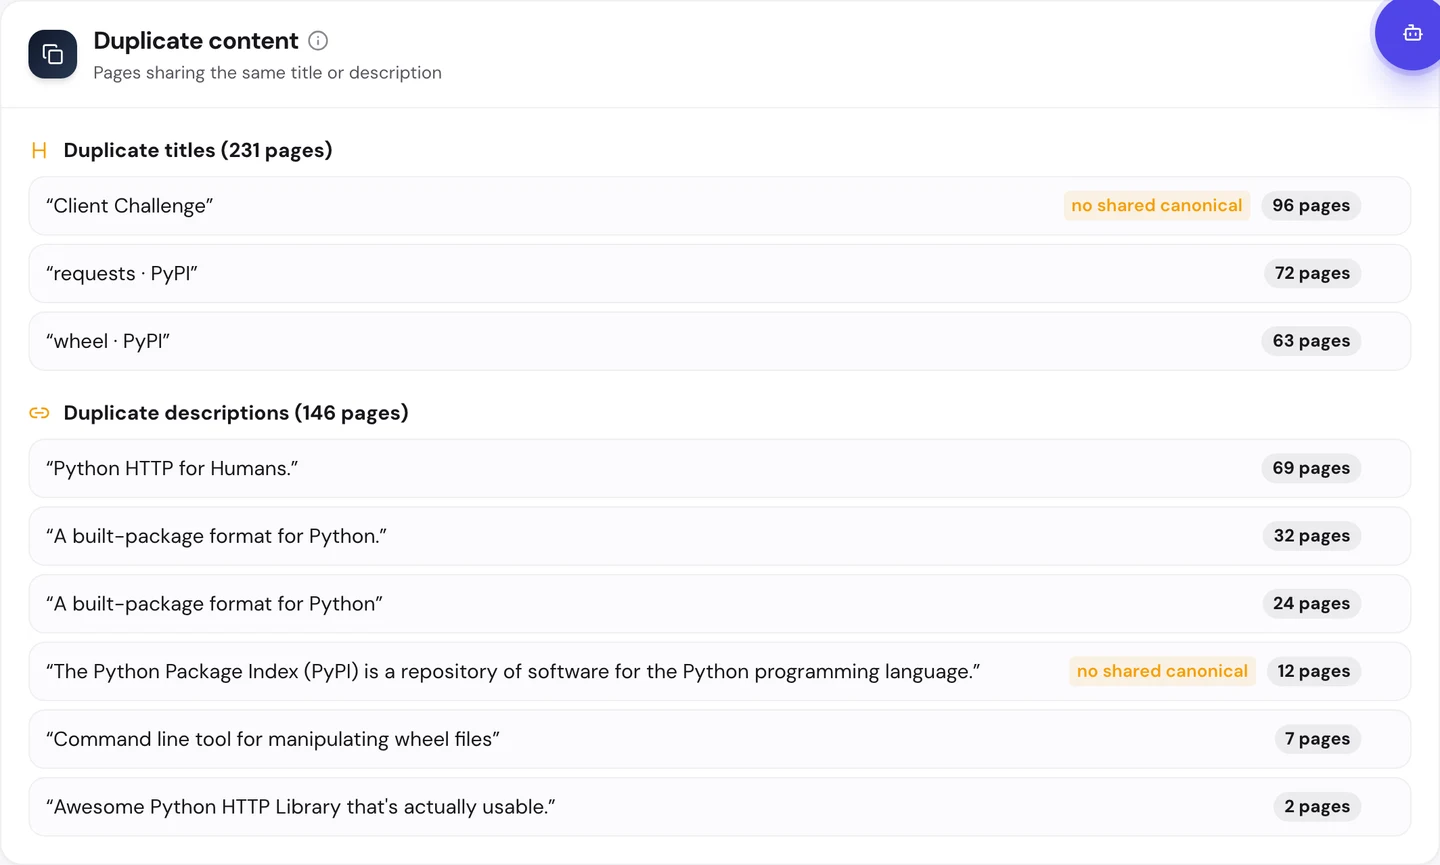
Заголовок «requests · PyPI» трапляється на 72 сторінках. А «Python HTTP for Humans.» стоїть в описі на 69.
Ідеться про сторінку requests та її старі версії, і кожна має власну адресу. У пакета wheel, формату для поширення коду на Python, та сама історія на 63 сторінках.
Google бачить купу схожих сторінок. Якби ви були на місці Google, яку з них поставили б у топ?
PyPI розв’язує це за допомогою канонічного тегу (canonical), який підказує Google, котра адреса основна. Список сторінок у нашому аудиті показує, що кожна стара сторінка requests і wheel, до якої ми дісталися, вказує на основну сторінку пакета.
Погляньте на картку ще раз. Напис «No shared canonical» стоїть біля перевірки на бота, але не біля requests чи wheel.
Ось чому основна сторінка requests досі перша у видачі, попри десятки двійників. Старі сторінки лишаються відкритими для всіх, кому вони потрібні, а Google знає, що людей із пошуку треба вести на основну.
Є й інший варіант, тег noindex, який забороняє Google додавати сторінку до пошуку. Використовуйте його, якщо не хочете, щоб стара версія взагалі потрапляла в Google.
Тож якщо ви зберігаєте старі версії, пропишіть у кожній канонічний тег з адресою основної сторінки. А потім запустіть наш Аудит сайту і перевірте, чи так зроблено на кожній копії.
PyPI зберігає сторінку для кожної старої версії, і кожна з них підказує Google, яка сторінка основна. Ми знайдемо схожі сторінки на вашому сайті, вирішимо, яка з них має бути в топі, і налаштуємо теги так, щоб Google усе зрозумів правильно.
- Знайдемо сторінки з однаковими заголовками чи описами
- Налаштуємо правила canonical і noindex для старих і майже однакових сторінок
- Перевіримо ваш захист від ботів, щоб Google отримував справжню сторінку
- SEO і GEO, щоб вас цитували й у відповідях ШІ
Робіть сторінки простими й швидкими
Старі сторінки мають з основними ще одну спільну рису. Вони легкі, тож швидко завантажуються.
Вкладка Performance в аудиті показує Core Web Vitals. Так називають 3 перевірки Google: як швидко сторінка завантажується, як швидко реагує і чи не стрибає її вміст. Їх вимірюють на пристроях справжніх відвідувачів.
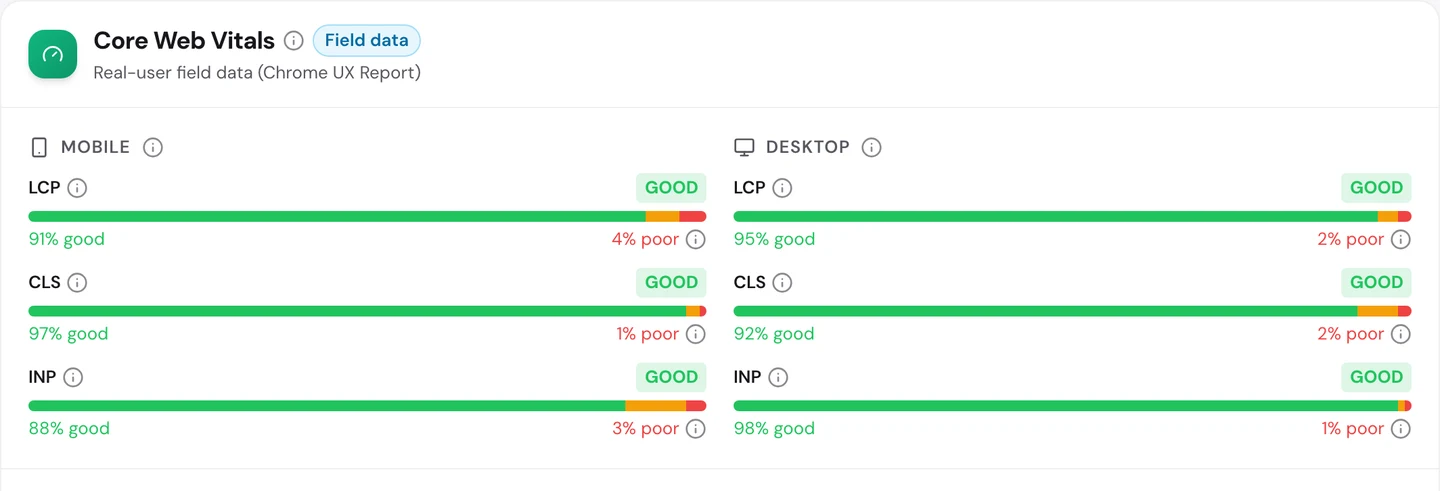
PyPI проходить усі 6 перевірок. На телефонах основний вміст швидко завантажується приблизно в 9 з 10 відвідувань.
Сторінки швидко реагують на дотики і не стрибають під час завантаження.
Ще аудит з’ясував, що текст записаний прямо в коді кожної сторінки, тож текстові не доводиться чекати, поки його зберуть скрипти. Прості сторінки легко тримати швидкими.
Тож робіть найпопулярніші типи сторінок простими й перевіряйте їх на телефоні. Наш інструмент Site Speed покаже, що саме гальмує кожну сторінку.
Стежте, на які сторінки посилаються
Швидкість допомагає, але посилання досі важать чимало. Зворотне посилання (backlink) веде з іншого сайту на ваш, і Google сприймає кожне таке посилання як своєрідний голос довіри.
Вкладка Backlinks у нашому аудиті показує ті самі дані, що й наш Аналізатор зворотних посилань.
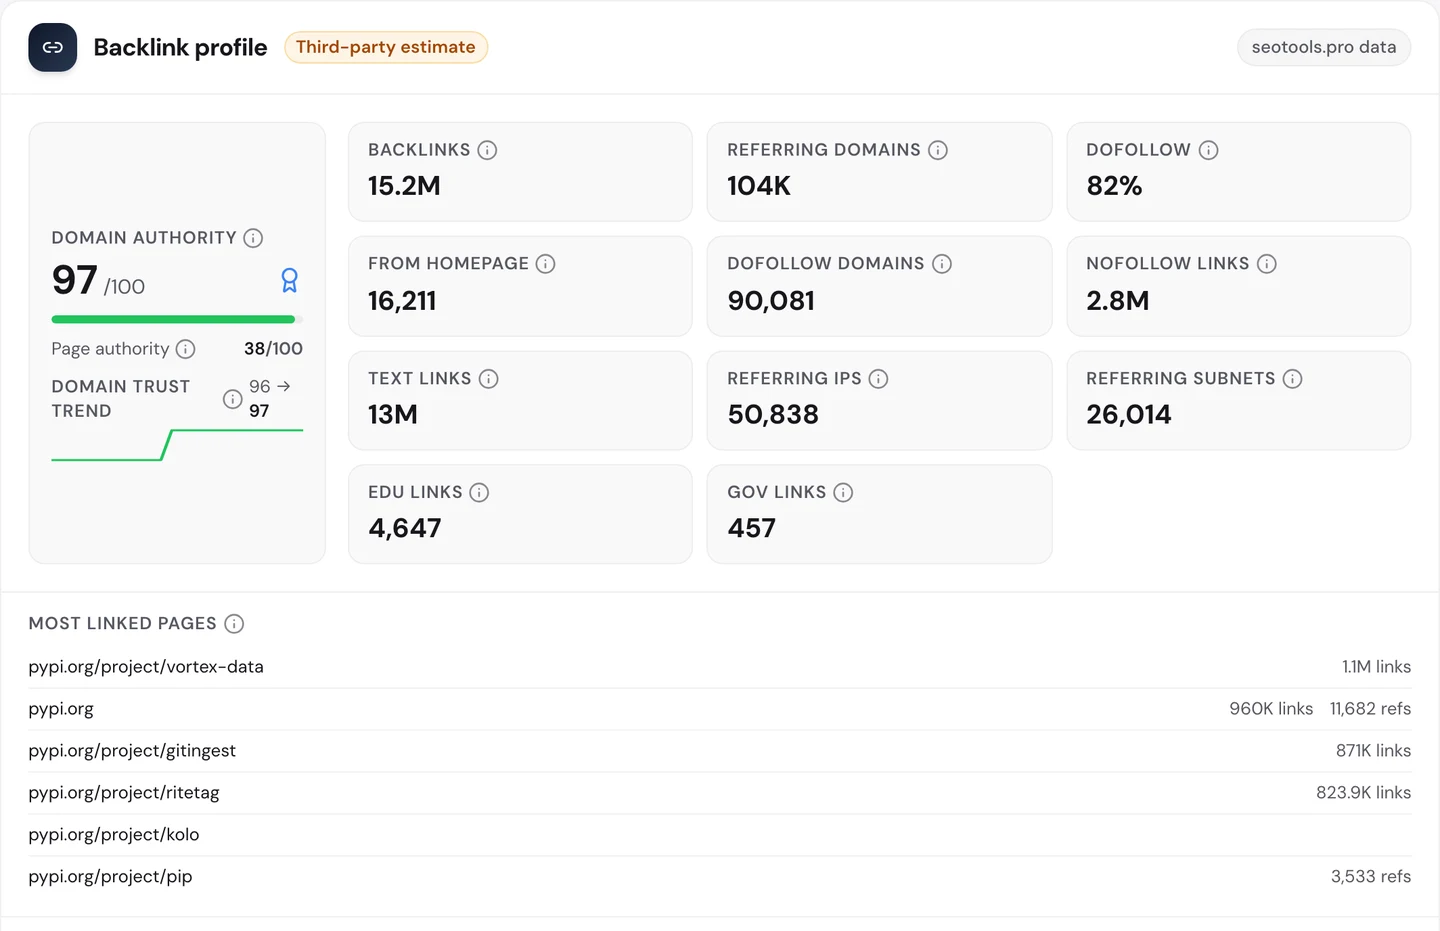
На PyPI веде близько 15 млн посилань із приблизно 104 тис. сайтів (referring domains). Його Domain Authority, тобто наша оцінка сили посилань сайту за шкалою від 0 до 100, сягає 97.
Тепер погляньте на сторінки, на які посилаються найчастіше. Ви, мабуть, очікували б побачити вгорі pip або головну.
Натомість перше місце посідає маленький пакет vortex-data, на який веде близько 1,1 млн посилань. Ще кілька маленьких пакетів ненабагато відстають, і в кожного з них посилань набагато більше, ніж у pip.
А pip, сторінка, яка залучає найбільше відвідувань, стоїть у самому кінці списку. Її сила не в кількості посилань, а в тому, що на неї посилаються близько 3 500 різних сайтів.
Таку величезну кількість посилань часто дає один сайт, який ставить посилання з кожної своєї сторінки. На них варто глянути, але важать вони не завжди стільки, скільки здається.
Тож щомісяця перевіряйте в нашому аналізаторі беклінків, на які ваші сторінки посилаються найчастіше. Рахуйте сайти, що посилаються на сторінку, а не лише посилання, і стежте, щоб найкращі сторінки отримували свою частку.
Знайдіть запити, де ви майже в топі
З такою кількістю посилань PyPI мав би стояти в Google високо. Наш Огляд домену показує, де він стоїть насправді.
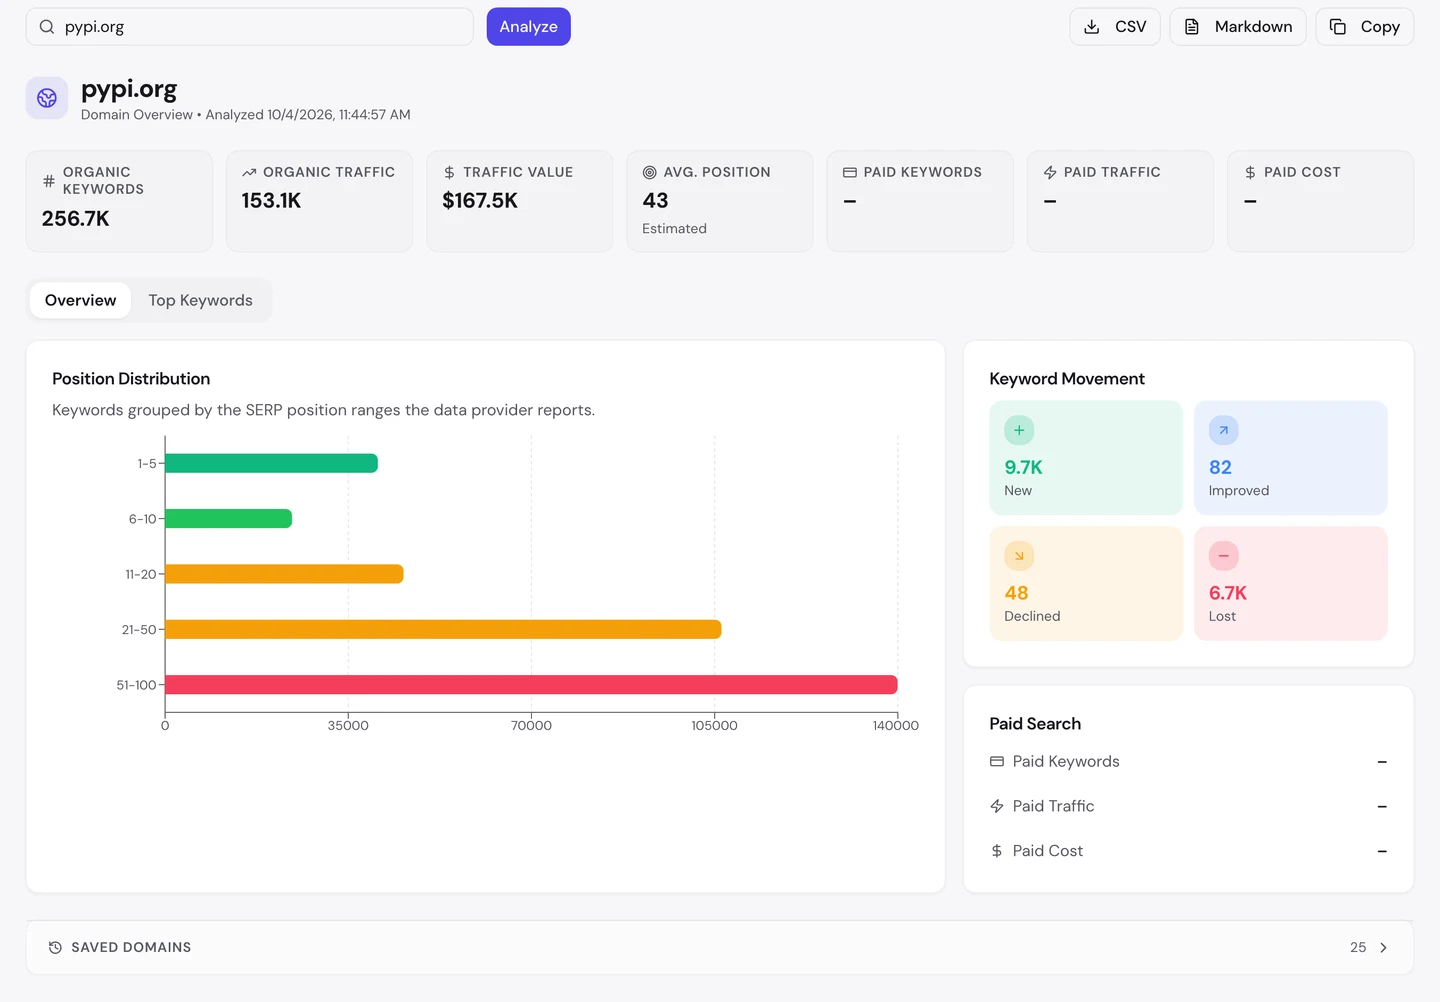
PyPI з’являється в пошуку приблизно за 257 тис. запитів. Вартість його трафіку, тобто скільки коштували б ці відвідування, якби їх купувати через рекламу в Google, становить близько 168 тис. $ на місяць.
Але середня позиція 43, а це 5-та сторінка Google. Найдовший стовпчик на графіку припадає на місця від 51 до 100, де майже ніхто не клікає.
Добра новина у вкладці Keywords, яку ви вже бачили. Близько 46 тис. запитів стоять на 2-й сторінці, і їм зовсім трохи бракує до топ-10.
Якщо ви в схожій ситуації, саме тут ваші найшвидші перемоги. А вкладка Competitors показує, хто виграє запити, яких не виграєте ви.
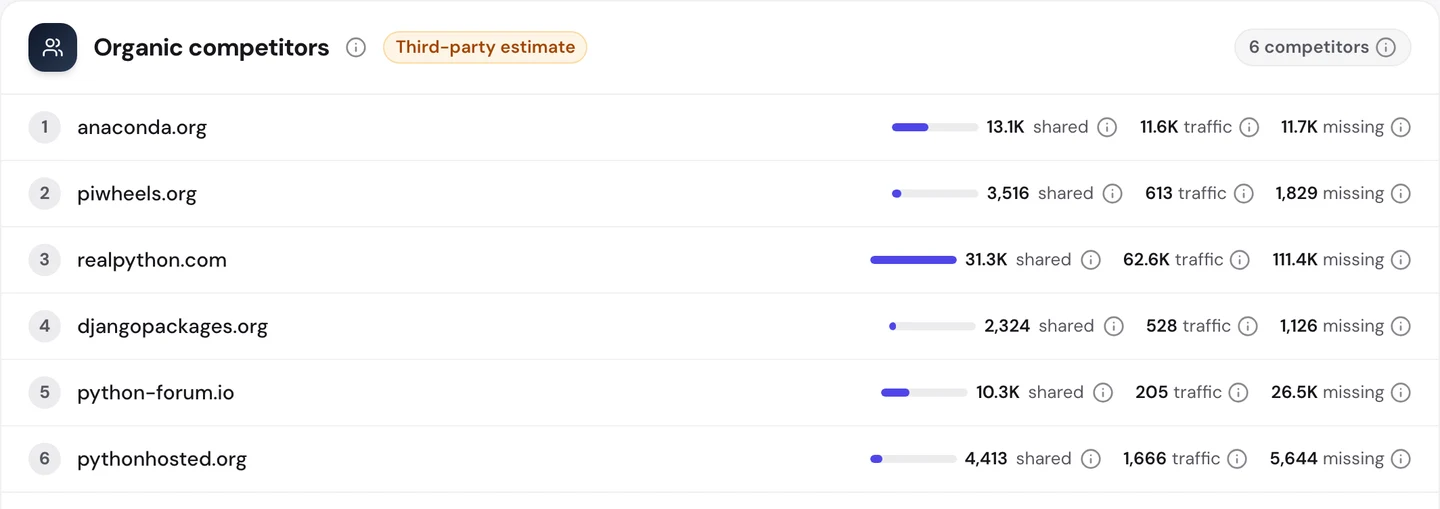
Першою йде Anaconda, ще одне місце, де беруть пакети Python. Real Python, сайт із безліччю уроків Python, має найбільше спільних запитів, близько 31 тис.
Тепер погляньте на стовпчик «missing». У ньому запити, за якими конкурент є в пошуку, а PyPI немає, і лише в Real Python їх близько 111 тис.
Здебільшого це запити на кшталт «як зробити», на які список пакетів не відповість. Цей стовпчик підказує, яка сторінка вам потрібна, щоб їх виграти.
Якщо вам ближчі уроки, почитайте ще про freeCodeCamp, безкоштовну школу програмування, яку ми теж розбирали.
Тож знайдіть свої запити на 2-й сторінці й насамперед попрацюйте над цими сторінками, а потім стежте, як вони піднімаються, у нашому Rank Tracker. А з ким у вас спільні запити, покаже наш Аналіз конкурентів.
Одна сторінка, pip, приносить PyPI 29% відвідувань із пошуку в США. Наш Organic Traffic Checker покаже ваші відвідування за місяць, динаміку й сторінки, які їх приносять, тож ви знатимете, про які дбати насамперед.
- Той самий звіт, яким ми виміряли трафік PyPI
- Трафік, частка й головний запит кожної популярної сторінки
- Перевіряйте так само й домени конкурентів
Що скопіювати не вийде
Спершу про те, чого не повторити: саме з PyPI pip бере пакети. Про це сказано на самій сторінці pip, у першому ж рядку.
На PyPI посилаються школи, державні сайти і ще близько 104 тис. інших сайтів. Така довіра набирається роками, і купити її не можна.
Тепер кілька чесних зауважень про цифри.
Дані ми зібрали 4 жовтня 2026 року. Цифра 153 тис. стосується лише пошуку Google у США.
Цифру 580 тис. ми взяли з вкладки Traffic в аудиті, і вона охоплює весь світ. Тому ці 2 цифри так сильно відрізняються.
Усі ці цифри приблизні. Ніхто, крім команди PyPI, не знає точної кількості відвідувань, тож інструменти оцінюють її за позиціями в пошуку та частотою запитів.
Ми перевірили 250 сторінок, а це невелика вибірка з дуже великого сайту. Обхід глибоко зайшов у старі версії requests і wheel, тож рівномірним зрізом сайту його не назвеш.
А замість 96 із цих сторінок ми отримали перевірку на бота «Client Challenge». Помилки на них ми не записували на рахунок PyPI.
Ще аудит позначив зображення, які не завантажуються. Багато зображень на сторінках пакетів виявилися маленькими значками з інших сайтів, і перевірити кожен ми не змогли, тож не враховували їх.
Одне число, яке варто запам’ятати
4%.
Саме така частка відвідувань PyPI з пошуку в США припадає на людей, які вводять його назву. Усі інші ввели назву пакета, наприклад pip чи requests.
І потрапили на просту сторінку саме з такою назвою і командою встановлення вгорі. Жодних хитромудрих текстів, жодних довгих посібників.
Ось урок для кожного сайту з великою кількістю продуктів. Називайте кожну сторінку тим, що шукають люди, і нехай старі копії вказують на основну.
Які ваші сторінки люди знаходять, ще не знаючи вашої назви? Перевірте їх так, як це зробив би Google.
Кожну з цих перевірок можна запустити для свого сайту й для сайтів конкурентів і побачити ті самі цифри на власні очі.
Часті запитання
Чи варто зберігати сторінки старих версій продукту?
Зберігайте, якщо вони ще потрібні людям, як-от старі інструкції чи минулі випуски. Пропишіть у кожній канонічний тег з адресою основної сторінки, щоб Google знав, яку з них ставити в топ.
Чи достатньо канонічного тегу, чи потрібен ще й noindex?
Зазвичай канонічного тегу досить. Google сприймає його як сильну підказку, а не як правило, тож час від часу перевіряйте, чи в топі досі основна сторінка. Не ставте обидва теги на одну сторінку, бо вони суперечать один одному.
Чи може перевірка на бота зашкодити позиціям у Google?
Лише якщо вона зупиняє Google. Більшість перевірок пропускає відомих пошукових краулерів, але через неправильне налаштування їх можна заблокувати. Після кожної зміни правил для ботів перевіряйте ключові сторінки.
Як побачити свою сторінку очима Google?
Скористайтеся інструментом URL Inspection у Google Search Console. Він показує сторінку такою, якою її отримав Google, тож ви помітите перевірку на бота чи відсутній заголовок, перш ніж утратите через них відвідувачів.
Що має бути в заголовку сторінки програми?
Почніть із точної назви, яку шукають люди. Потім кількома словами додайте, що вона робить, а наприкінці, якщо лишиться місце, назву свого сайту.
Які структуровані дані підходять для сторінки пакета чи програми?
Код SoftwareApplication описує назву, версію і тип програми. Підійде й код Breadcrumb, а ще можна додати дату випуску, щоб Google не довелося її вгадувати.
Чи потрібен мені файл llms.txt?
Він не обов’язковий, і поки що його читають не всі інструменти ШІ. Але написати його недовго, а інструменти ШІ отримають коротку карту найважливіших сторінок вашого сайту.
Скільки часу минає, поки нові заголовки й описи з’являться в Google?
Зазвичай від кількох днів до кількох тижнів, залежно від того, як часто Google заходить на ваші сторінки. Популярні сторінки оновлюються першими. Google усе одно може переписати опис, якщо вирішить, що інший рядок краще відповідає запиту.