Open Library залучає з Google у США близько 312 000 відвідувань на місяць, і майже половина з них припадає на головну сторінку, яка посідає перше місце за простими запитами на кшталт «read books online free».
Open Library, безкоштовну онлайн-бібліотеку, веде Internet Archive. Мета бібліотеки: створити веб-сторінку для кожної книжки, яка будь-коли виходила друком.
Ми перевірили її всіма нашими SEO-інструментами. І знайшли перевірку на бота, яка пропускає Google, але зупиняє інших відвідувачів, а ще іспанську назву на англомовній сторінці книжки.
Нижче 9 уроків, які можна перейняти, і те, чого повторити не вийде.
Ловіть запити без вашої назви
Почали ми з нашого інструмента «Перевірка органічного трафіку». Він оцінює органічний трафік, тобто скільки людей знаходять сайт у Google без реклами.
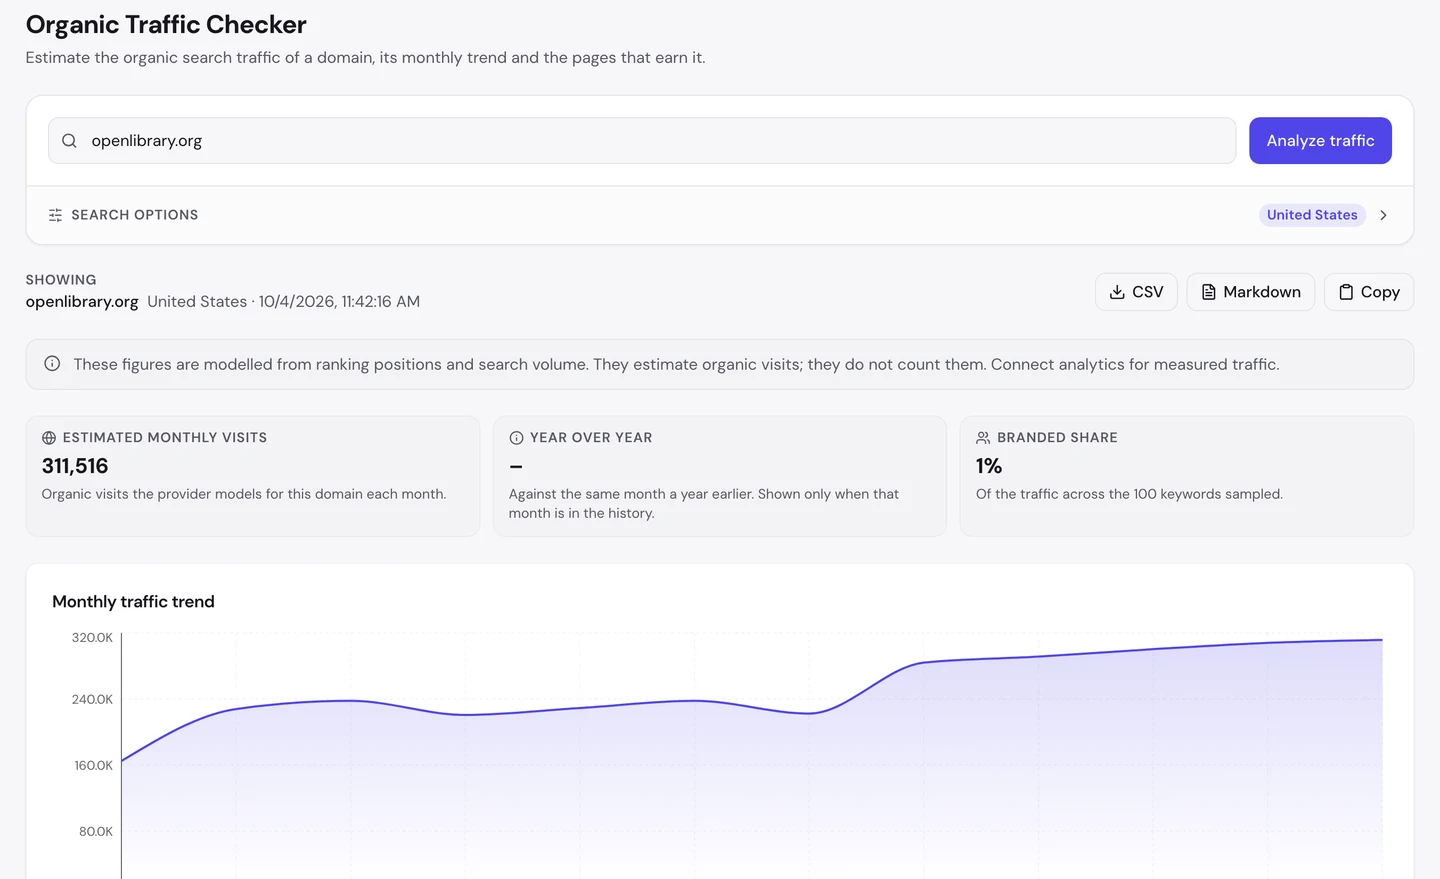
Для openlibrary.org це близько 312 тис. відвідувань на місяць у США. За останній рік трафік зріс майже вдвічі.
Майже половина цих відвідувань припадає на одну сторінку: головну. Тож ми подивилися, за якими запитами її знаходять.
Вкладка Keywords у нашому інструменті «Аудит сайту» збирає запити, за якими сайт з’являється в Google. Для кожного видно позицію сайту і скільки відвідувань цей запит приносить.
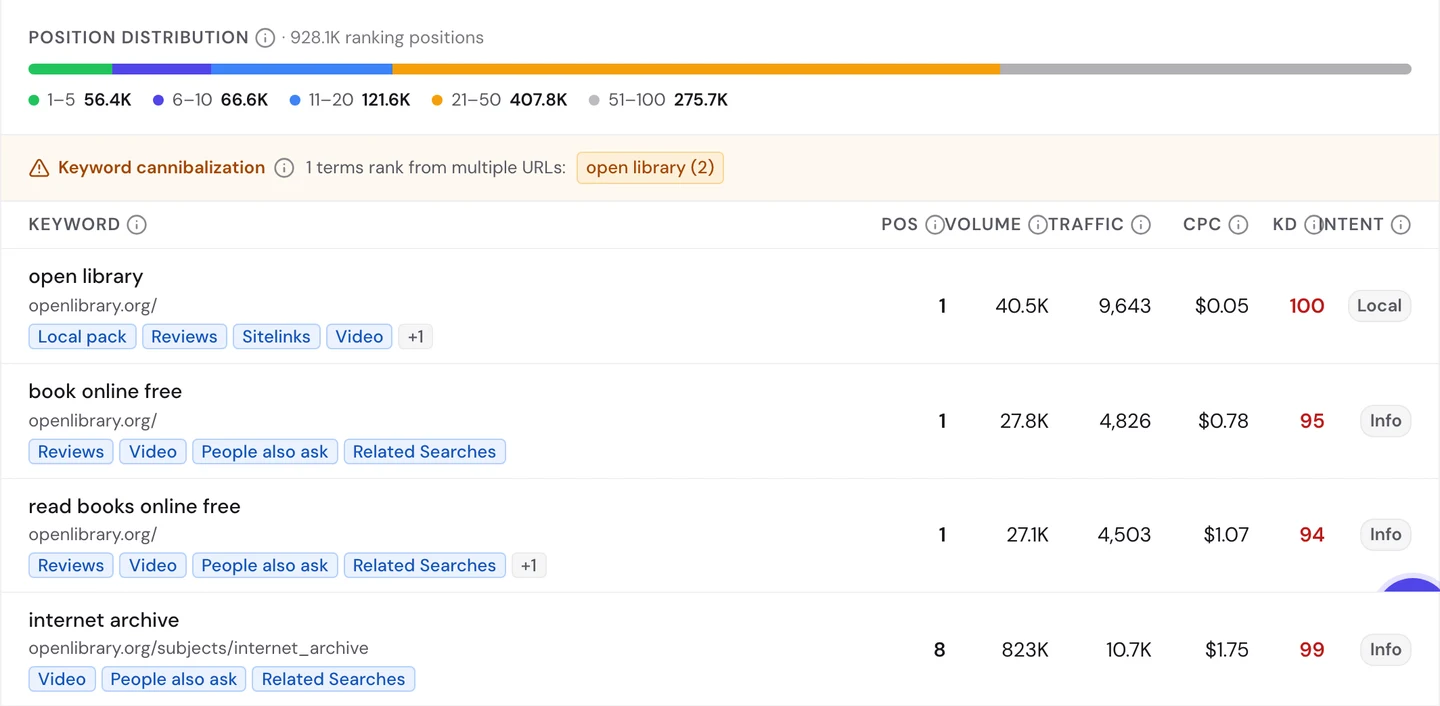
Головна посідає перше місце за запитом «open library», і це логічно. Ці люди шукали сайт за назвою.
Але вона перша і за запитами «book online free» та «read books online free». Кожен із них вводять близько 27 тис. разів на місяць, і в жодному немає назви Open Library.
Ці люди просто хочуть безкоштовну книжку. Якщо ви колись таку шукали, то, можливо, теж туди потрапляли, навіть не знаючи, що це за сайт.
Є й невеликий нюанс. Вкладка попереджає про канібалізацію ключових слів: це коли ваші ж сторінки змагаються між собою за той самий запит.
Тут ідеться про сам запит «open library». За ним у Google з’являються і головна, і сторінка пошуку, але більшість відвідувань забирає головна.
Вкладка Traffic в аудиті показує трафік з усього світу, а не лише зі США.
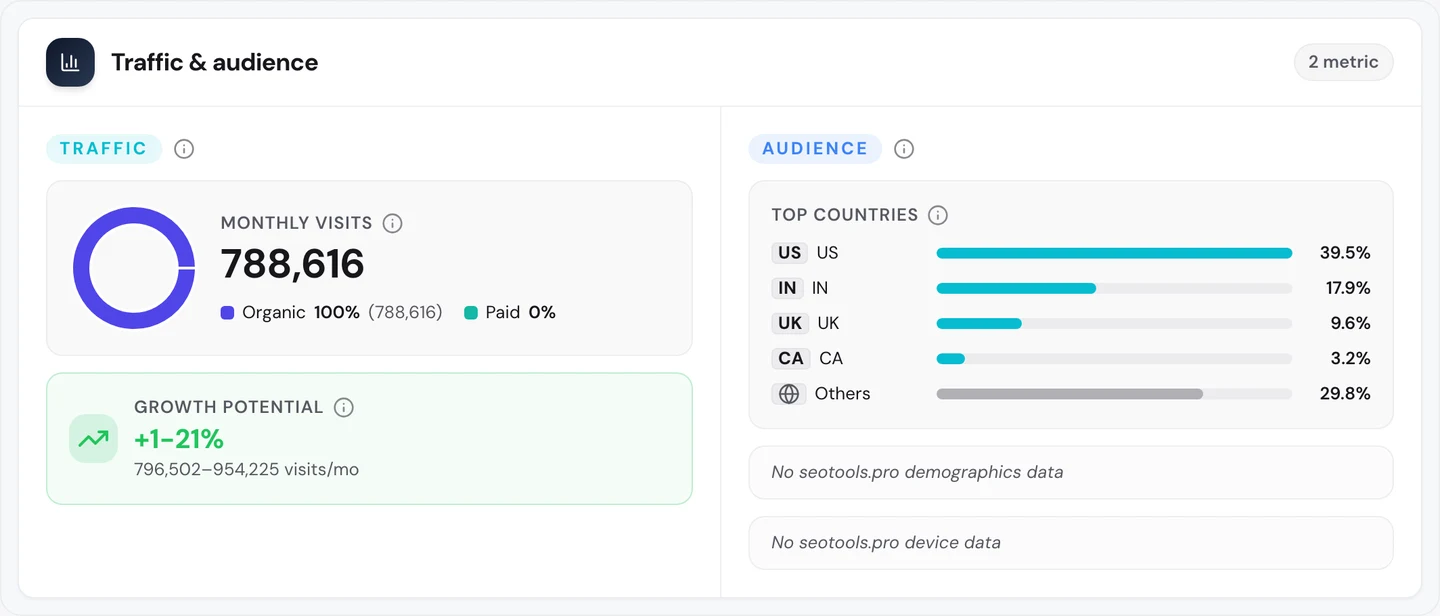
У всьому світі Open Library залучає близько 790 тис. відвідувань із пошуку на місяць і не платить за жодне з них. Приблизно 2 з 5 припадають на США, а далі йде Індія.
Тож робіть головну сторінку під слова, які вводять новачки, а не лише під свою назву. Наш інструмент «Дослідження ключових слів» знайде ці слова, а Перевірка органічного трафіку покаже, які сторінки збирають за ними трафік.
Пропускайте потрібних ботів
Далі нам захотілося подивитися на сторінку окремої книжки. Ми вибрали Fantastic Mr Fox Роальда Дала.
Ми відкрили її в браузері, яким керує програма: саме так сторінки перевіряють наші інструменти. Але книжки Open Library нам не показала.
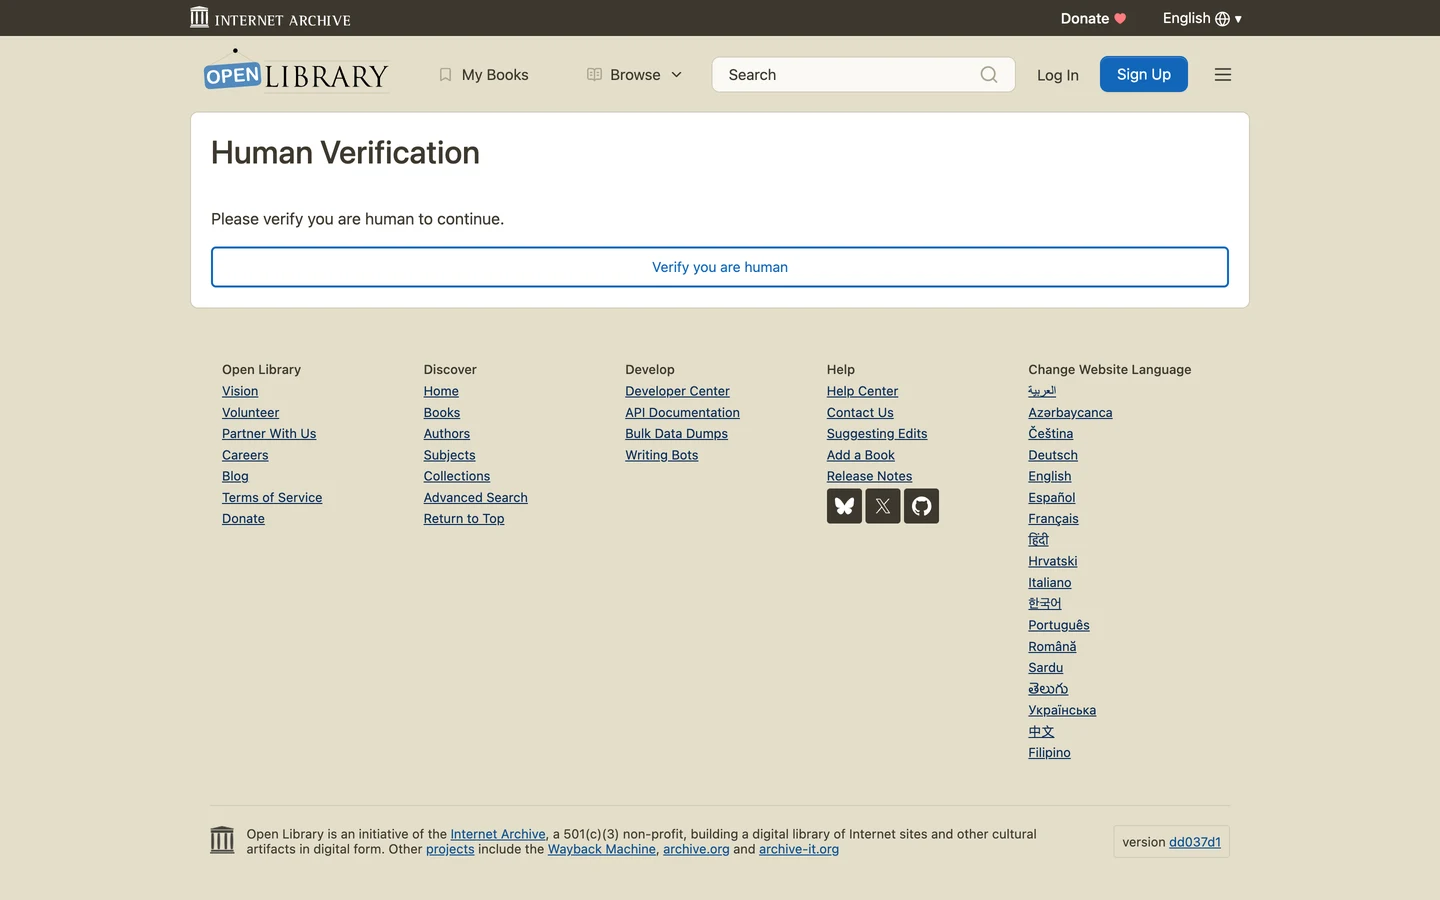
Натомість ми потрапили на сторінку «Human Verification». Щоб пройти далі, треба було довести, що ми люди.
Такі перевірки на бота не рідкість. Вони зупиняють скрейперів, тобто програми, які масово копіюють сторінки.
Потім наше безкоштовне розширення для браузера перевірило ту сторінку, яку отримало. Відкрийте сторінку, натисніть значок seotools.pro, і поруч з’явиться панель із SEO-перевірками цієї сторінки.
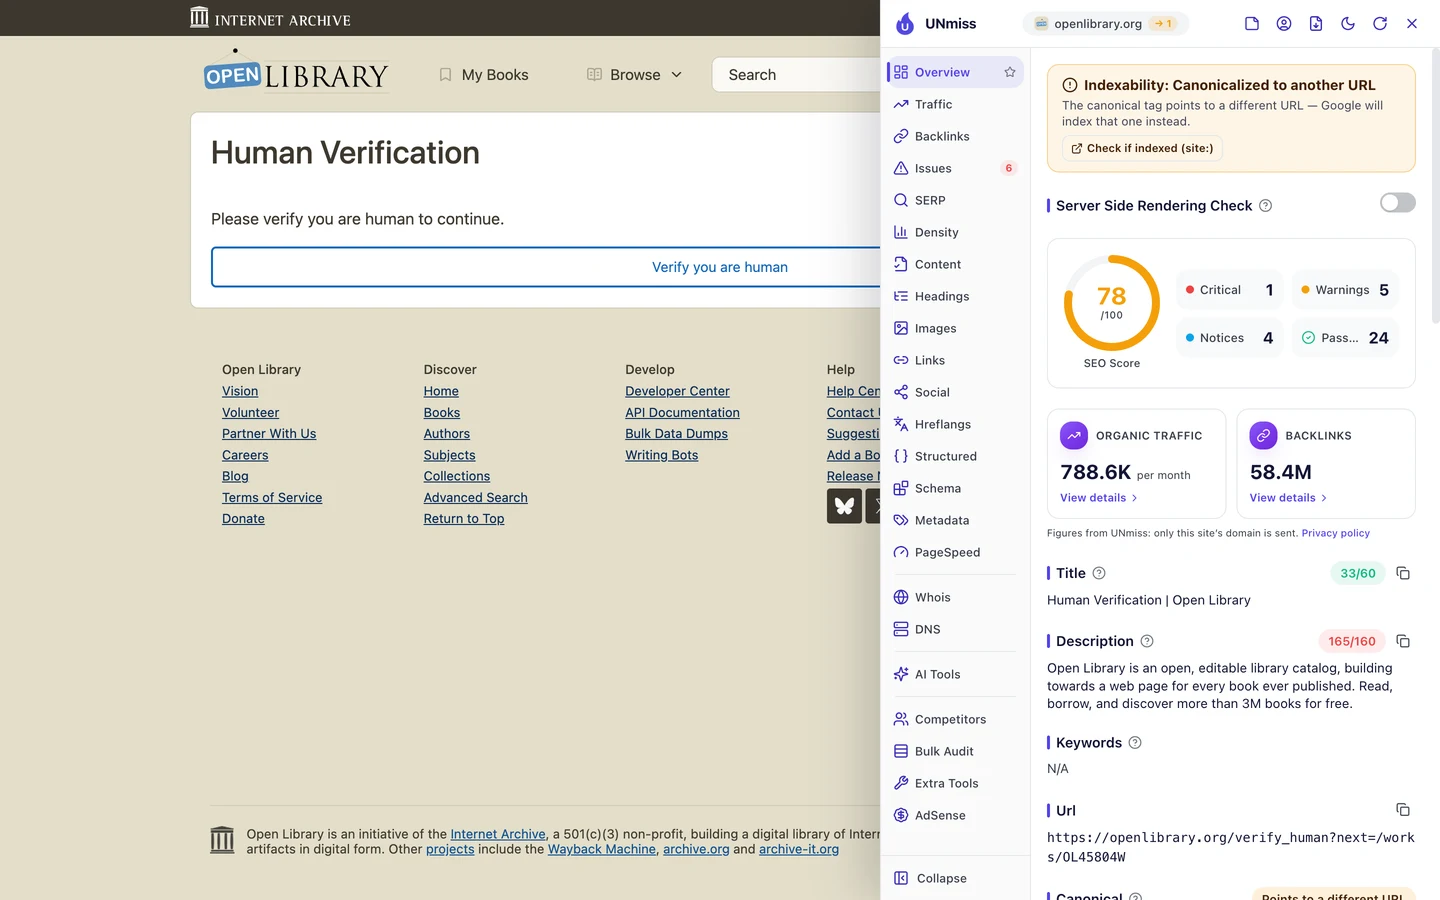
Заголовок сторінки такий: «Human Verification | Open Library». Змінилася й адреса: тепер це сторінка перевірки з кодом книжки в кінці.
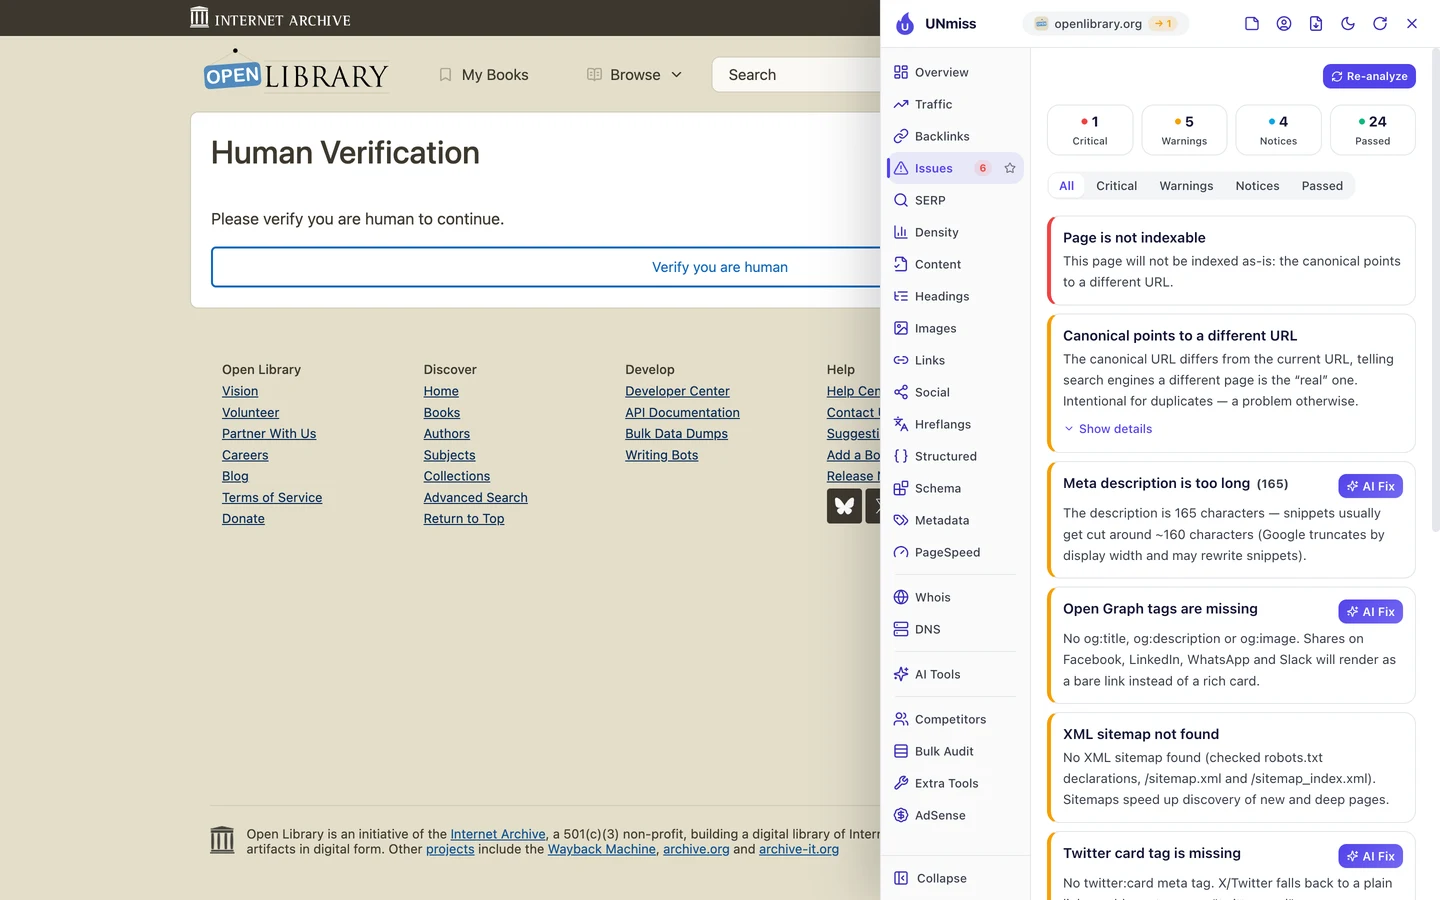
Перша проблема в списку: сторінка не потрапить в індекс, тобто Google не додасть її до пошуку. Тег canonical підказує Google, яку адресу вважати основною, і тут він вказує на іншу.
Для сторінки перевірки це нормально. Ви ж не хочете, щоб Google показував її в пошуку.
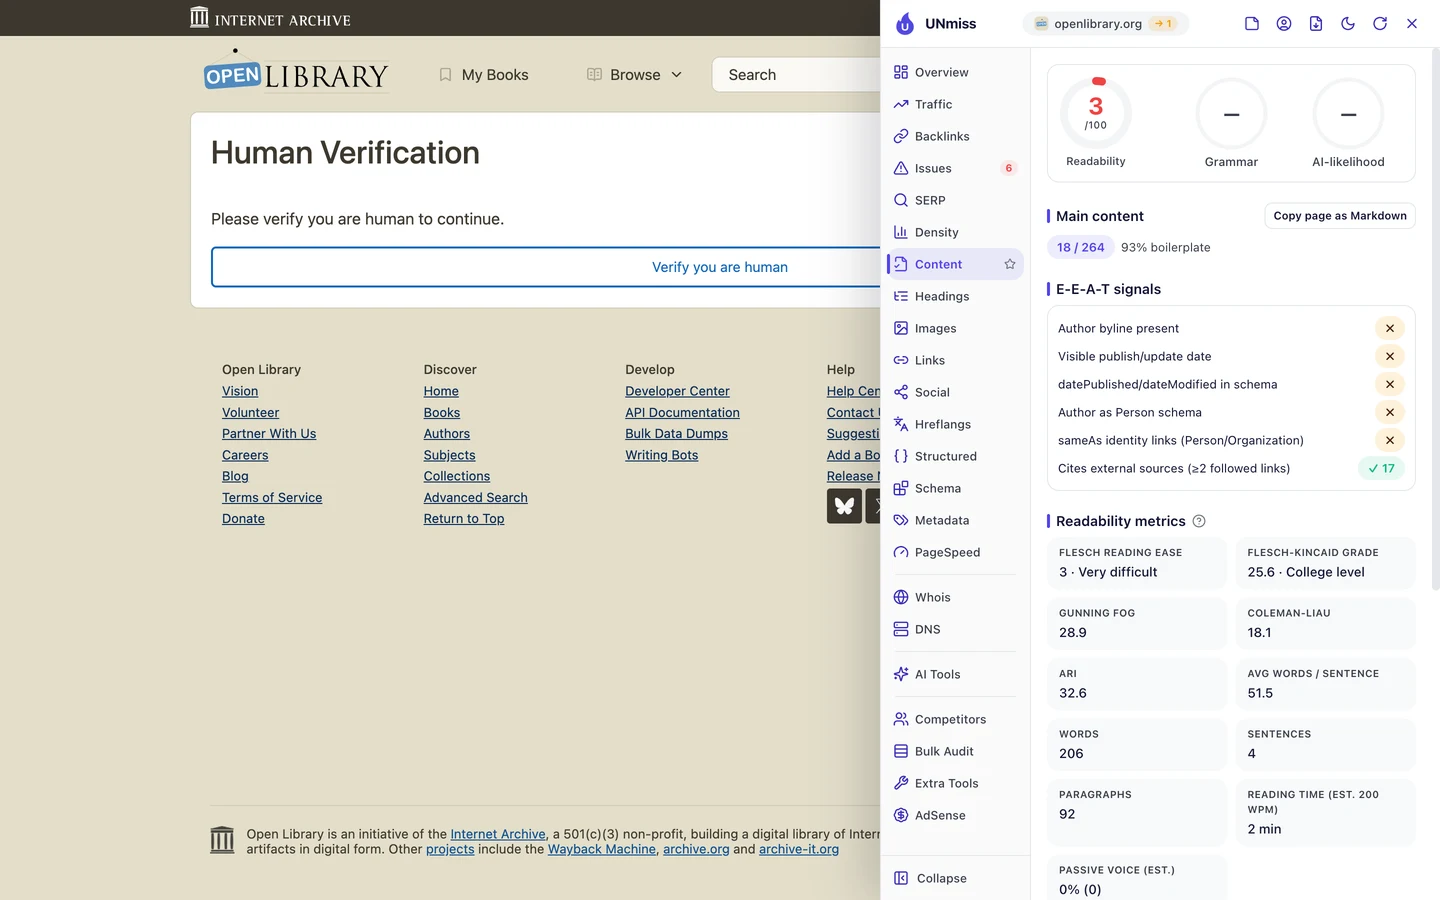
Вкладка Content показує, наскільки вона порожня. Справжній вміст тут займає лише 18 слів із 264, а решта припадає на меню й футер.
То чи потрапляє на неї й Google? 4 жовтня ми провели простий тест.
Кожен браузер і кожен бот надсилає user agent, тобто ім’я, яким він представляється, коли просить сторінку. Ми попросили сторінку книжки під 3 різними іменами.
Краулер Google називається Googlebot. Це програма, яка відвідує сторінки, щоб Google міг показувати їх у пошуку. А краулер OpenAI, компанії, яка створила ChatGPT, називається GPTBot.
Коли ми назвалися звичайним браузером, Open Library відправила нас на сторінку перевірки. А під іменами Googlebot і GPTBot ми отримали справжню сторінку книжки.
Тож Open Library пускає пошукових і ШІ-краулерів, а всіх інших просить довести, що вони люди. Схема розумна, поки працює як слід.
Але є ризик. Якщо таке правило колись дасть збій, Google може побачити сторінку перевірки замість усіх книжок одразу.
Правила для краулерів є ще й у файлі robots.txt, який підказує їм, що можна читати. Розширення розбирає цей файл за вас.
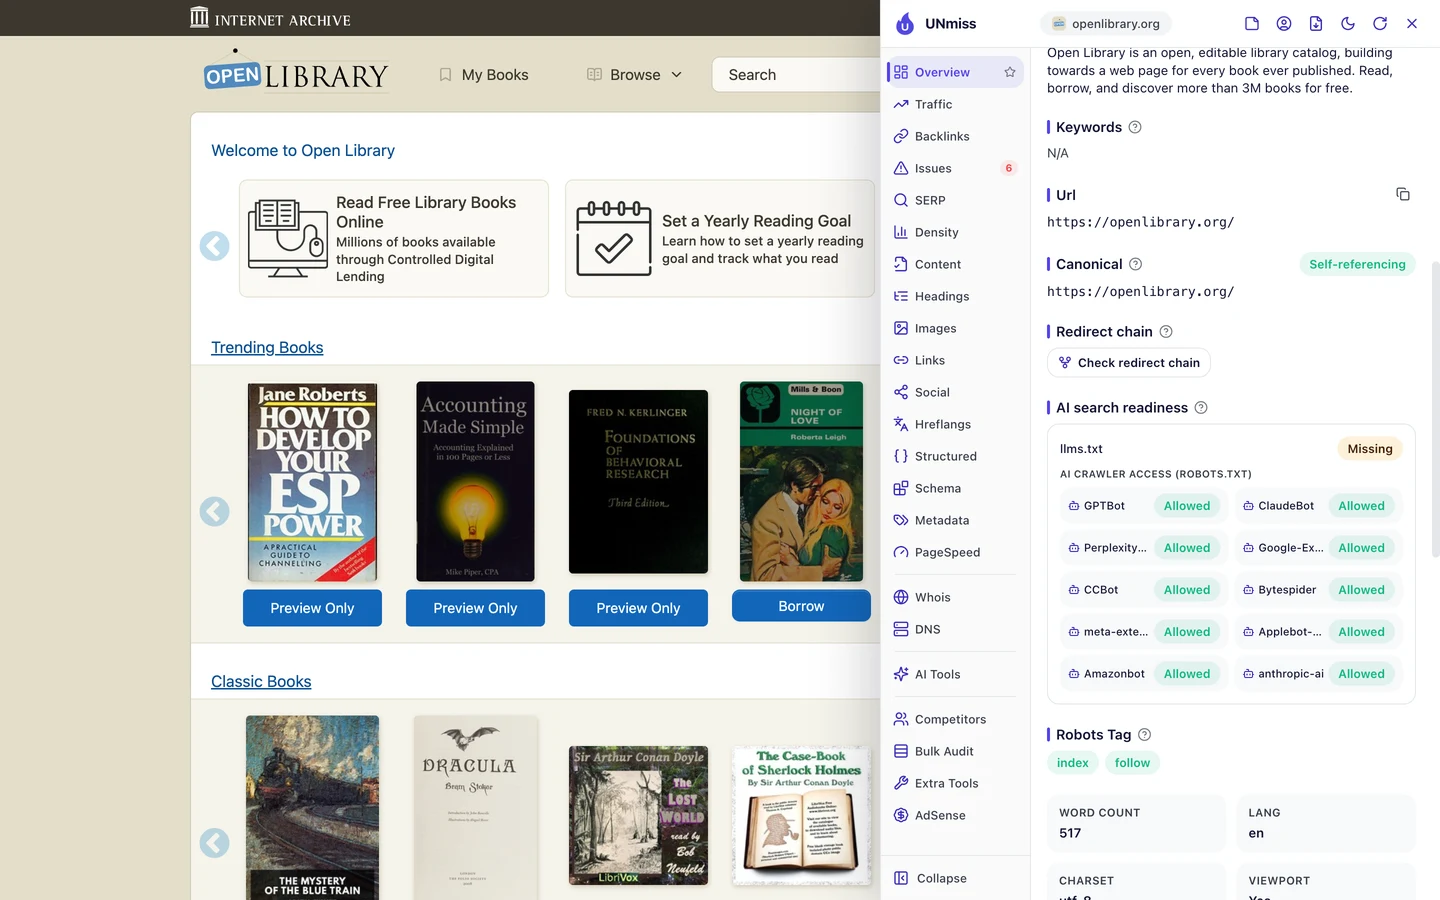
Файл robots.txt в Open Library пускає всіх 10 ШІ-краулерів, яких перевіряє розширення. Але немає llms.txt, короткого файлу, який пояснює інструментам ШІ, про що сайт.
Як великі сайти поводяться з ШІ-краулерами, ми розбирали в нашому кейсі про robots.txt. А наш кейс про llms.txt показує, хто користується цим файлом.
Тож якщо у вас є перевірка на бота, тестуйте свої сторінки так, як їх бачать Google, ШІ-краулери і звичайний відвідувач. Складіть правила для краулерів у нашому генераторі robots.txt, а потім перевірте в нашому інструменті «Перевірка видимості в ШІ», чи згадують вас інструменти ШІ.
Open Library показує перевірку на бота незнайомим відвідувачам, а пошукових і ШІ-краулерів пропускає. Ми перевіримо ваш сайт так, як його бачать Google, інструменти ШІ і живі люди, а потім виправимо все, що кожен із них бачить не так.
- Перевіримо ваші ключові сторінки очима Google, ШІ-краулерів і живих відвідувачів
- Проаналізуємо ваші правила для ботів, robots.txt і llms.txt
- Виправимо сторінки, які показують краулерам сторінку перевірки або неправильний заголовок
- SEO і GEO, щоб вас цитували й у відповідях ШІ
Обирайте назву, яку шукає більшість
На справжній сторінці книжки нас чекав ще один сюрприз. Її заголовок, тобто синє посилання, яке Google показує для сторінки, виявився зовсім не тим, якого ви б очікували.
Для Googlebot сторінка Fantastic Mr Fox мала заголовок «El Superzorro by Roald Dahl | Open Library». А іспанською ця книжка називається El Superzorro.
Виходить, що англомовна сторінка відомої дитячої книжки отримала назву іспанського видання. Тим часом людина в США шукатиме «Fantastic Mr Fox», а не «El Superzorro».
Open Library збирає багато видань книжки під однією головною сторінкою. Схоже, ця сторінка взяла заголовок не з того видання.
Із заголовком головної проблема менша. Розширення показує її на вкладці Overview.
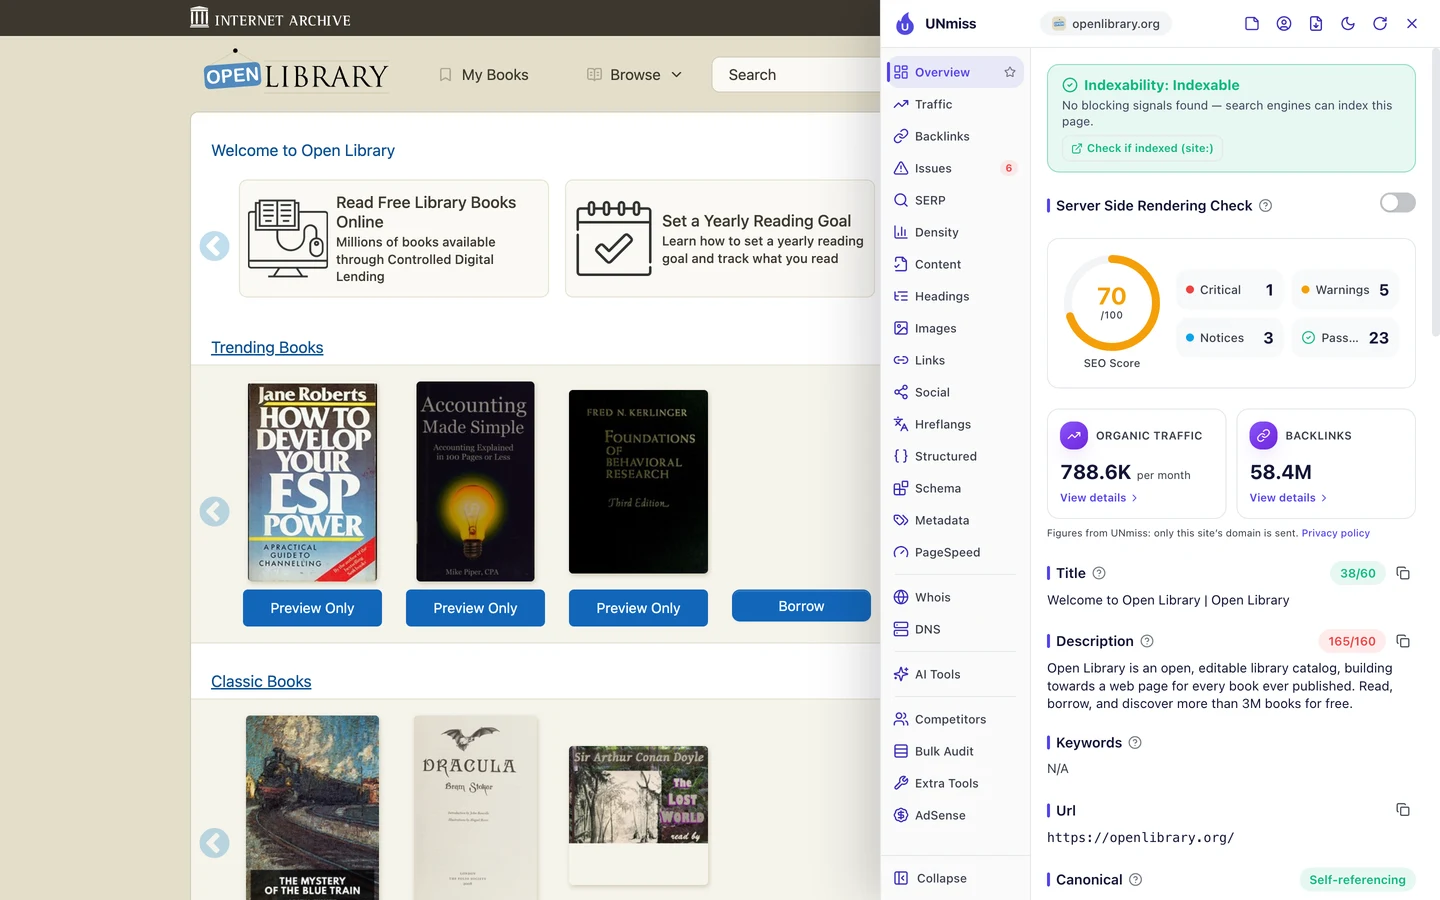
Заголовок такий: «Welcome to Open Library | Open Library», тож назва звучить двічі. При цьому сторінка лідирує за запитами про безкоштовні книжки онлайн, а цих слів у заголовку немає взагалі.
І все одно вона на першому місці. Молодшому сайту, на який веде менше посилань, таке могло б і не зійти з рук.
У PHP.net, який ми теж розбирали, у заголовках стояли назви з коду замість слів, які шукають люди. Рішення тут те саме.
Тож дайте кожній сторінці ту назву, яку шукає більшість, і саме їхньою мовою. Як ваша сторінка виглядатиме в Google, покаже наш Симулятор SERP.
Напишіть опис для кожної сторінки
Опис, тобто короткий підсумок змісту, Google може показати під заголовком сторінки. На головній Open Library він займає 165 символів.
А Google зазвичай обрізає його приблизно після 160 символів. Тож кінець рядка може так і не з’явитися в пошуку.
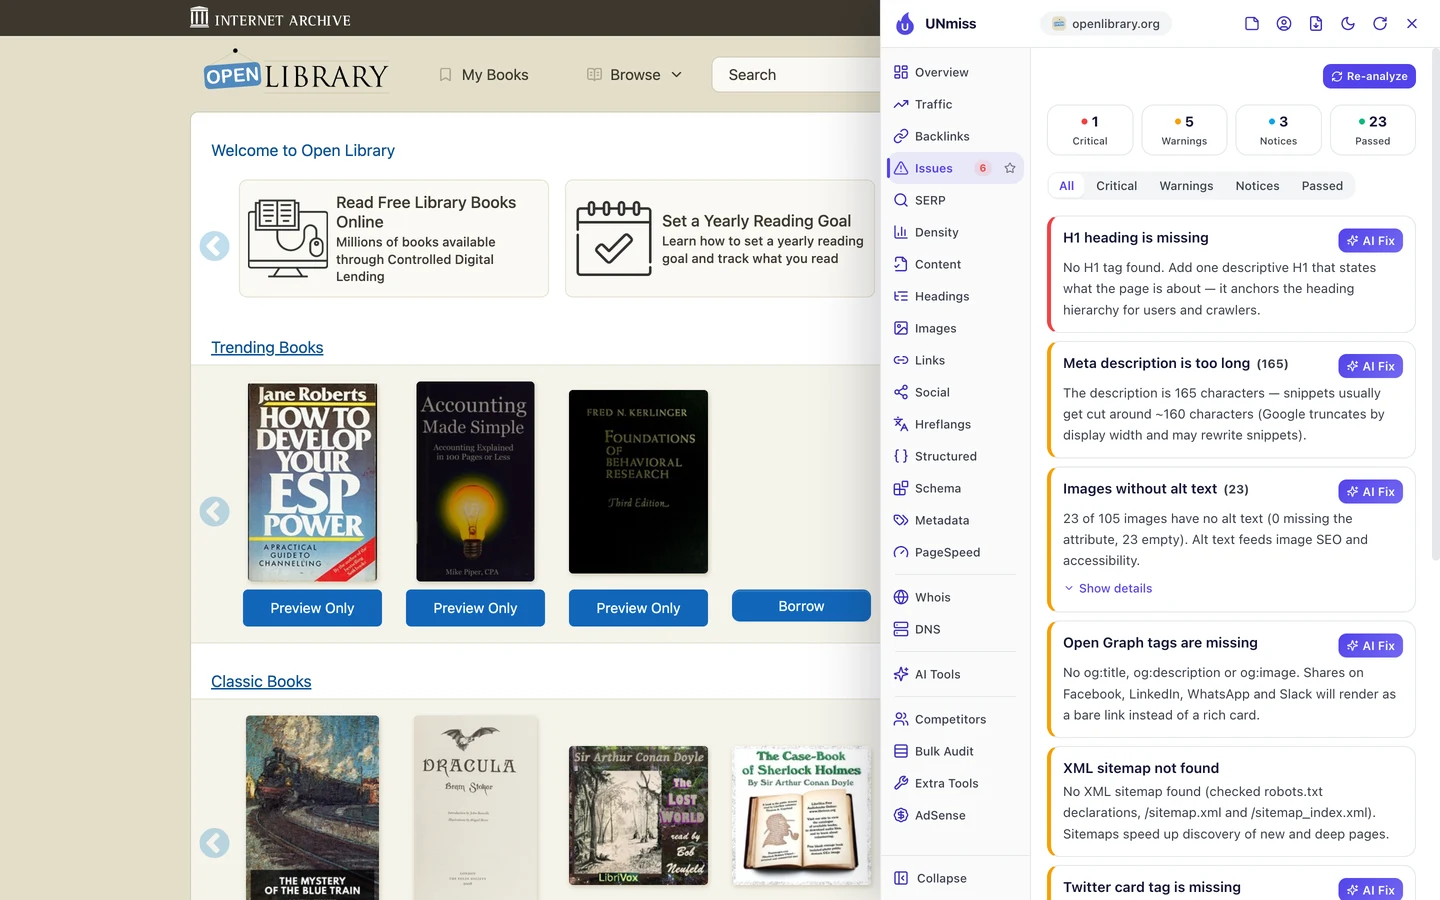
Вкладка Issues ставить на перше місце відсутній H1. Тегом H1 позначають основний заголовок сторінки, а на головній його немає.
Ще вона позначає 23 зі 105 зображень без alt-тексту. Alt-текстом називають короткий опис, який підказує Google і програмам читання з екрана, що зображено на картинці.
А потім ми знайшли дещо серйозніше. Той самий довгий опис кочує зі сторінки на сторінку.
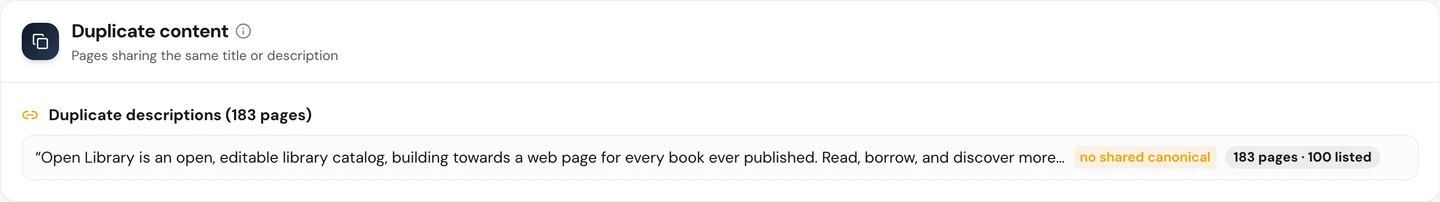
Наш аудит знайшов опис головної на 183 сторінках, слово в слово. Для Google усі ці сторінки виглядають однаково, та й ви в результатах пошуку не відрізните одну від одної.
У такому разі Google часто пише власний підсумок. І вже не ви вирішуєте, що люди прочитають, перш ніж натиснути.
Тож напишіть короткий окремий опис для кожної сторінки або налаштуйте шаблон, щоб він складав опис із даних самої сторінки. Наш Генератор метатегів допоможе його написати й перевірити довжину.
Опишіть кожну книжку в коді
Структурованими даними називають код, який пояснює Google, що це за сторінка: книжка, людина чи місце. Вкладка Structured у розширенні шукає такий код.
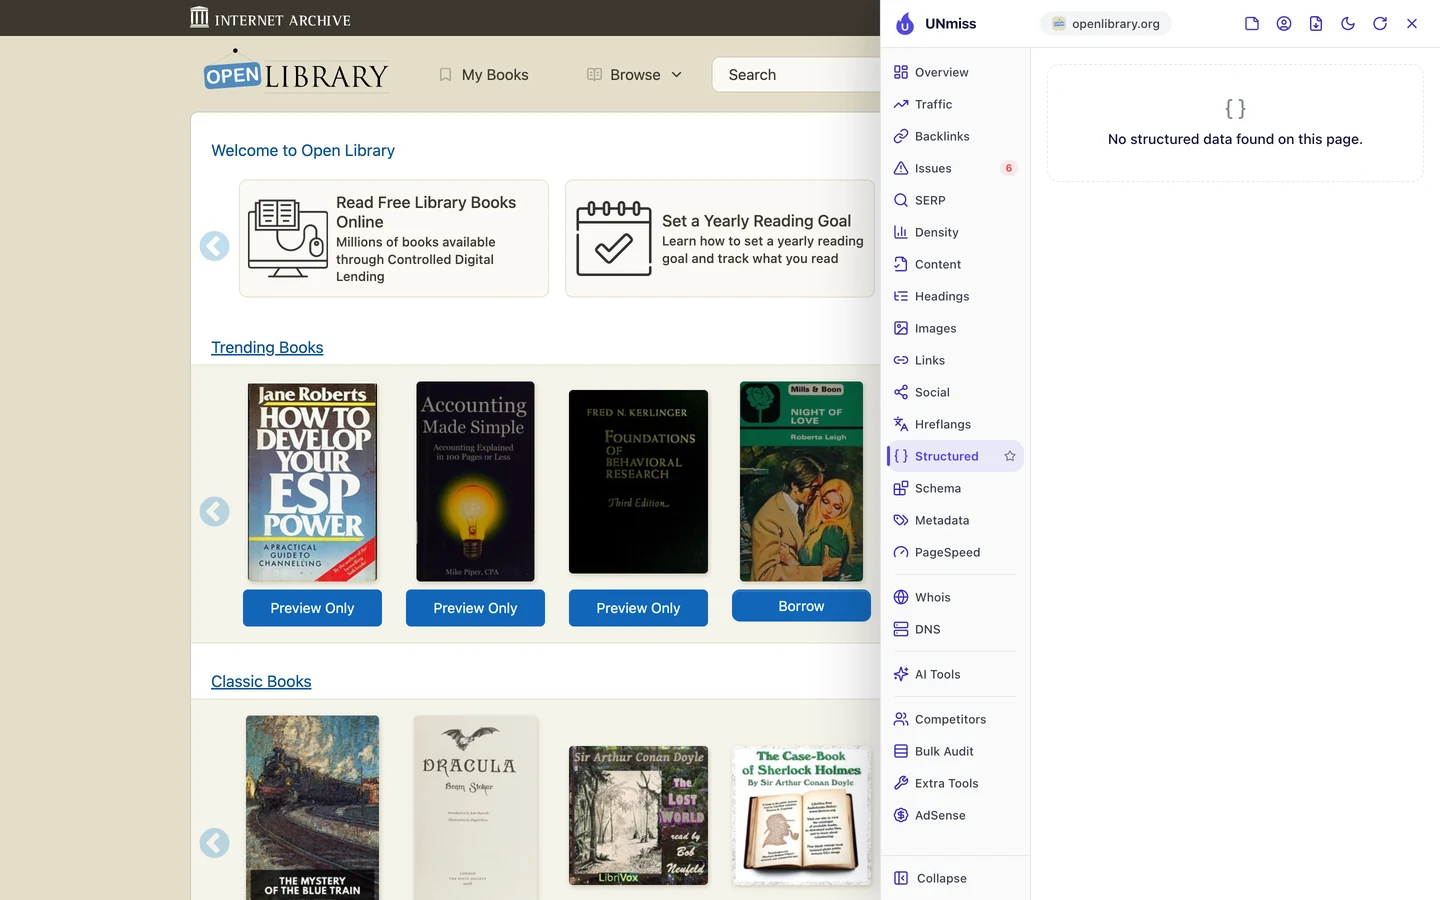
На головній ми їх не знайшли. А зі сторінкою книжки так не вийшло, бо наш тестовий браузер уперся в перевірку на бота.
Для бібліотеки це втрачена можливість. Адже в такому коді є тип Book з полями для автора, видання та ISBN, тобто номера, який друкують на звороті книжки.
Це допомагає й інструментам ШІ. Такий код прямо каже чат-боту, про яку книжку і якого автора йдеться на сторінці, тож гадати не доводиться.
Тож додайте код, який повідомляє, що сторінка розповідає про книжку, хто її написав і яке це видання. Наш Генератор розмітки Schema напише його за вас.
Здобувайте посилання від шкіл
Зворотне посилання (backlink) веде з іншого сайту на ваш. Google сприймає кожне таке посилання як своєрідний голос довіри.
Вкладка Backlinks у нашому аудиті показує ті самі дані, що й наш Аналізатор зворотних посилань.
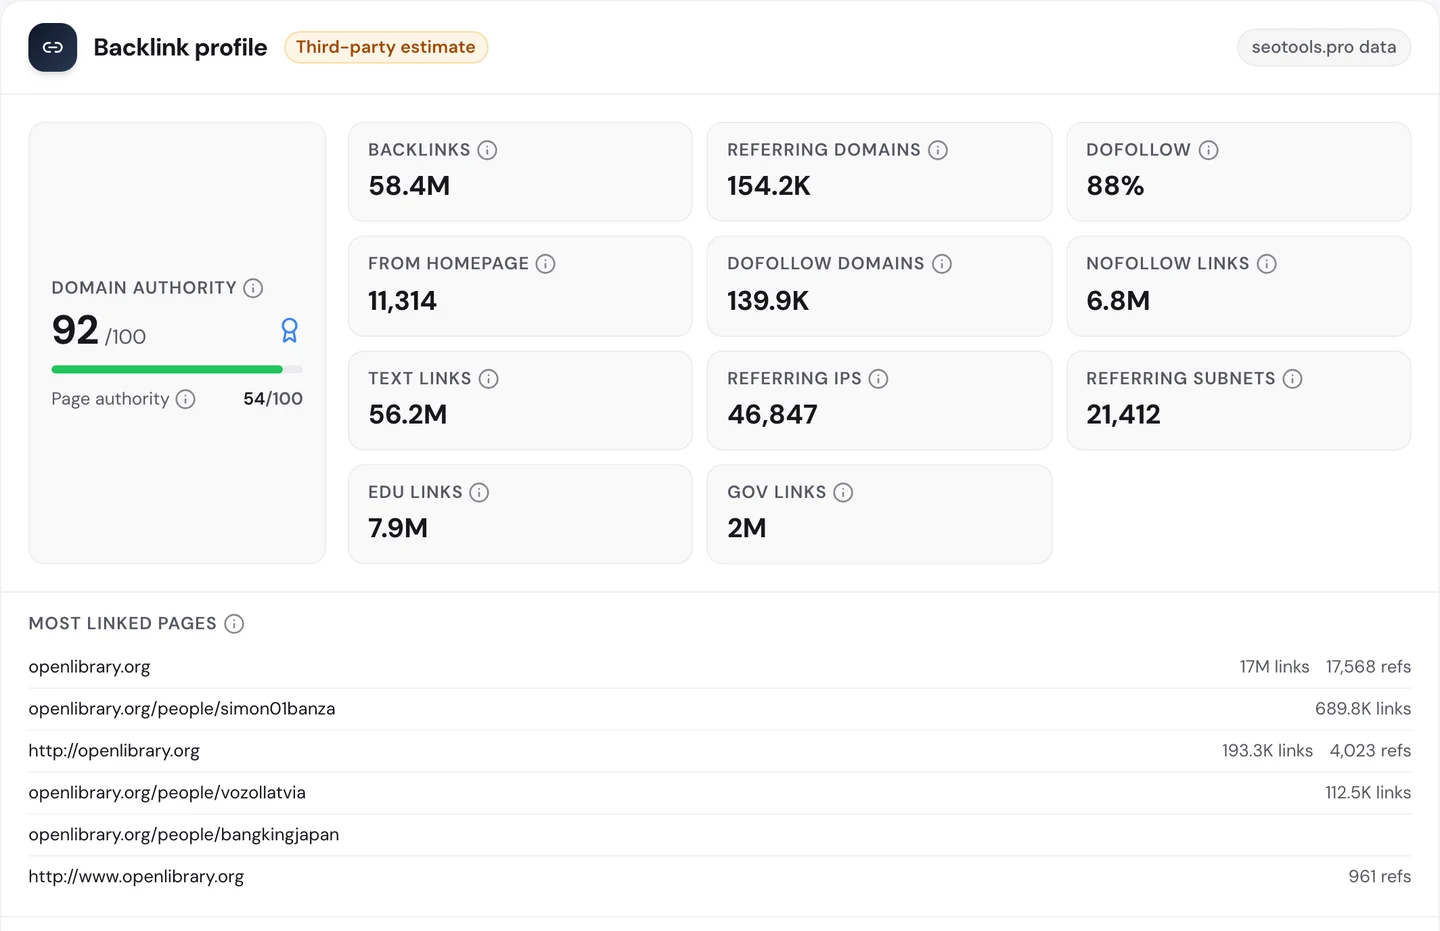
На Open Library веде близько 58 млн посилань приблизно зі 154 тис. доменів-донорів, тобто сайтів, які на неї посилаються. Її Domain Authority, тобто наша оцінка сили посилань сайту за шкалою від 0 до 100, дорівнює 92.
А тепер погляньте на блок EDU. Близько 7,9 млн посилань ведуть із сайтів .edu, тобто з адрес, якими користуються школи й коледжі США.
Ще 2 млн ведуть з урядових сайтів, і для безкоштовної бібліотеки це цілком природно. Такі посилання важко здобути, поки ви самі не стали надійним джерелом.
Але одне варто тримати на оці. Після головної серед сторінок, на які найчастіше посилаються, є кілька профілів учасників.
У Docker Hub, який ми теж розбирали, на самому верху такого списку були профілі, схожі на спам. Якщо у вашому списку вгорі опинився незнайомий профіль, зайдіть на нього й подивіться, що там.
Тож знайдіть людей, які охоче відправлять до вас своїх читачів. Для бібліотеки це вчителі. А потім стежте за кожним новим посиланням у нашому інструменті «Аналізатор зворотних посилань».
Знайдіть запити на межі 1-ї сторінки
Усі ці посилання мали б підняти Open Library високо в Google. Наш Огляд домену показує, яке місце вона займає насправді.
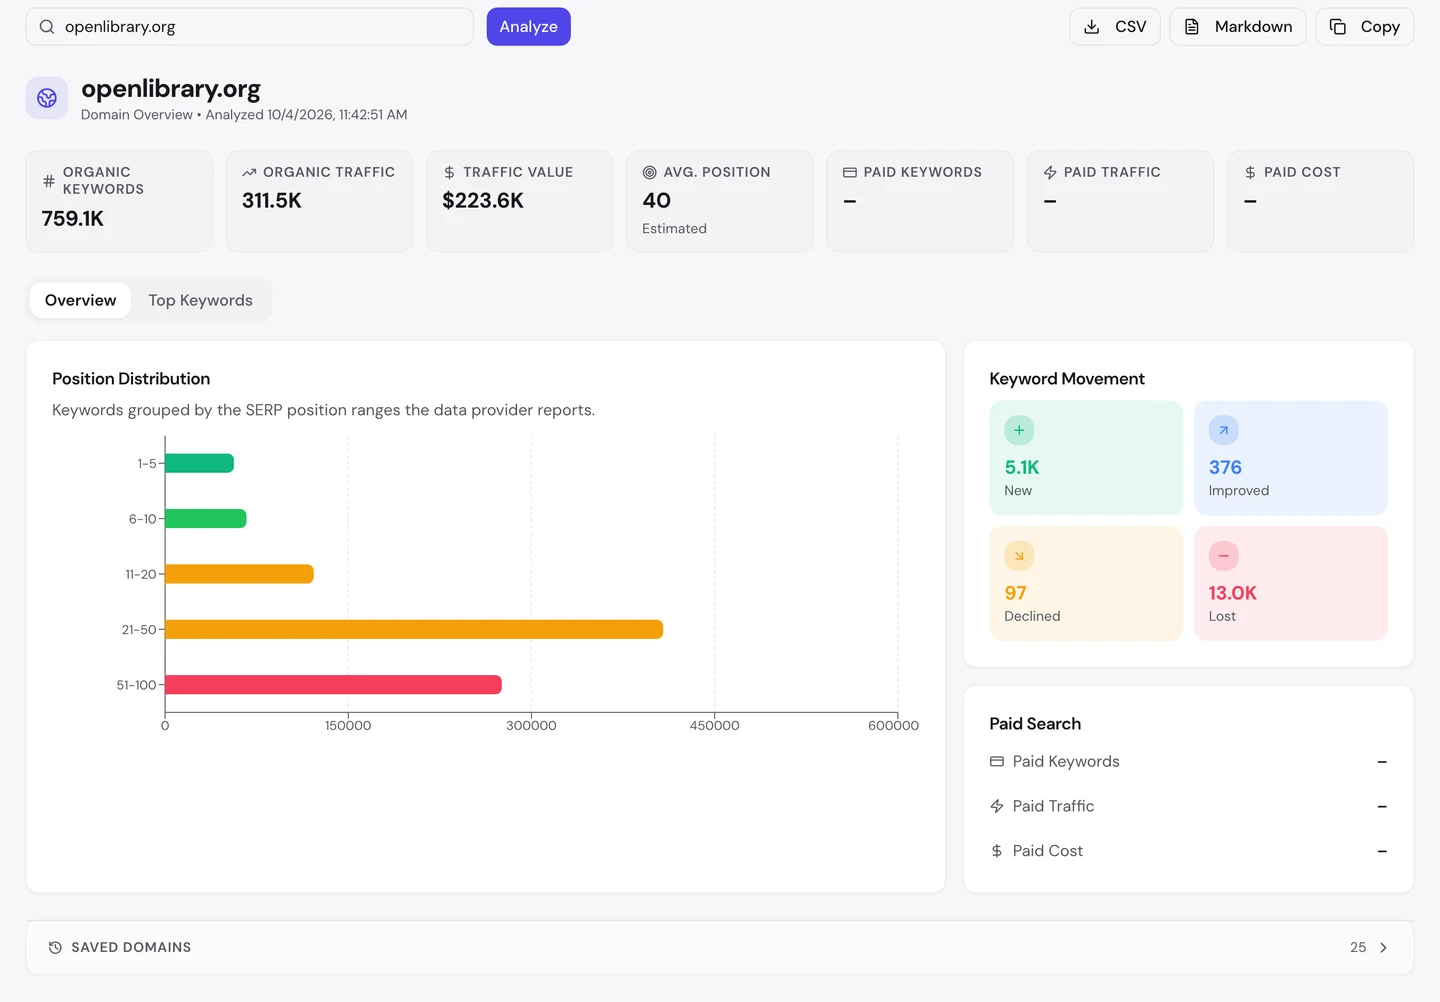
Open Library з’являється в пошуку приблизно за 760 тис. запитів. Вартість її трафіку, тобто скільки коштували б ці відвідування, якби їх купували через рекламу в Google, сягає близько 224 тис. $ на місяць.
Але її середня позиція 40, а це 4-та сторінка Google. Найдовший стовпчик на графіку припадає на позиції з 21 по 50.
Варто глянути й на блок із рухом ключових слів. Сайт здобув близько 5 тис. нових запитів і втратив близько 13 тис.
Якщо хочете швидкого результату, дивіться трохи нижче 1-ї сторінки. Вкладка Keywords в аудиті налічує близько 122 тис. позицій з 11-ї по 20-ту.
Частину цих запитів забирають конкуренти. Хто саме, показує вкладка Competitors в аудиті.
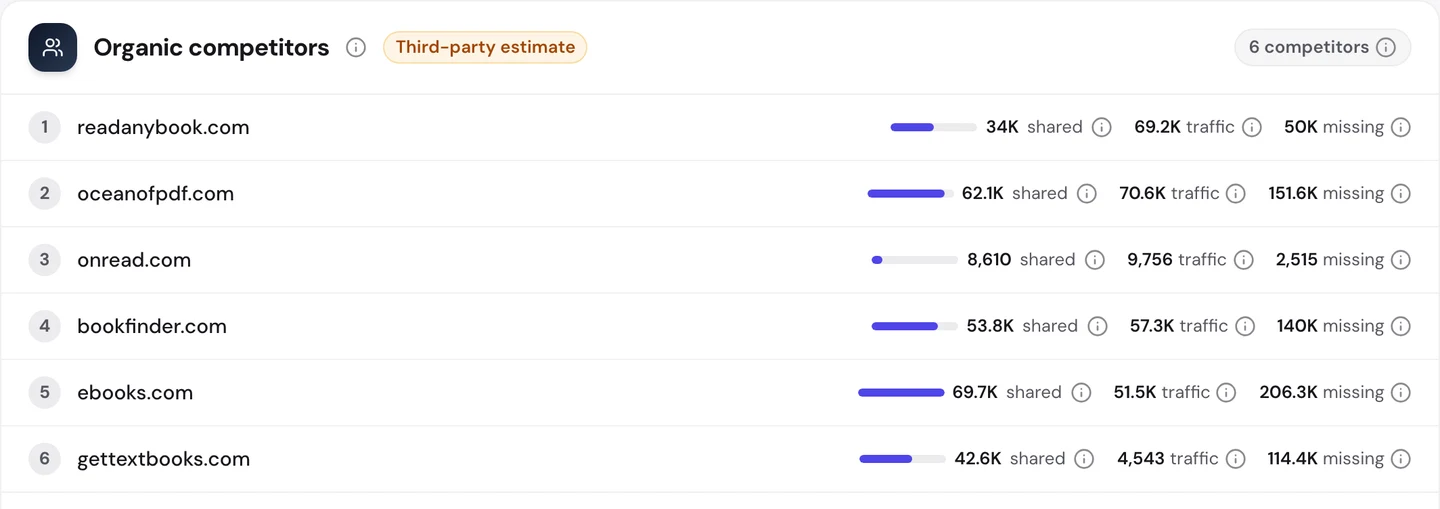
Здебільшого конкуренти виявилися сайтами з безкоштовними електронними книжками. Bookfinder.com має з Open Library близько 54 тис. спільних запитів.
У Ebooks.com таких близько 70 тис. А ще він з’являється в пошуку приблизно за 206 тис. запитів, за якими Open Library там немає.
Стовпчик «missing» можна сміливо брати як готовий список справ. Ви бачите кожен запит, який виграє конкурент, і вирішуєте, чи потрібна вам під нього сторінка.
Тож знайдіть свої ключові слова на позиціях з 11-ї по 20-ту і спершу покращте саме ці сторінки. Перевірте конкурентів у нашому інструменті «Аналіз конкурентів», а потім стежте в Rank Tracker, як ваші сторінки піднімаються.
Зробіть аудит того, що бачить Google
Розширення перевіряє по одній сторінці. А наш Website Audit перевіряє сотні одразу, тож видно, які проблеми повторюються.
Він перевірив 332 сторінки, і Open Library набрала 80 балів зі 100. У звіті це названо хорошим результатом.
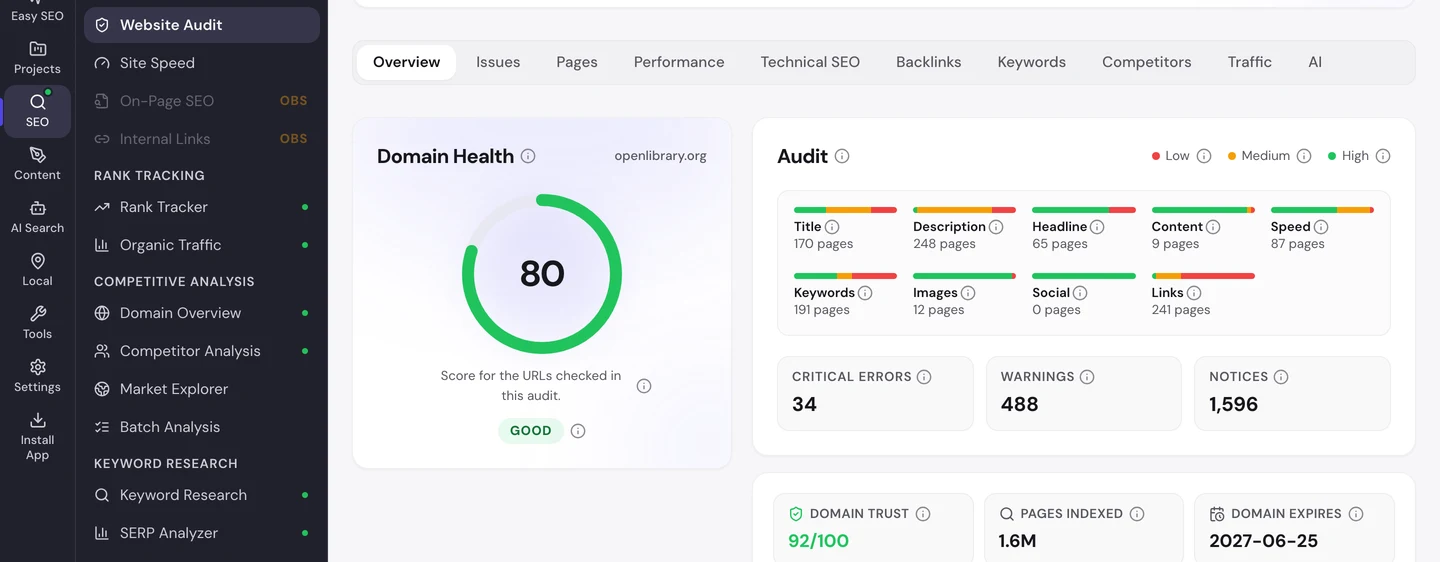
Вкладка Issues сортує проблеми за тим, наскільки вони для вас важливі.
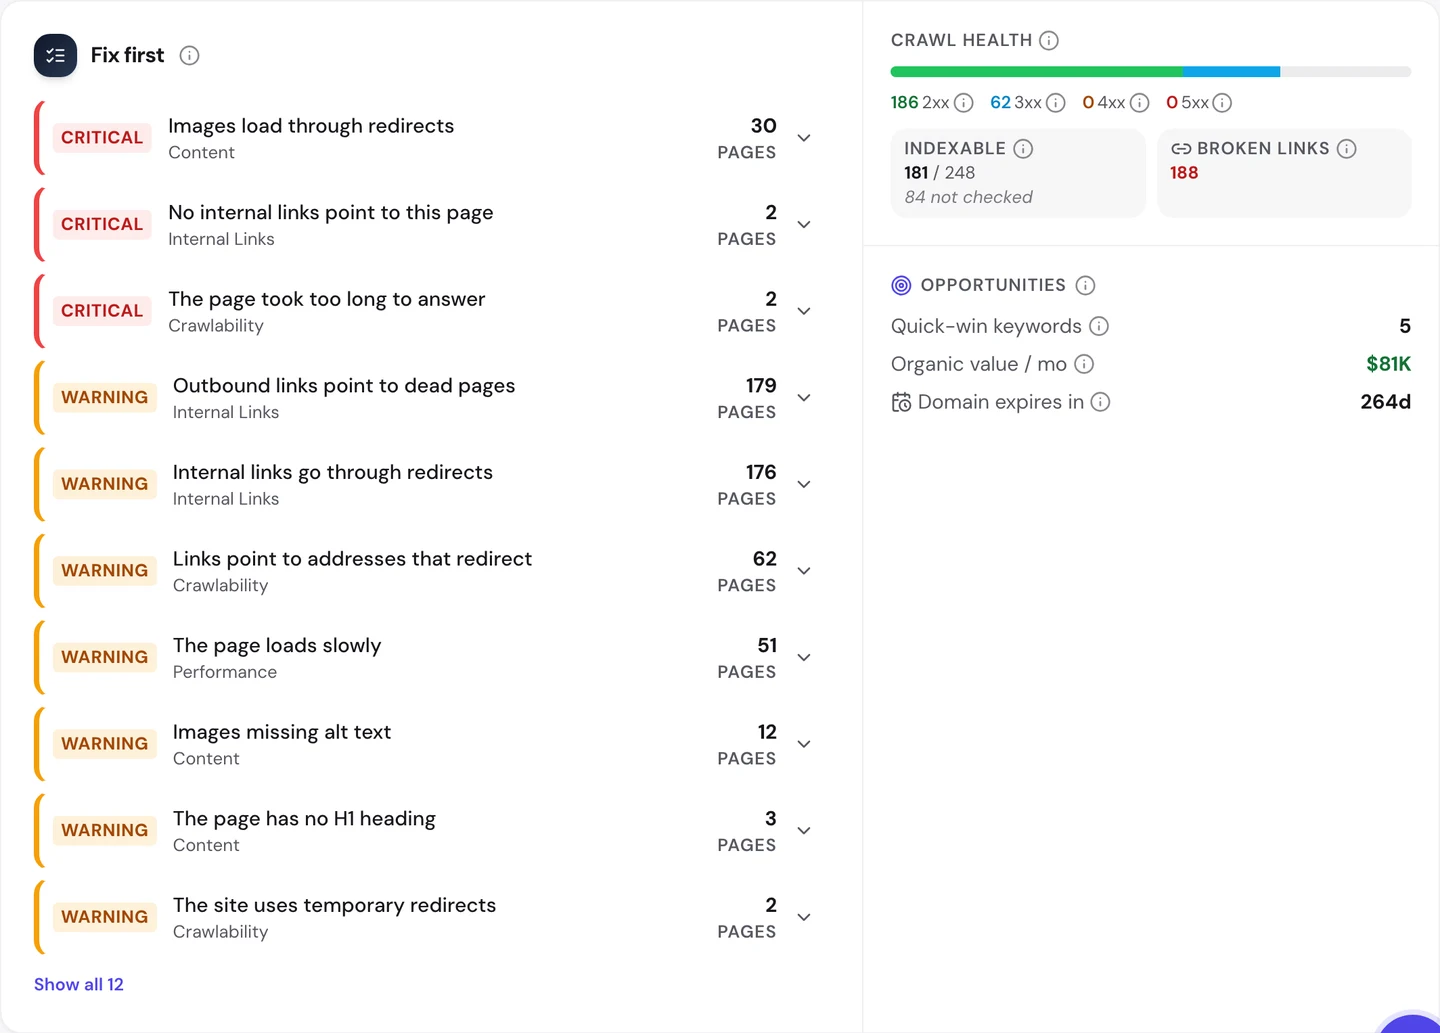
Перша помилка в списку: зображення, які завантажуються через перенаправлення. Адреса картинки веде на старе місце, а звідти браузер відправляють далі, тож кожна картинка робить зайвий гак.
На 2 сторінки не веде жодне посилання. А ще 2 відповідали надто довго.
Більшість попереджень стосуються посилань. Близько 180 сторінок посилаються на неіснуючі сторінки інших сайтів, а близько 175 пропускають власні посилання через перенаправлення.
Вкладка Technical SEO показує, які сторінки Google може додати до пошуку.
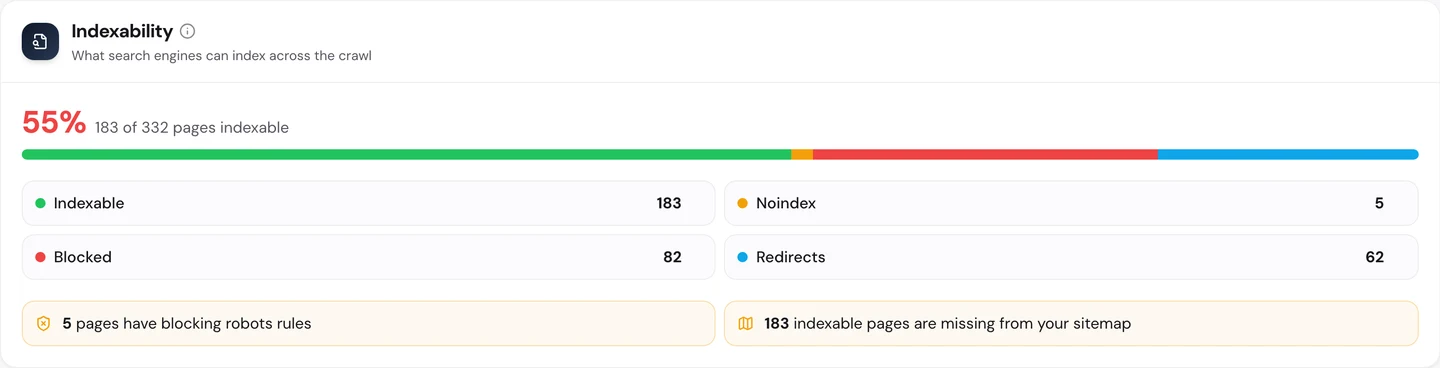
Лише 55% перевірених нами сторінок Google може додати до пошуку. Правила robots блокують 82 з них, а ще 62 перенаправляють деінде.
Частково це зроблено навмисно. Та все ж варто перевірити, чи кожне правило блокує лише те, що ви й задумали.
А ще є карта сайту (sitemap), тобто файл зі списком сторінок для Google. Жодної з 183 сторінок, які Google може додати до пошуку, у ній немає, а розширення взагалі не знайшло її за звичними адресами.
Сайту з мільйонами книжок вона потрібна більше, ніж багатьом іншим. Вона допомагає Google знаходити глибокі сторінки, до яких веде мало посилань.
Вам не треба самим ламати голову, що виправляти першим. Вкладка AI в аудиті складає план: коротке резюме, кожну проблему з порадою, як її виправити, і список справ на 90 днів.
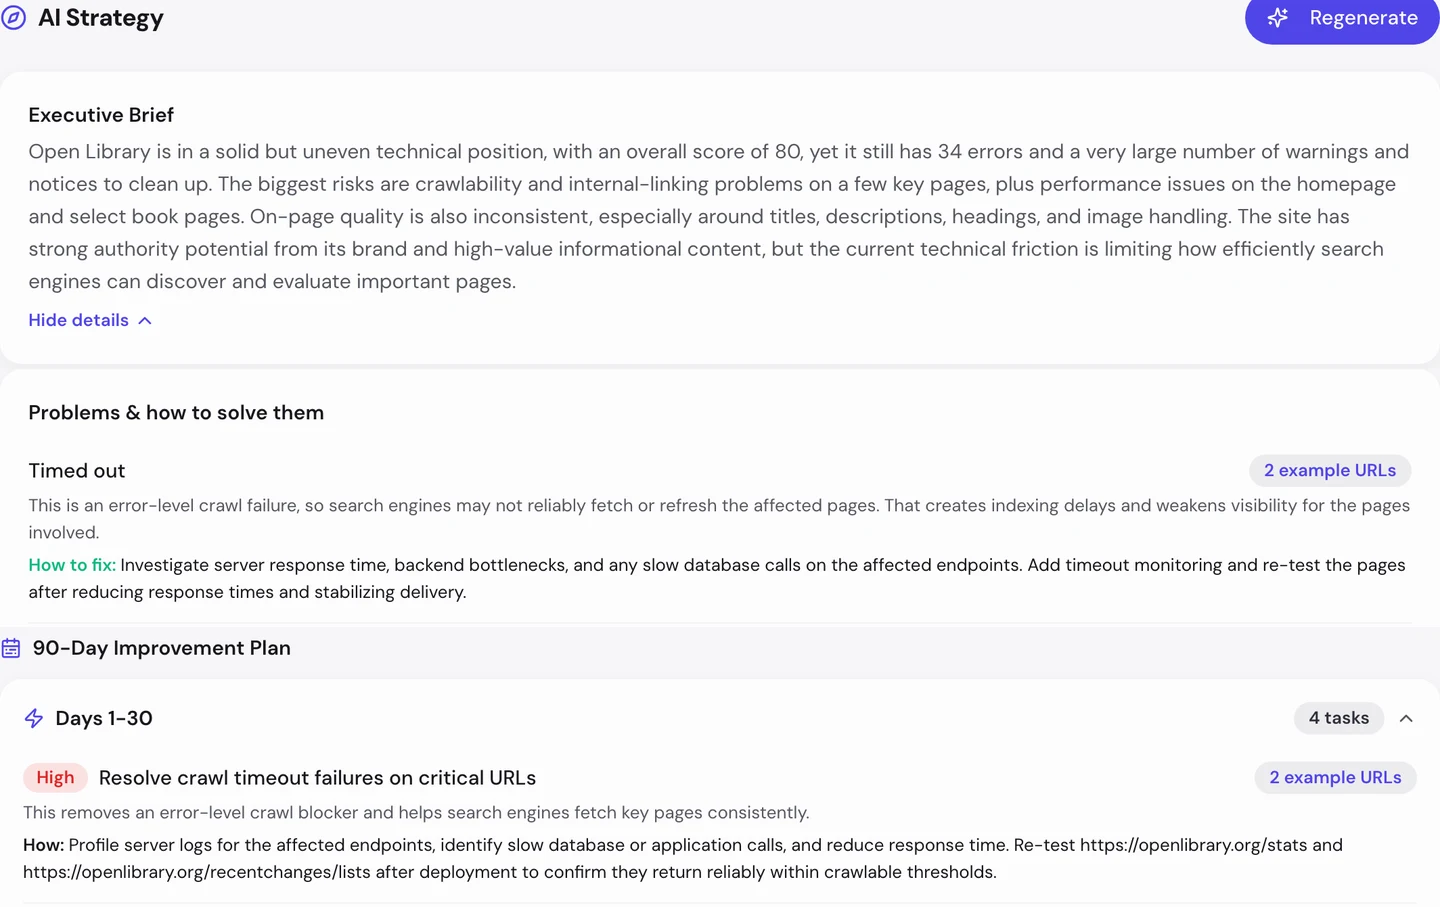
У плані для Open Library перший місяць починається з 2 сторінок, які не встигають відповісти. Далі йдуть зображення з перенаправленням і сторінки, на які не веде жодне посилання.
Тож обходьте свій сайт так, як це робить Google, і виправляйте проблеми, які шаблон повторює на багатьох сторінках. Запустіть наш Аудит сайту, і ви побачите, які виправлення допоможуть сотням сторінок одразу.
Пришвидшіть сторінки на телефонах
І наостанок про швидкість. Коли ми відкрили головну, ряди книжок на ній ще завантажувалися.
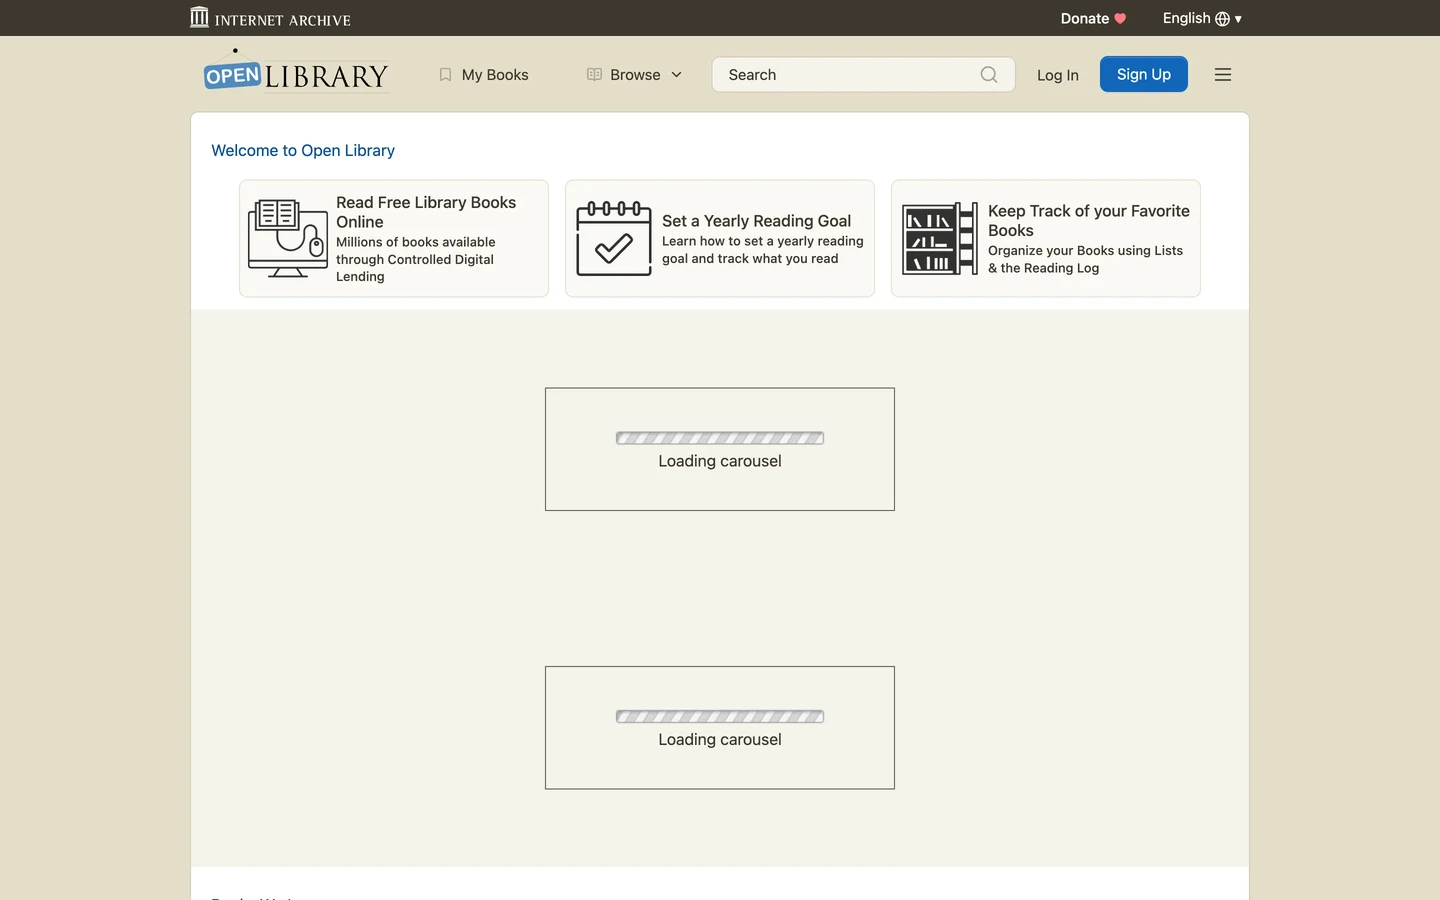
У кожному блоці було написано «Loading carousel». Каруселлю називають ряд обкладинок, який можна прокручувати, і ці ряди заповнилися лише через мить.
Вкладка Performance в аудиті показує Core Web Vitals. Це 3 перевірки Google: як швидко сторінка завантажується, як швидко реагує і чи не стрибає її вміст. Їх вимірюють на пристроях справжніх відвідувачів.
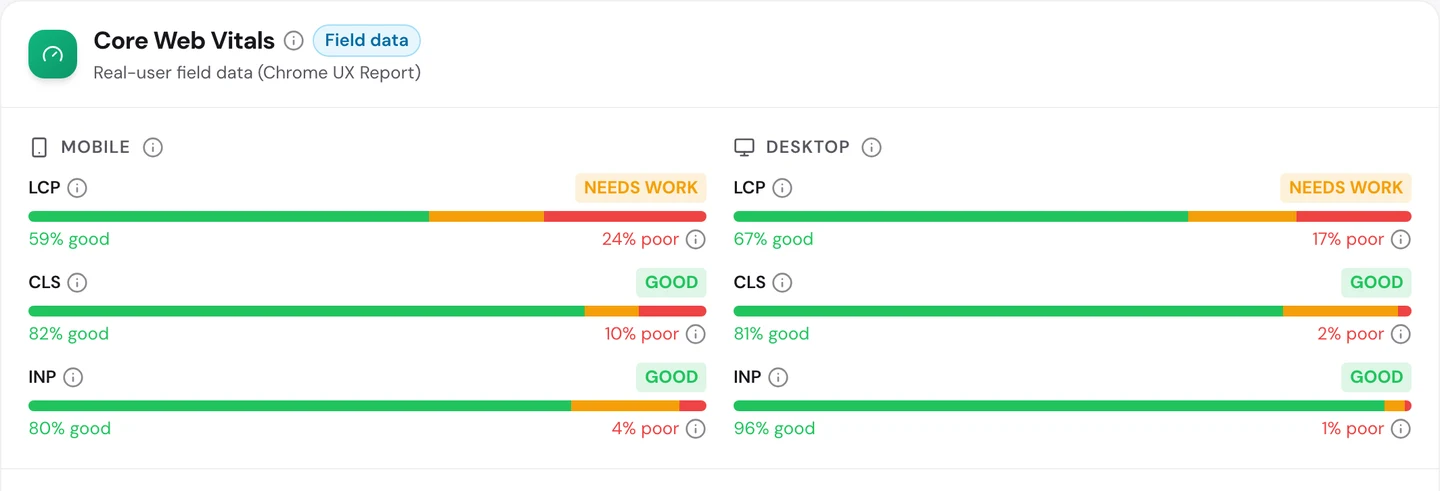
Open Library проходить 4 з 6 перевірок. Її сторінки швидко реагують і не стрибають, і на телефонах, і на комп’ютерах.
Підводить завантаження, а саме його люди помічають найперше. На телефонах основний вміст швидко з’являється лише приблизно в 3 з 5 відвідувань.
Приблизно в 1 з 4 відвідувань із телефона доводиться чекати занадто довго. На головній аудит пояснює це нестиснутими скриптами й повільною відповіддю сервера.
Тож перевіряйте найпопулярніші сторінки на телефоні й завантажуйте основний вміст раніше за все другорядне. Наш інструмент Site Speed покаже, що саме гальмує кожну сторінку.
Лише 55% обійдених нами сторінок Open Library можуть потрапити в пошук Google. Наш Website Audit покаже, які ваші сторінки заблоковані, перенаправлені або відсутні в карті сайту, і що виправляти першим.
- Той самий аудит, який ми провели для Open Library
- Індексація, перенаправлення й биті посилання в одному місці
- План від ШІ, що підкаже, у якому порядку все виправляти
Що скопіювати не вийде
Спершу про те, чого не повторити: Open Library керує неприбуткова організація Internet Archive. Домен сайту існує ще з 2001 року.
На неї ведуть мільйони посилань зі шкільних і урядових сайтів. Це роки довіри, яку не купиш.
Тепер кілька чесних зауважень про цифри.
Дані ми зібрали 4 жовтня 2026 року. Цифра 312 тис. стосується лише пошуку в США і лише openlibrary.org.
Світову цифру 790 тис. ми взяли з вкладки Traffic в аудиті. Усі ці цифри приблизні, бо ніхто, крім команди Open Library, не знає точної кількості відвідувань.
Інструменти вираховують їх за позиціями в пошуку й частотою запитів.
На сторінці книжки наш тестовий браузер уперся в перевірку на бота. Тож знімки розширення з цієї сторінки показують перевірку, а не книжку.
У тесті з user agent ми змінювали лише ім’я, яке надсилали. Ми не надсилали запитів із серверів самого Google, а до них сайт може ставитися інакше.
Наш обхід охопив 332 сторінки, а це лише невелика вибірка з дуже великого сайту. Тож ми шукали в ній проблеми, які повторюються, а не рахували кожну помилку.
Одне число, яке варто запам’ятати
55%.
Саме таку частку обійдених нами сторінок Open Library Google може додати до пошуку. Решта заблоковані, перенаправлені або навмисно закриті від пошуку.
І все ж Open Library залучає близько 312 тис. відвідувань із США на місяць, і майже половина з них приходить через одну сильну головну сторінку.
Це урок для кожного великого сайту. Те, до чого Google може дістатися і що він там бачить, важить не менше, ніж те, що ви публікуєте.
Що бачить Google, коли відкриває ваші сторінки? Перевірте їх так, як це зробив би Google.
Кожну з цих перевірок можна запустити для свого сайту й для сайтів конкурентів і побачити ті самі цифри на власні очі.
Часті запитання
Чи зашкодить перевірка на бота моїм позиціям?
Ні, якщо Google її проходить. Перевірте ключові сторінки під іменем Googlebot і як звичайний відвідувач, а тоді переконайтеся, що Google отримує справжню сторінку.
Як дізнатися, що бот справді Googlebot?
Назватися Googlebot може будь-яка програма. Google пояснює, як за адресою, з якої приходить бот, переконатися, що це справді його краулер, тож ваша перевірка на бота може пропускати справжнього й зупиняти підробки.
Чи вважається клоакінгом пропускати Google без перевірки?
Клоакінгом називають ситуацію, коли Google показують не те, що бачать люди. Якщо після перевірки люди отримують ту саму сторінку, ви всім показуєте одне й те саме.
Чи варто блокувати ШІ-краулерів?
Залежить від ваших цілей. Якщо хочете, щоб інструменти ШІ цитували вас і посилалися на вас, пускайте їх. Якщо ж ви продаєте контент, який вони можуть скопіювати, деяких можна заблокувати.
Яку назву дати сторінці, у якої багато видань?
Ту, яку шукає більшість людей, і мовою самої сторінки. Інші назви згадайте нижче, щоб сторінку знаходили й за ними.
Чи потрібна карта сайту, якщо Google і так знаходить мої сторінки?
Великим сайтам потрібна. Карта сайту допомагає Google знаходити глибокі сторінки, до яких веде мало посилань, і повідомляє, коли сторінки змінюються.
Як найшвидше пришвидшити головну сторінку?
Спершу завантажуйте основний текст і перші зображення, а решту відкладіть. Стисніть скрипти й приберіть ті, якими не користуєтеся.
Як часто великому сайту-каталогу проводити аудит?
Для початку раз на місяць. І ще запускайте аудит після кожної великої зміни шаблону, бо одна зміна може зачепити тисячі сторінок.