ClinicalTrials.gov залучає з Google у США близько 166 000 відвідувань на місяць, хоча у вихідному коді його сторінок досліджень немає жодного слова з їхнього тексту.
ClinicalTrials.gov належить уряду США: це каталог медичних досліджень. Кожне дослідження має власну сторінку, а збирає її код прямо у вашому браузері.
Ми перевірили сайт нашими SEO-інструментами. Наш «Аудит сайту» не зміг прочитати жодної сторінки, і причина цього стане уроком для всіх сайтів, які працюють так само.
Нижче 9 уроків, які можна перейняти, і те, чого повторити не вийде.
Робіть окрему сторінку на кожну тему
Почали ми з нашого інструмента «Перевірка органічного трафіку». Він оцінює органічний трафік, тобто скільки людей знаходять сайт у Google без реклами.
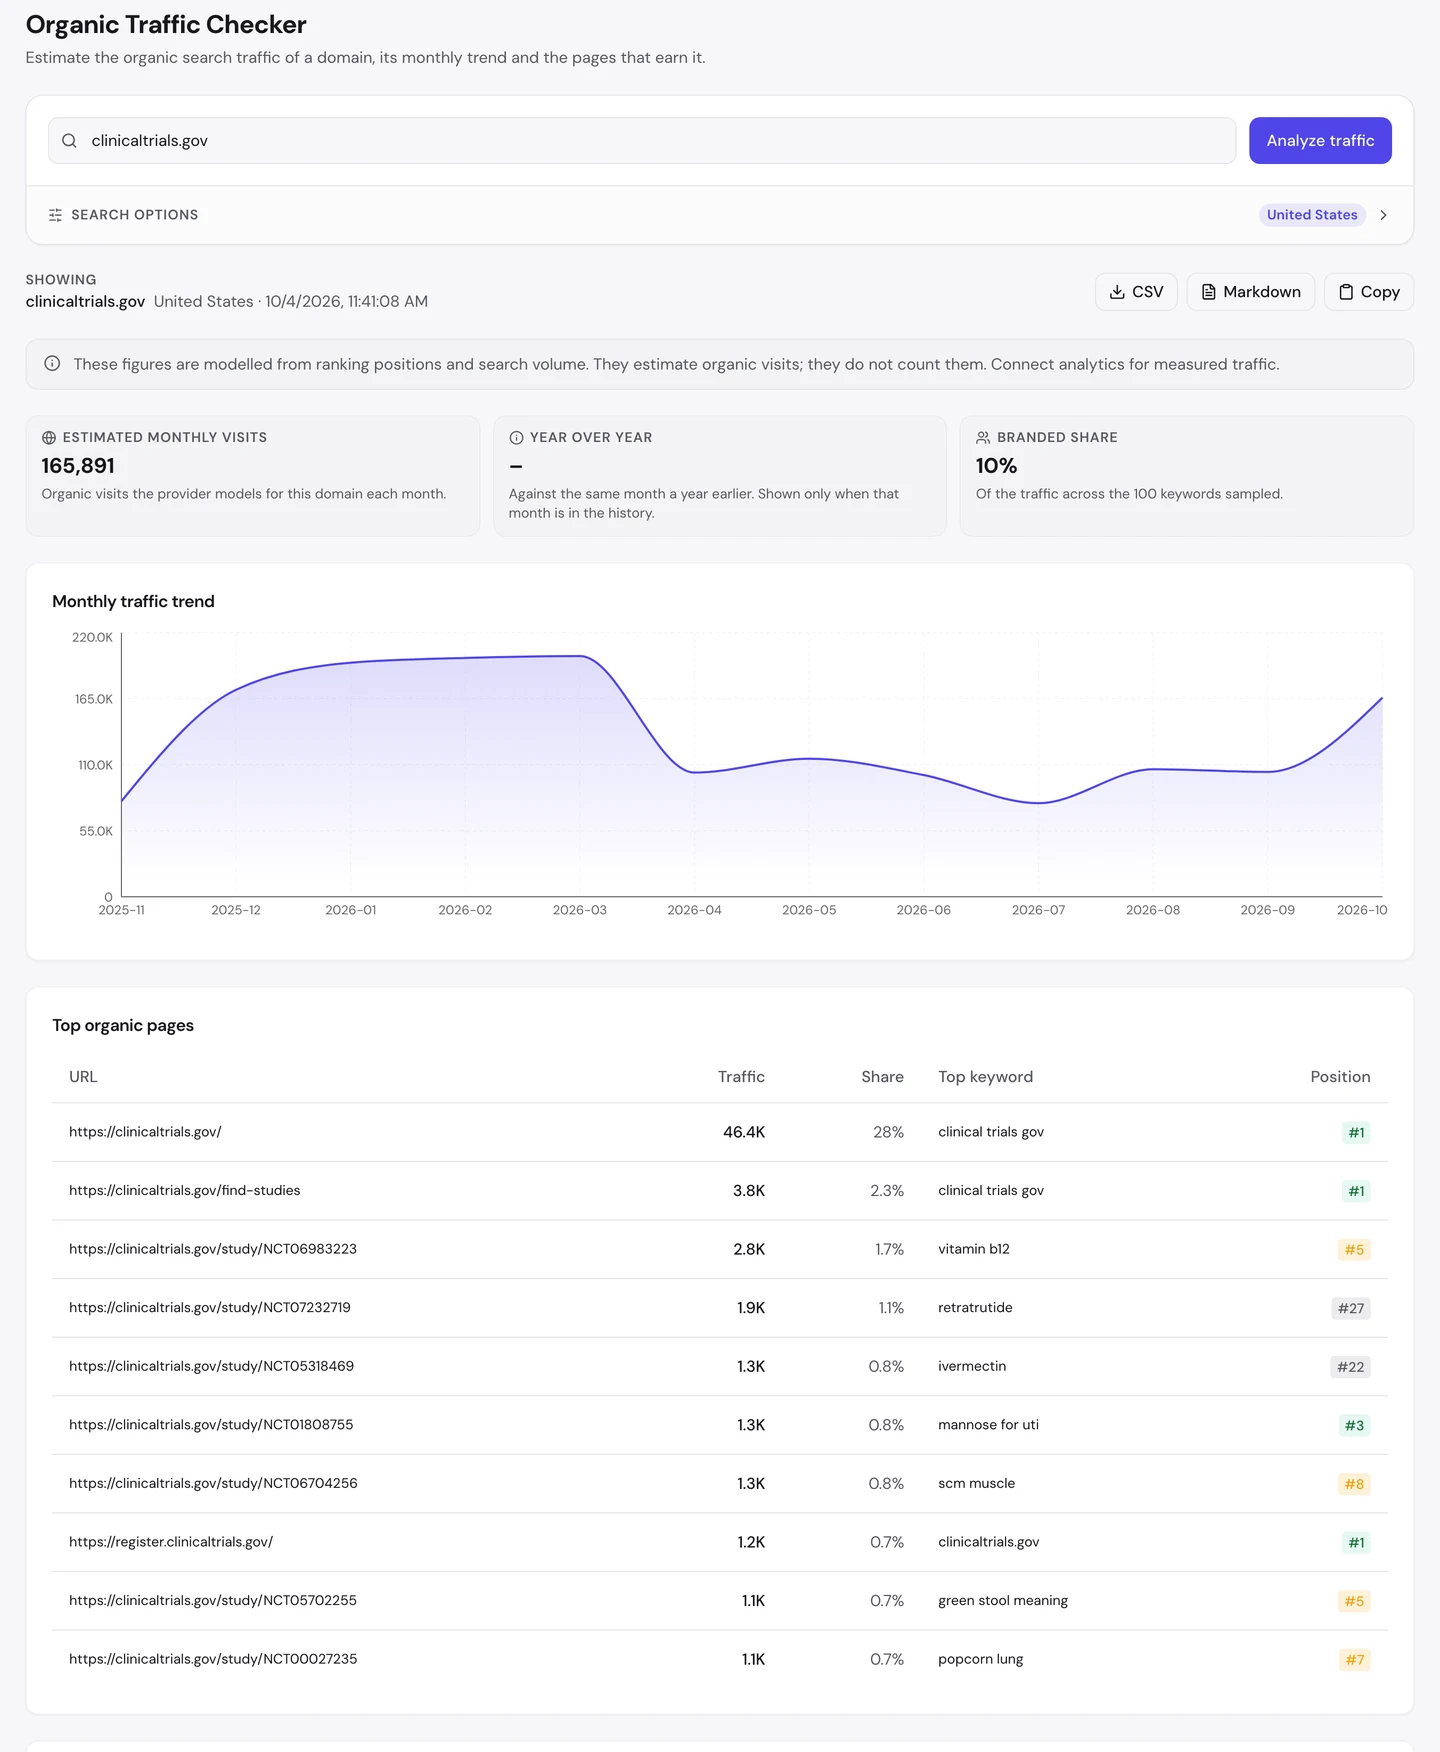
Це близько 166 тис. відвідувань на місяць у США. Лише 10% із них припадає на людей, які вводять назву сайту.
Головна сторінка збирає понад чверть цих відвідувань. А тепер погляньте на решту сторінок із топ-10.
7 із них присвячені окремим дослідженням. І кожна приводить власний потік відвідувачів.
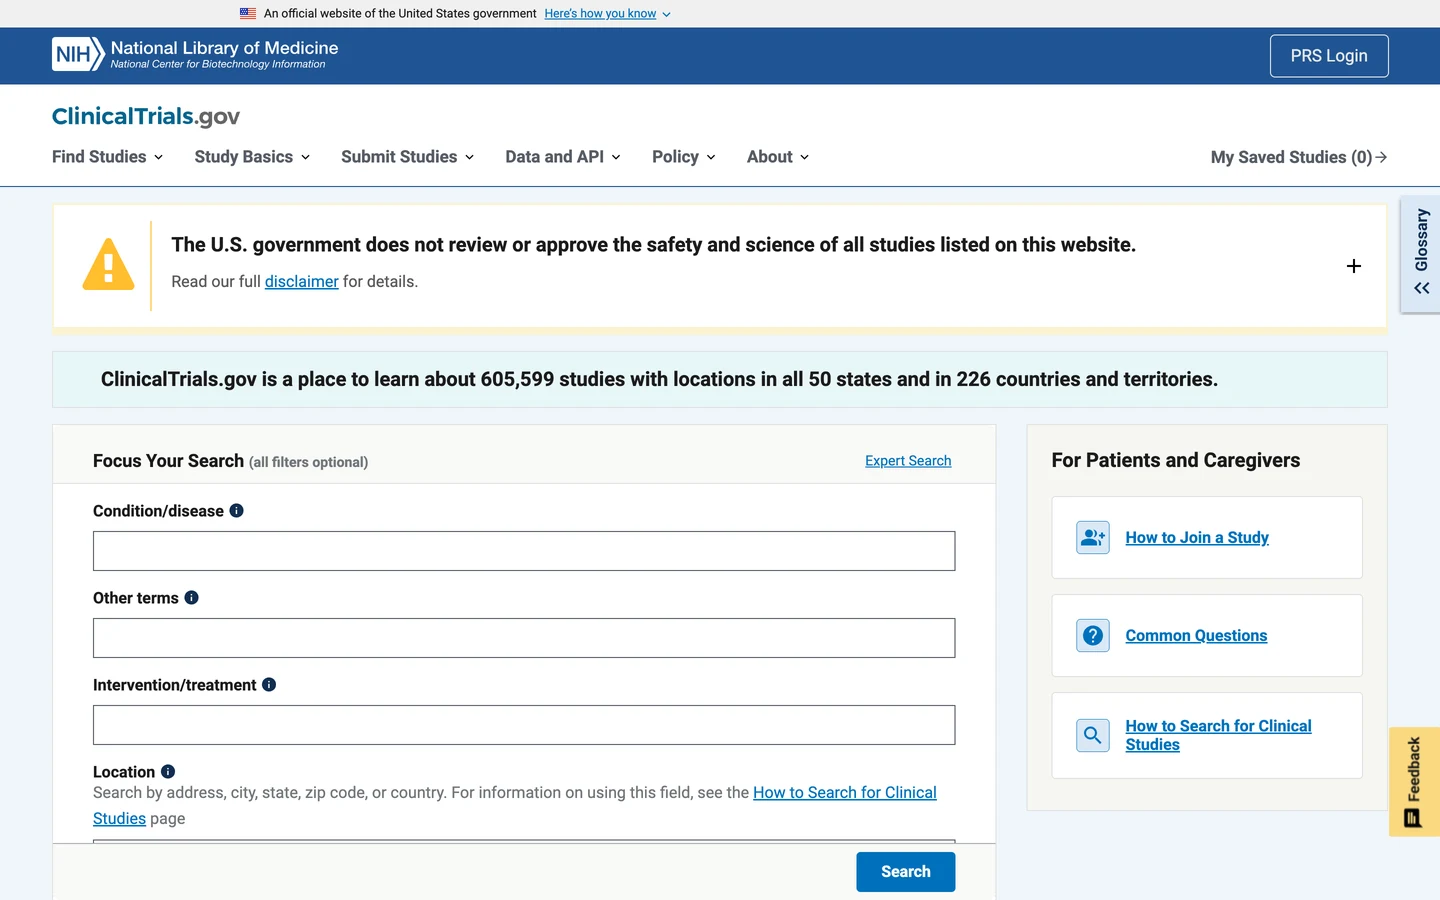
Судячи з головної, на сайті зібрано близько 606 тис. досліджень. Кожне дослідження має власну адресу, тож кожне може з’явитися в Google.
На цьому все й тримається. Коли на одну тему є одна сторінка, Google точно знає, куди вас відправити.
Docker Hub, який ми теж розбирали, має окрему сторінку для кожної програми. А в PHP.net, який ми теж вивчали, так само окрему сторінку має кожна функція.
Тож створіть для кожного свого продукту чи послуги окрему сторінку з власною адресою. А потім подивіться в нашому інструменті «Перевірка органічного трафіку», які з ваших сторінок приводять відвідувачів.
Пишіть словами самих пацієнтів
Тепер погляньте, за якими запитами виходять у топ ці сторінки досліджень. Це не коди і не довгі наукові назви.
Одна сторінка дослідження посідає 7-ме місце за запитом «popcorn lung», а це назва хвороби легень. Інша стоїть на 5-му місці за запитом «green stool meaning».
Третя на 3-му місці за запитом «mannose for uti», а це добавка, яку шукають люди з інфекціями сечового міхура. Хто б подумав, що на таке відповідає наукове дослідження.
Такі запитання люди ставлять щодня. Більшість тих, хто їх вводить, мабуть, зовсім не шукає клінічних досліджень.
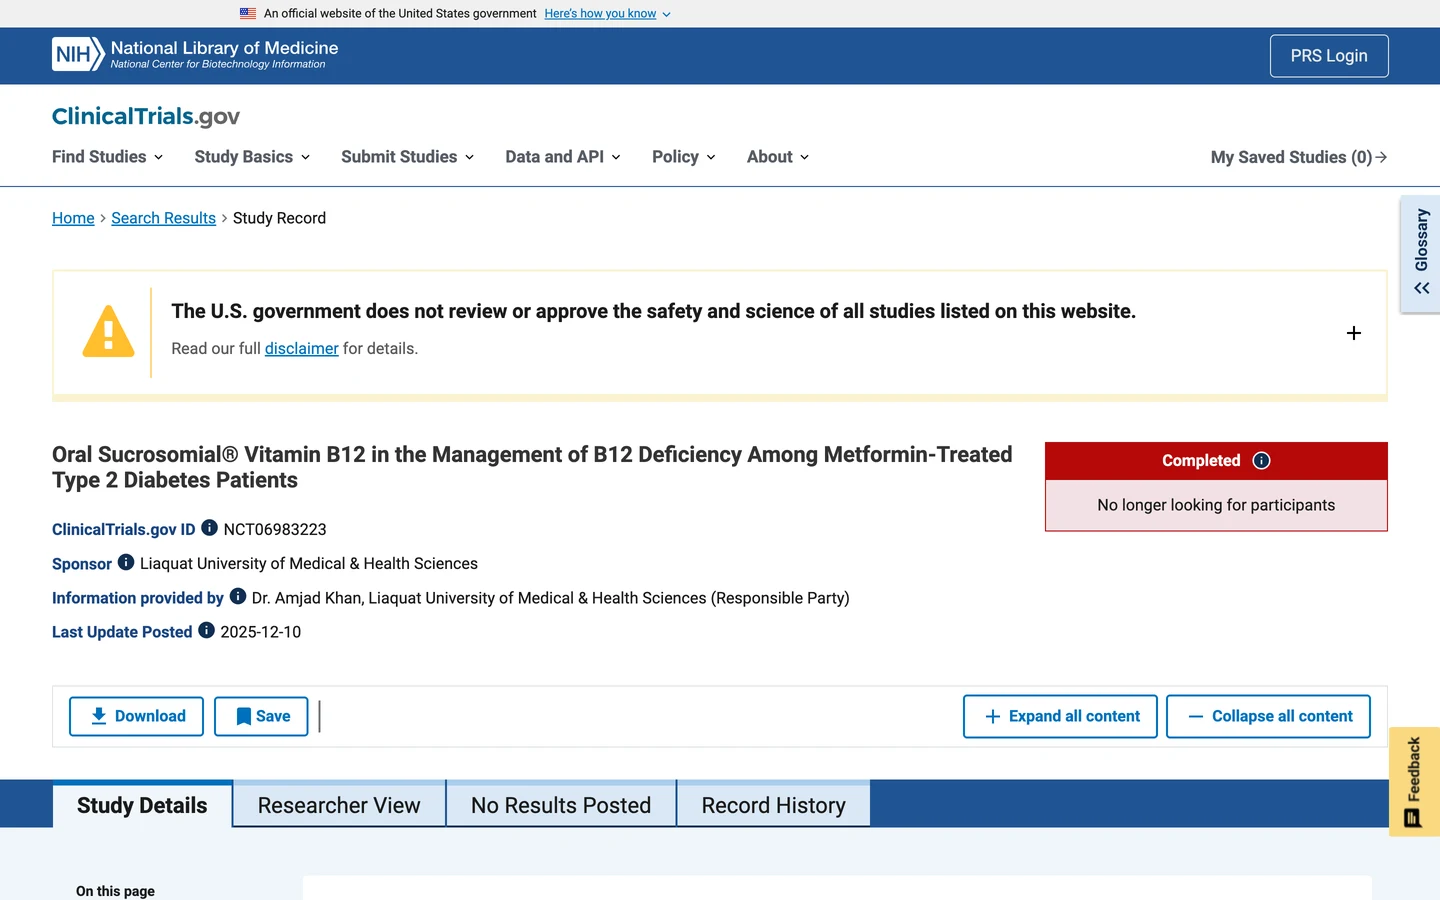
Ця сторінка описує дослідження добавки з вітаміном B12 для людей із діабетом. Вона посідає 5-те місце за простим запитом «vitamin b12».
Одна ця сторінка приносить близько 2,8 тис. відвідувань на місяць. Google знайшов у її заголовку й тексті ті самі слова, які ви ввели б у пошук, і пов’язав одне з одним.
Healthline, медичний сайт, який ми теж розбирали, тримається саме на таких запитах.
Це можна робити свідомо. Знайдіть прості слова, якими користуються люди, і поставте їх у заголовок, підзаголовки й перші рядки тексту.
Тож з’ясуйте, як люди насправді шукають інформацію на вашу тему, за допомогою нашого інструмента «Дослідження ключових слів». А потім пишіть їхніми словами, а не внутрішніми назвами вашої компанії.
Проведіть аудит очима краулера
Далі ми запустили наш Аудит сайту. Він запускає краулера, тобто програму, яка відкриває сторінки так само, як Google, і перевіряє сотні сторінок одразу.
Ми попросили перевірити 250 сторінок. А ще дали йому карту сайту, тобто файл зі списком сторінок сайту для Google.
Звіт вийшов порожнім. У ньому було написано: «Нам не вдалося прочитати жодної сторінки цього сайту».
Тож ми з’ясували, чому так. Ми завантажили сторінку дослідження про вітамін B12 найпростішим способом, так само як це робить краулер.
Ми навіть видавали себе за Googlebot і GPTBot, тобто за краулерів Google і OpenAI. І щоразу отримували ту саму сторінку.
Ось відповідь сервера, скорочена до головних рядків. Файл важить близько 94 КБ, але суть ось у цьому.
<title>ClinicalTrials.gov</title>
<meta name="description" content>
…
<app-root></app-root>
…
Заголовок складається лише з назви сайту, а опис порожній. Немає ні назви дослідження, ні його тексту, ні головного заголовка.
Читач побачив би тут лише кілька кнопок глосарію і примітку для «study record managers», тобто для тих, хто веде записи про дослідження. От і все.
Бачите порожній тег «app-root»? Це контейнер, куди потім потрапляє дослідження.
JavaScript, тобто код, який працює у вашому браузері, наповнює цей контейнер уже після завантаження сторінки. А доти вихідний HTML, тобто код, який сервер надсилає першим, лишається порожньою оболонкою.
Ваш браузер виконує цей код, тому ви бачите дослідження повністю. Наше безкоштовне розширення для браузера читає сторінку так само.
Відкрийте сторінку, натисніть значок seotools.pro, і поруч з’явиться панель. Вкладка Content рахує слова на сторінці.
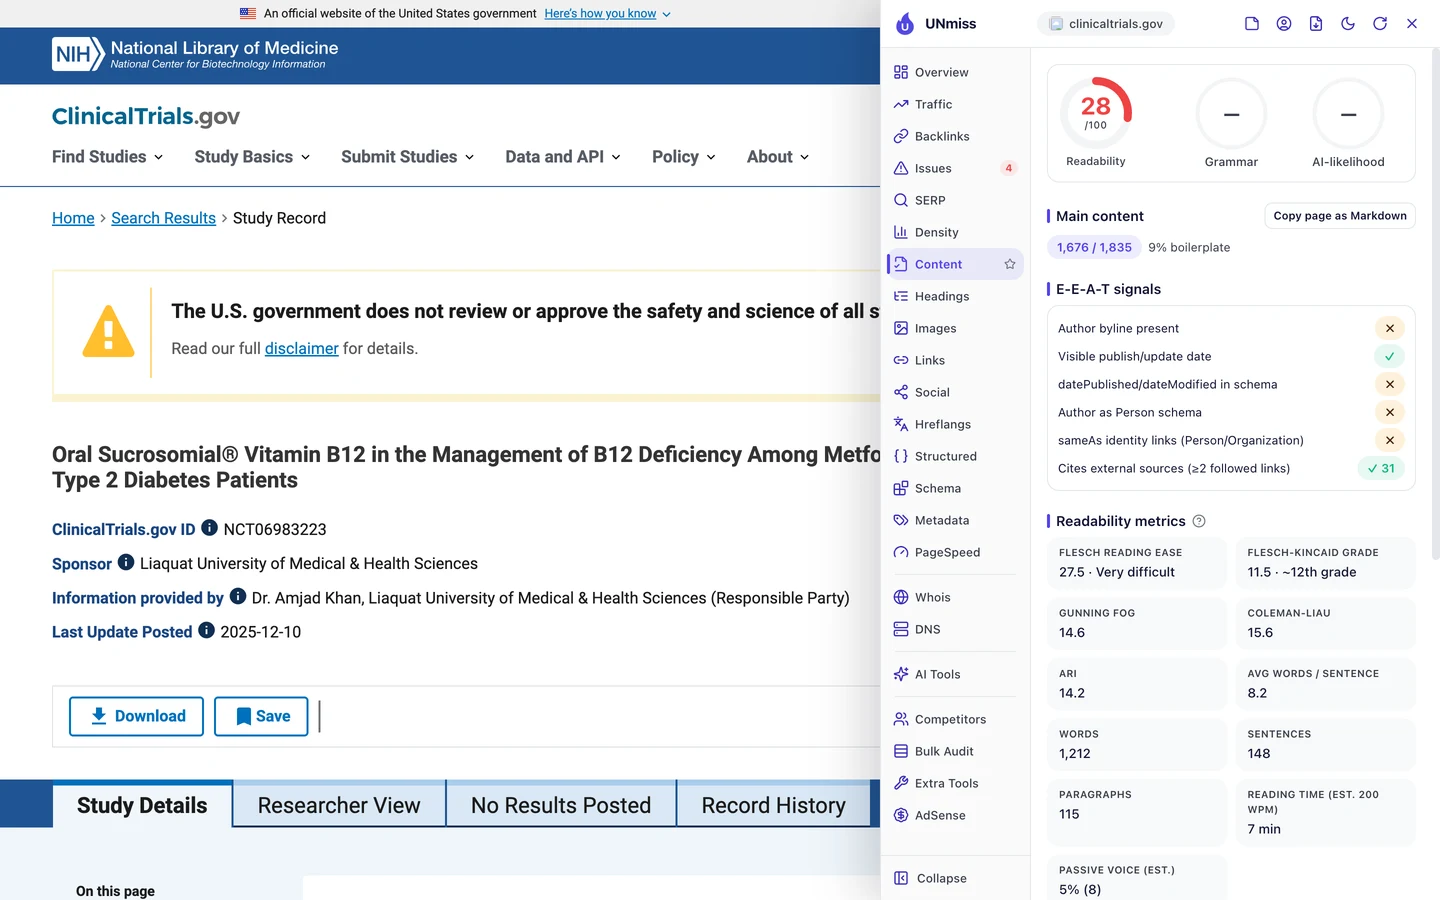
У браузері розширення знаходить близько 1 700 слів основного вмісту. У вихідному HTML ми не знайшли жодного з них.
Ось чому наш аудит повернувся ні з чим. Він читає вихідний HTML, як і багато інших краулерів, тож кожна сторінка здавалася йому порожньою.
І ось що тут корисного для вас. Якщо наш аудит не може прочитати ваші сторінки, простий краулер теж не зможе.
Тож запустіть наш Аудит сайту для свого сайту. Якщо звіт буде порожнім або на ваших сторінках не знайдеться ні заголовка, ні тексту, перевірте, що насправді є у вашому вихідному HTML.
Сторінки досліджень ClinicalTrials.gov потрапляють до краулерів без жодного слова з тексту дослідження. Ми перевіримо, що насправді є у вашому вихідному HTML, і додамо туди ваш текст, щоб його могли прочитати Google та інструменти ШІ.
- Перевіримо ваші сторінки так, як їх завантажують краулери
- Налаштуємо попередній рендеринг або рендеринг на сервері для ключових сторінок
- Виправимо заголовки, описи й підзаголовки у ваших шаблонах
- SEO і GEO, щоб вас цитували й у відповідях ШІ
Додайте основний текст в HTML
То чому ж сторінки досліджень усе одно виходять у топ? Бо Google виконує JavaScript.
Він завантажує сторінку так, як це зробив би браузер, часто трохи пізніше, і тоді читає дослідження. Так окремі дослідження й потрапляють у топ-10.
Багато інших краулерів не чекають. Більшість ШІ-краулерів не виконують JavaScript, тож вони читають вихідний HTML і йдуть далі.
Для них кожна сторінка дослідження виглядає як та порожня оболонка вище. А сайт їх таки пускає.
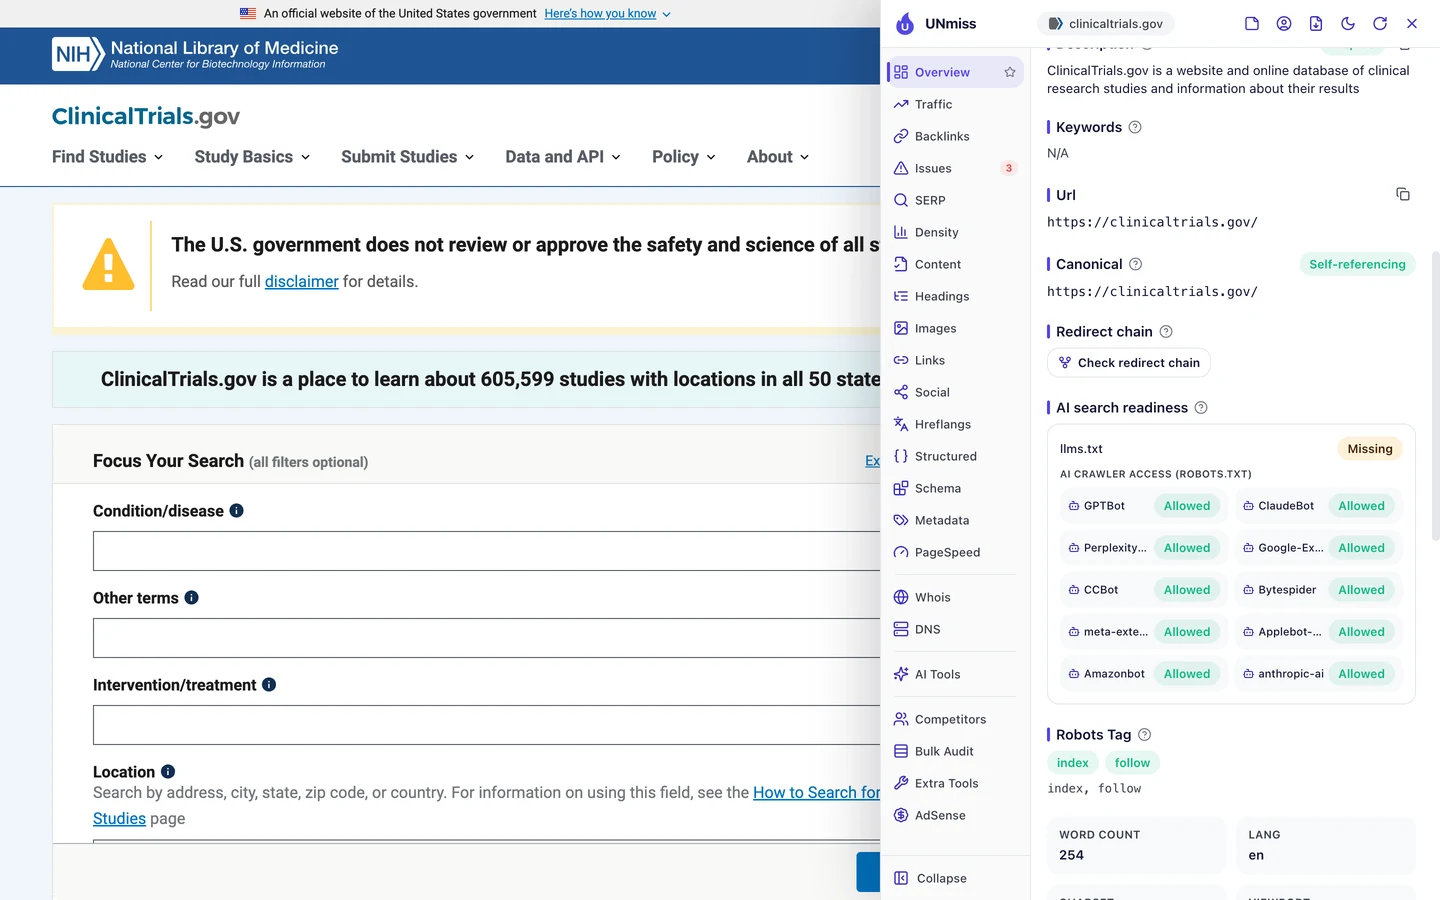
Правила записані у файлі robots.txt, де сказано, що краулерам можна читати. Тут доступ мають усі 10 ШІ-краулерів, яких перевіряє розширення.
Але потрапити на сайт ще не означає його прочитати. ШІ-краулер, який не виконує JavaScript, заходить і бачить порожню кімнату.
На сайті немає й llms.txt, тобто короткого файлу, який пояснює сайт інструментам ШІ. Як великі сайти користуються такими файлами, ми розбирали в нашому дослідженні llms.txt.
А яких ШІ-краулерів пускають великі сайти, ми з’ясовували в нашому дослідженні robots.txt.
Дещо robots.txt цього сайту все ж робить правильно. Файл закриває сторінки результатів пошуку, яких може бути безкінечно багато, тож краулери витрачають час на справжні дослідження.
Щоб позбутися порожньої оболонки, текст треба надсилати разом зі сторінкою. Рендеринг на сервері збирає повну сторінку ще до того, як її надіслати.
Попередній рендеринг заздалегідь зберігає готову копію кожної сторінки. В обох випадках назва й текст дослідження опиняються у вихідному HTML, і їх бачить кожен краулер, а не лише Google.
Тож переконайтеся, що основний текст уже є в HTML. Потім перевірте правила для краулерів у нашому генераторі robots.txt, а в нашому інструменті «Перевірка видимості в ШІ» подивіться, чи згадують вас інструменти ШІ.
Скоротіть заголовки до суті
Коли текст уже в HTML, час братися за заголовок. Саме його ви бачите в Google як синє посилання.
Вкладка Overview у розширенні показує заголовок відкритої сторінки та її оцінку зі 100.
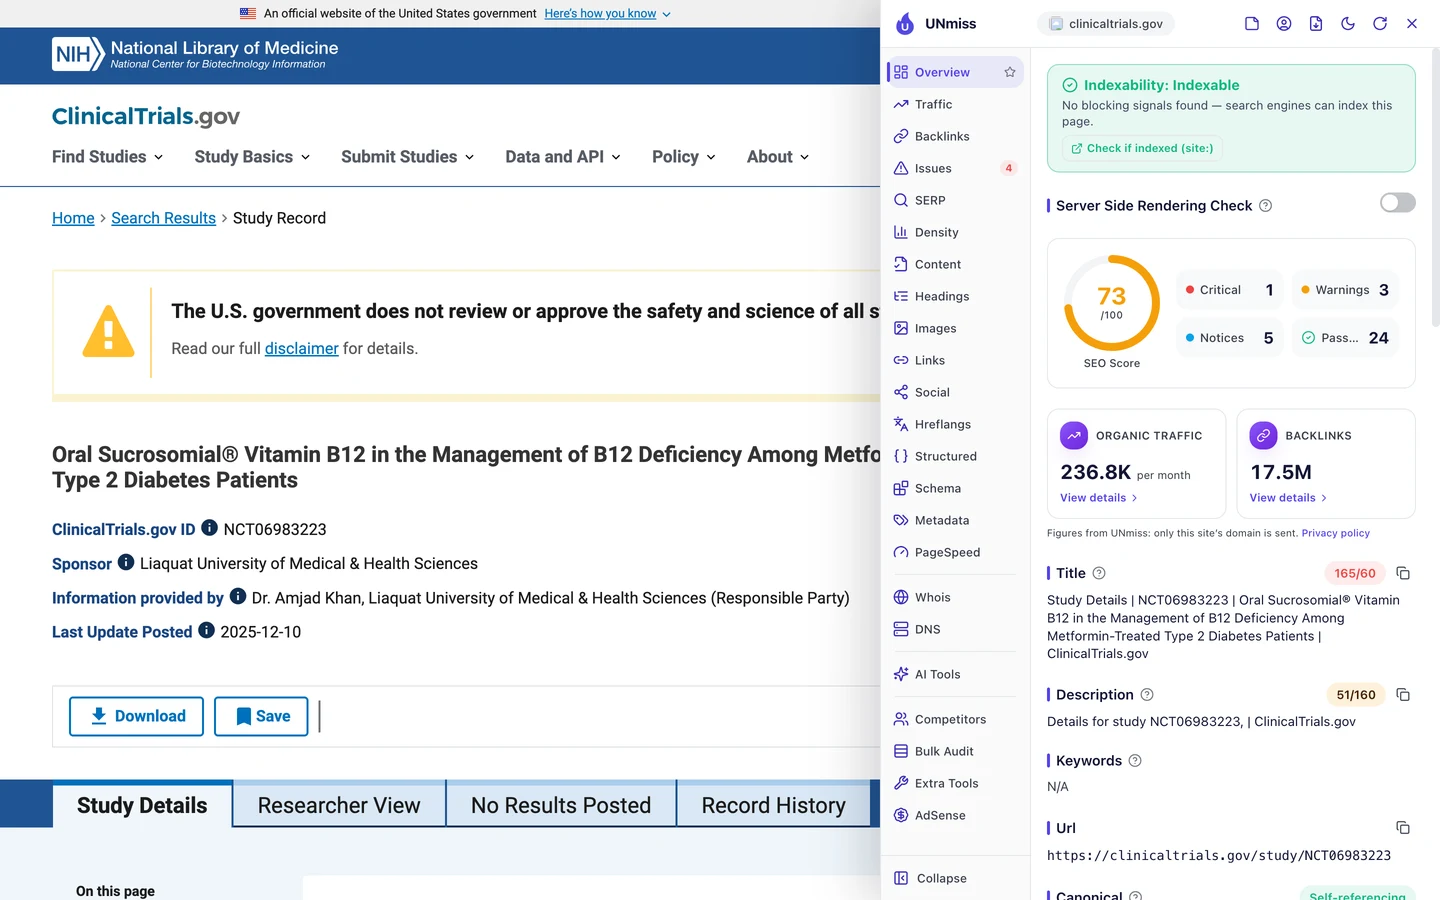
Сторінка про вітамін B12 набирає 73 бали. Її заголовок має 165 символів.
Він починається зі «Study Details» і коду дослідження. Слова, які ви б шукали, йдуть лише після них.
Google зазвичай обрізає заголовки приблизно після 60 символів. Тож люди в пошуку бачать код і початок довгої наукової назви, а решту відрізано.
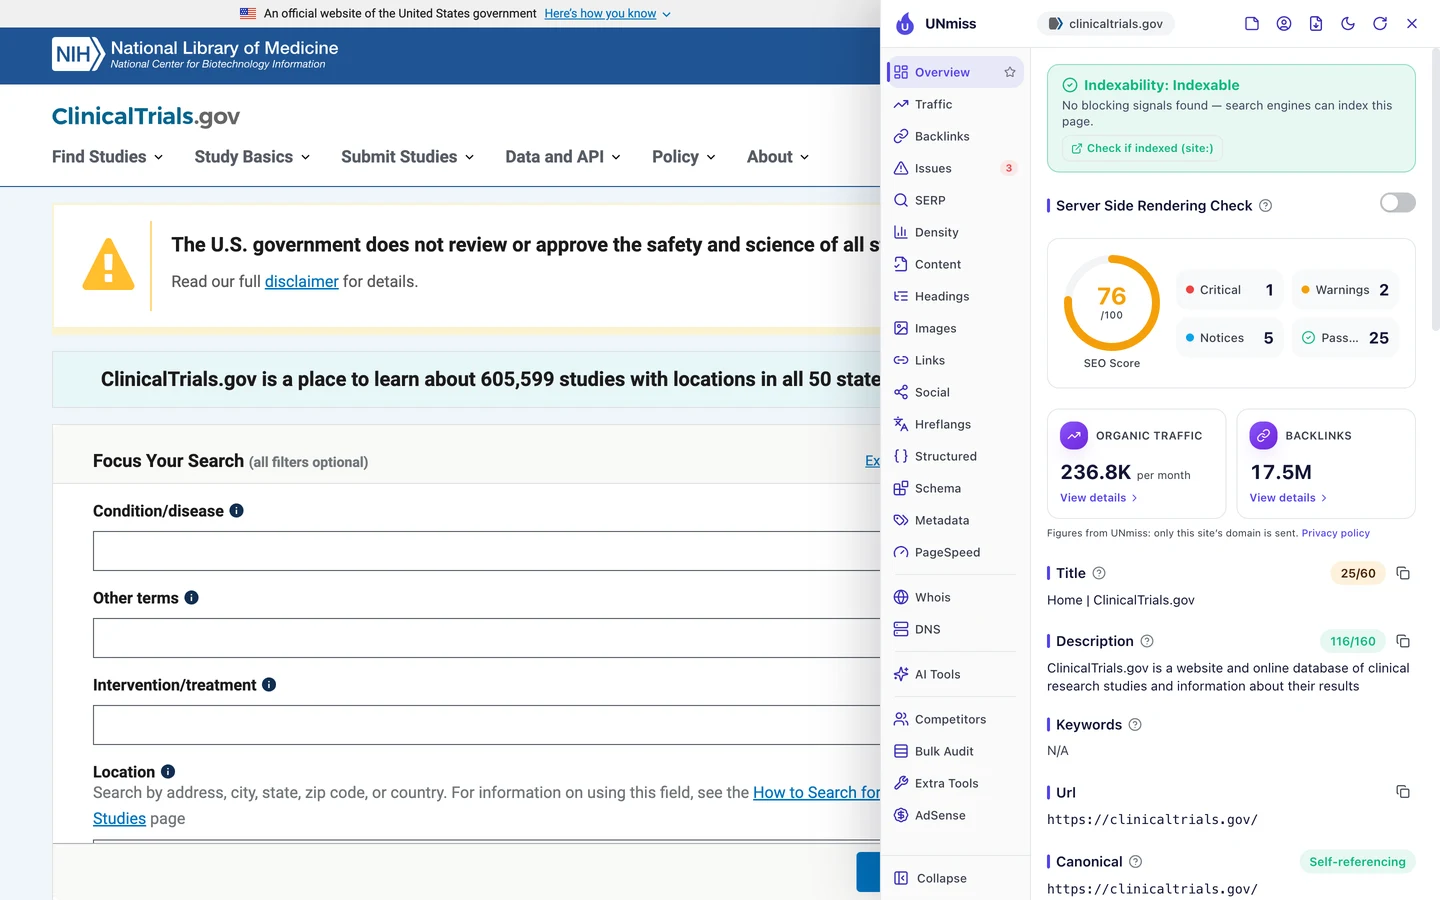
У головної протилежна проблема. Її заголовок, «Home | ClinicalTrials.gov», має лише 25 символів.
За назвою сайту вона все одно виходить у топ. Але про пошук досліджень у заголовку ні слова, а саме цього хочуть нові відвідувачі.
Кращий заголовок дослідження починався б із теми, наприклад «Vitamin B12 for Diabetes Patients on Metformin», а вже потім ішла б назва сайту. Ви б одразу бачили, про що сторінка.
Тож ставте на початок слова, які шукають люди, і тримайте довжину заголовків близько 60 символів. Як вони виглядатимуть у Google, покаже наш Симулятор SERP.
Пишіть змістовні описи
Під заголовком Google може показати опис, тобто короткий підсумок сторінки. На сторінці про вітамін B12 він такий: «Details for study NCT06983223, | ClinicalTrials.gov».
Це 51 символ, ще й із зайвою комою перед вертикальною рискою. Схоже, шаблон чекав тут іще одне слово, але нічого не отримав.
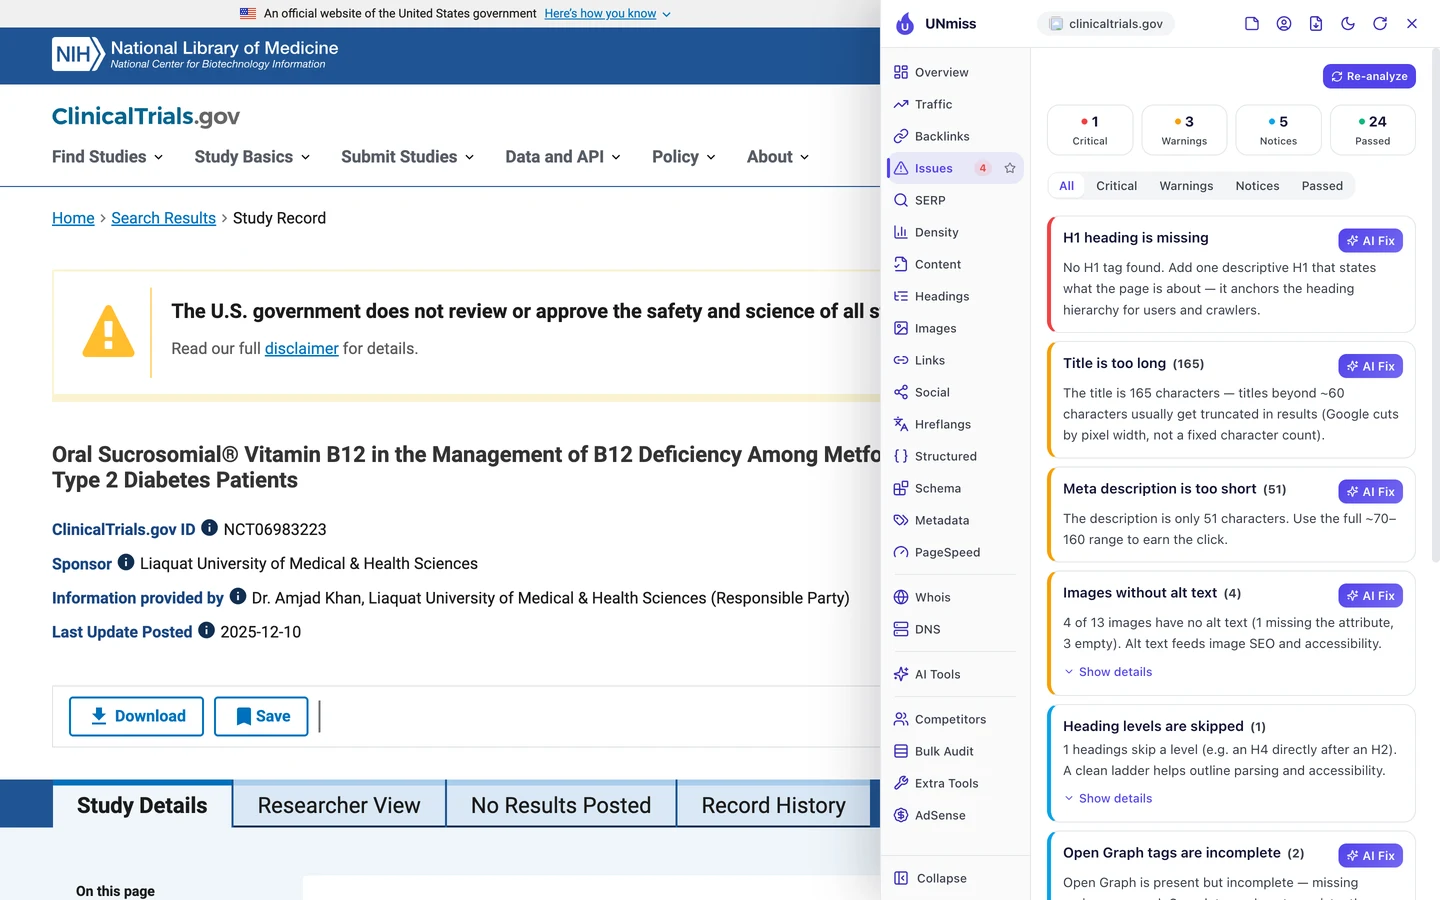
Вкладка Issues вважає опис надто коротким. Google може показати приблизно до 160 символів, а ця сторінка використовує лише третину.
Найімовірніше, такий шаблон стоїть за кожною сторінкою дослідження. Тож одне виправлення в ньому могло б покращити їх усі одразу.
Хороший шаблон підставляє реальні дані: захворювання, лікування і те, чи ще набирає дослідження учасників.
Тож складайте шаблон опису з фактів кожної сторінки, а не з однієї сталої фрази. Перевірити свій допоможе наш Генератор метатегів.
Додайте один H1 на кожну сторінку
Ще раз погляньте на початок списку Issues. Там лише одна критична проблема: бракує H1, тобто тегу головного заголовка сторінки.
На сторінці дослідження видно велику жирну назву. Але в коді вона не позначена як H1.
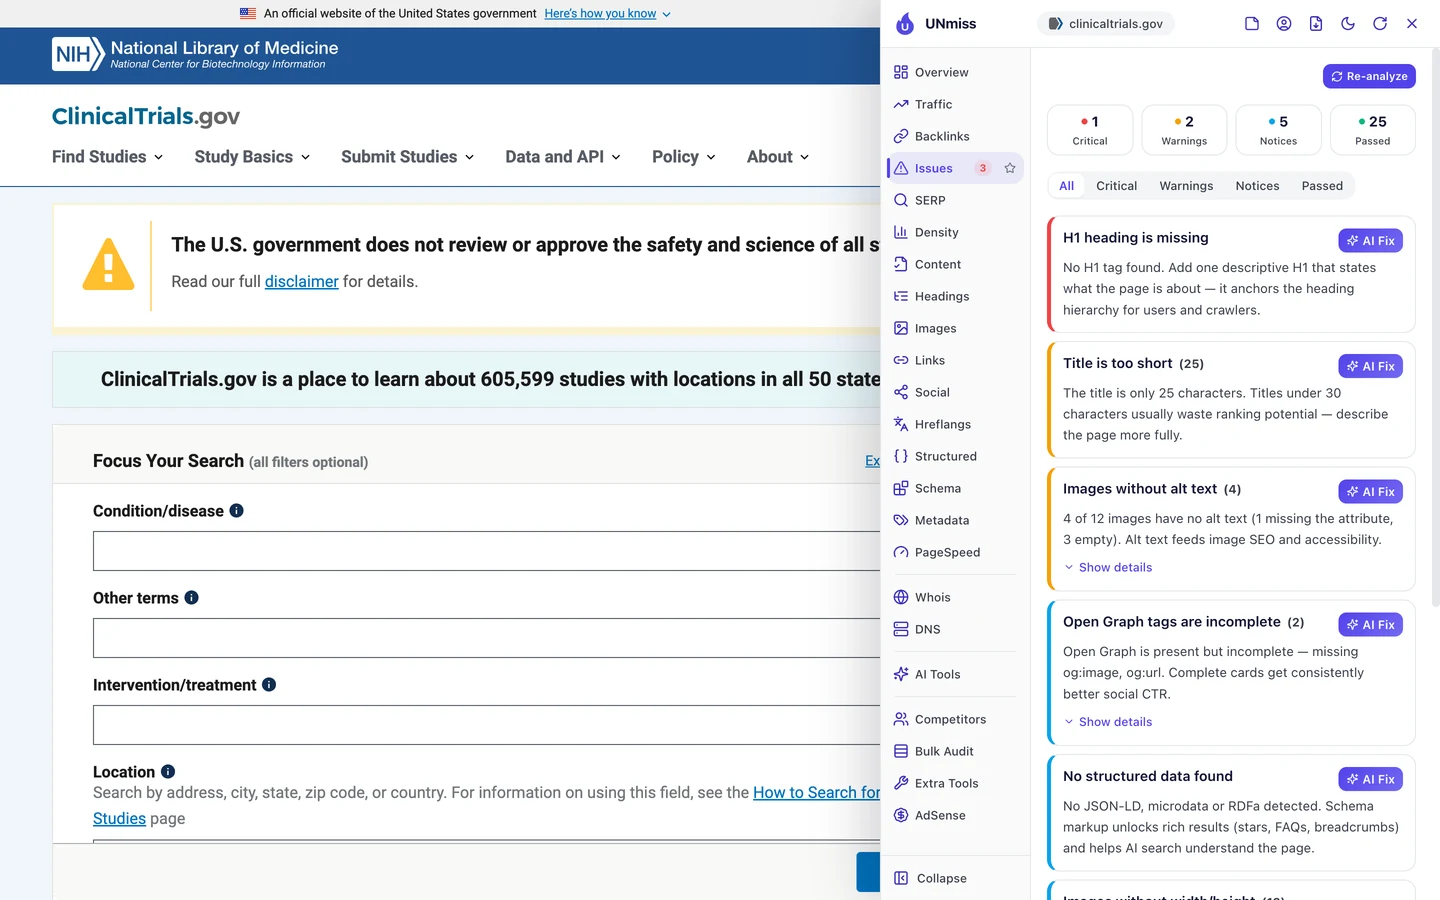
На головній та сама прогалина. На обох сторінках бракує H1, і більше критичних проблем там немає.
H1 підказує Google і програмам екранного читання, про що сторінка. На сторінці дослідження 13 менших заголовків, але над ними нічого немає.
Це дрібне виправлення в одному шаблоні. Зробіть назву дослідження заголовком H1, і він з’явиться на кожній сторінці дослідження.
І заодно додайте alt-текст до 4 зображень, у яких його немає. Alt-текст коротко пояснює Google і програмам екранного читання, що зображено на картинці.
Тож перевірте нашим безкоштовним розширенням для браузера, чи є у ваших ключових шаблонах один чіткий H1. На кожну сторінку піде кілька секунд.
Опишіть кожне дослідження кодом
Структурованими даними називають код, який пояснює Google, що це за сторінка: рецепт, товар чи медичне дослідження. Вкладка Structured у розширенні шукає саме його.
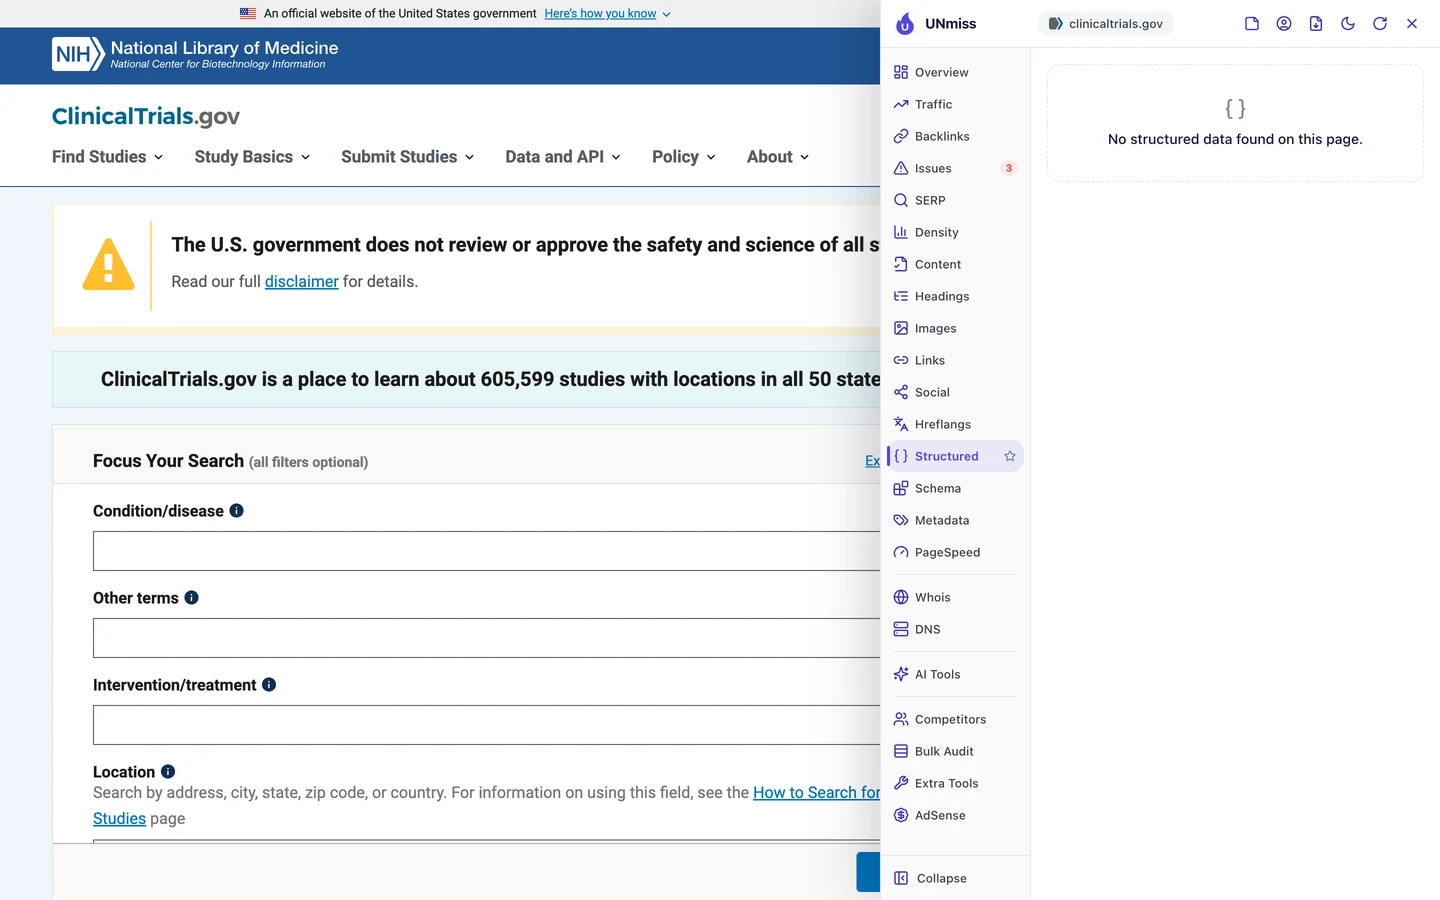
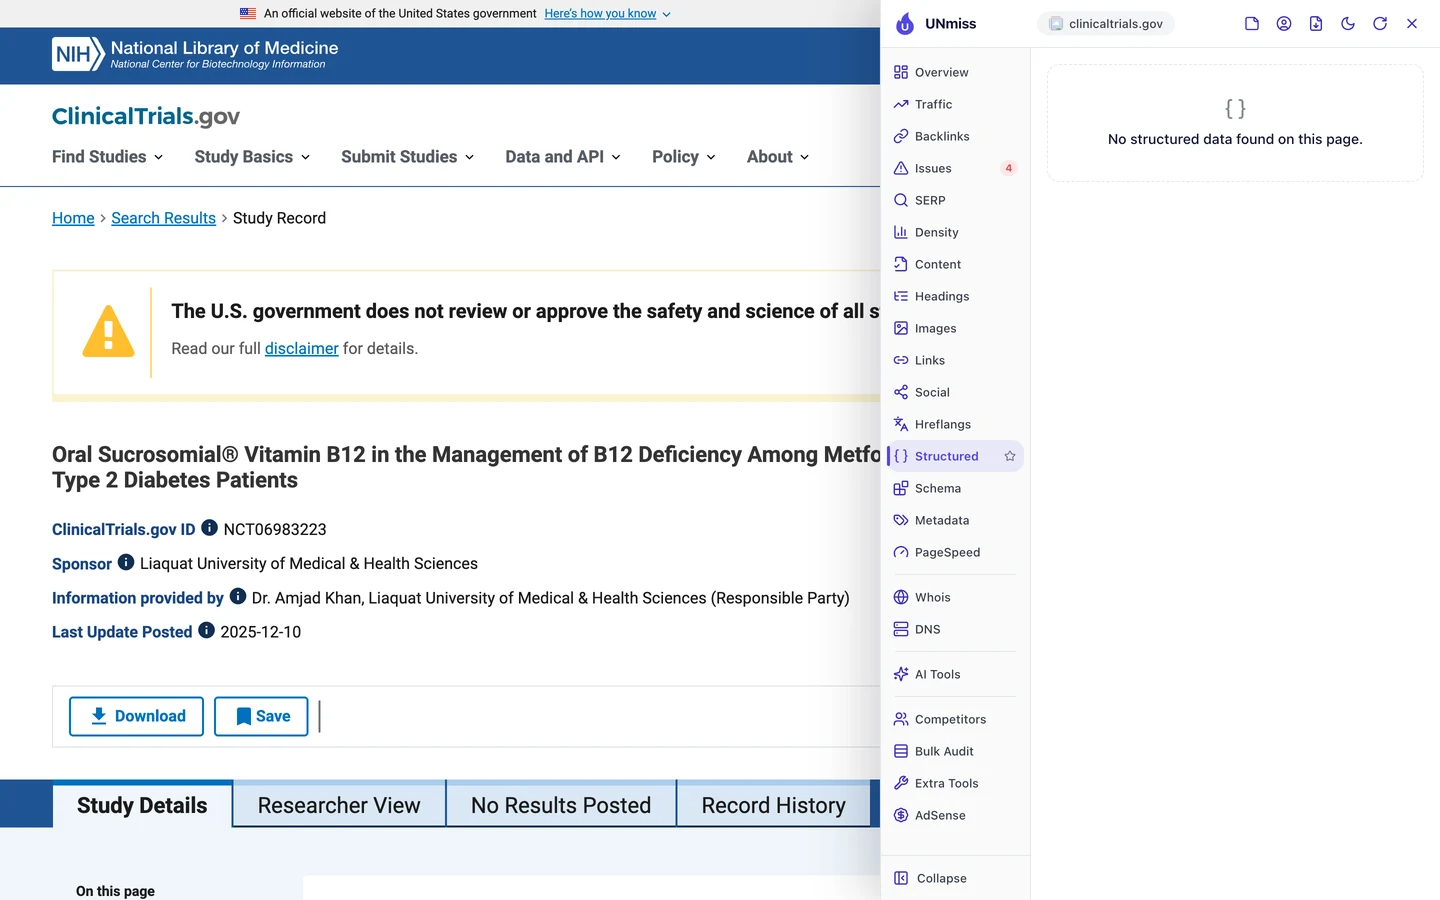
Їх немає на жодній із двох сторінок. Для сайту, де повно фактів, це втрачена можливість.
На кожній сторінці дослідження вже вказано спонсора, статус і дату останнього оновлення. Проте вкладка Content не знайшла в коді жодної дати.
Код міг би чітко пояснити все це Google та інструментам ШІ. Для цього навіть є готовий тип під назвою MedicalStudy.
А ось і бонус. Якщо додати його у вихідний HTML, ключові факти зможуть прочитати навіть краулери, які не виконують JavaScript.
Тож додайте код, який пояснює, що це за сторінка, хто за нею стоїть і коли її змінювали. Наш Генератор розмітки Schema напише його за вас.
Шукайте свої запити на 2-й сторінці
Наостанок наш Огляд домену показує, яке місце посідає в Google весь сайт.
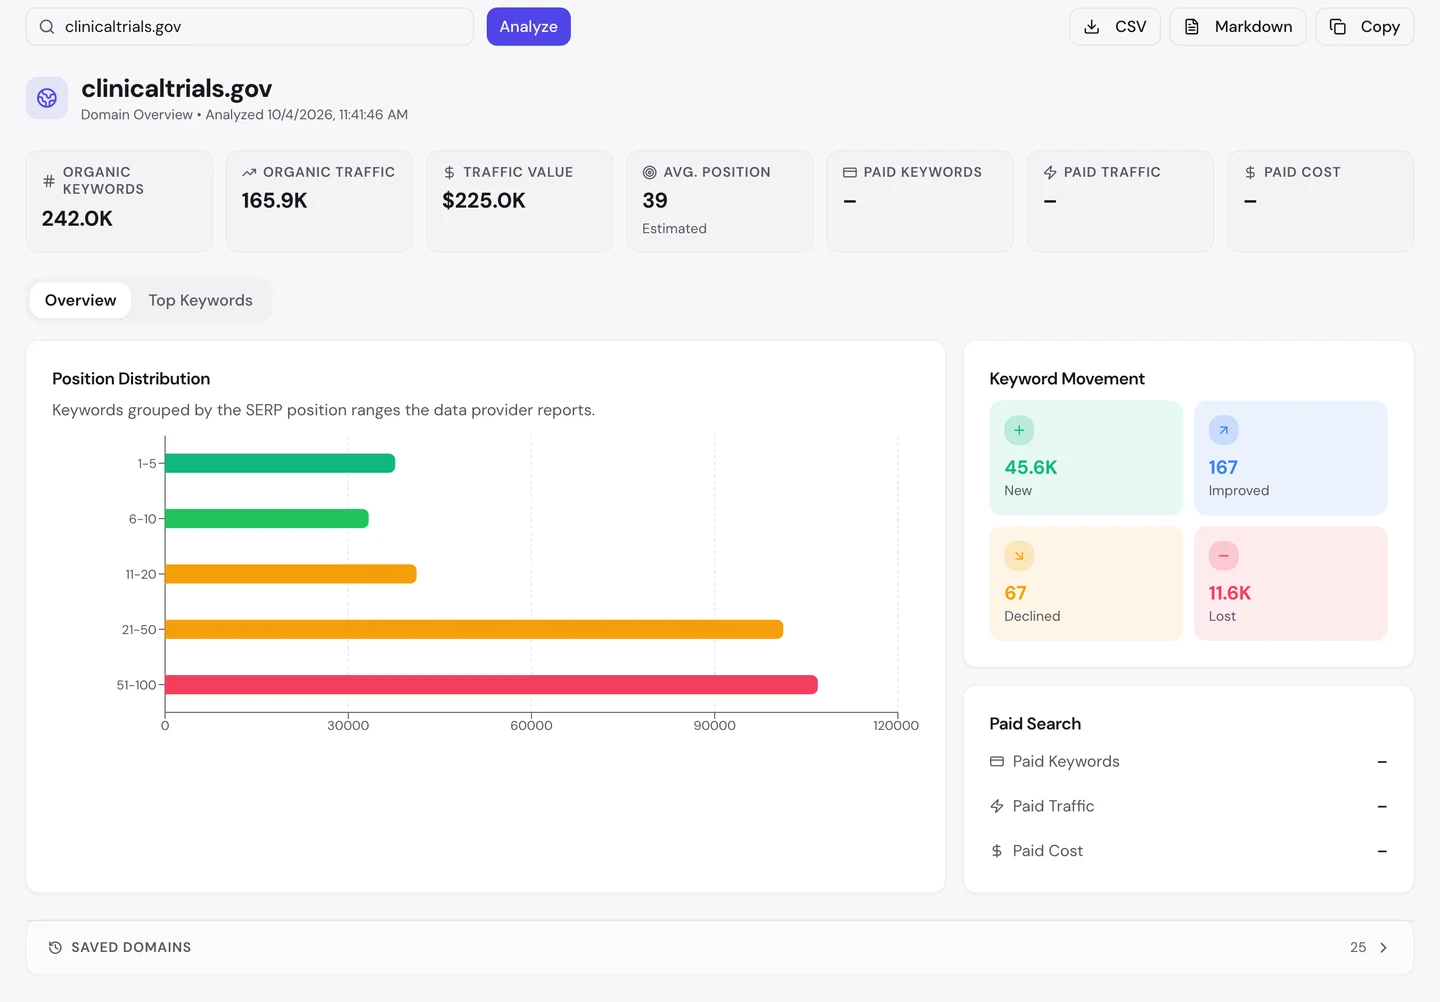
Сайт з’являється в Google приблизно за 242 тис. запитів. Вартість його трафіку, тобто скільки коштували б ці відвідування як реклама в Google, становить близько 225 тис. $ на місяць.
Але в середньому він стоїть на 39-му місці, тобто на 4-й сторінці Google. Більшість його ключових слів опинилася нижче 20-го місця, де мало хто клікає.
Блок динаміки тішить. Сайт здобув близько 46 тис. нових ключових слів і втратив близько 12 тис.
Сторінки, яким потрібен JavaScript, Google може читати довше. Тож виправлення, про яке ми говорили вище, може допомогти й тут.
Найшвидше зрости можна на 2-й сторінці, на позиціях від 11 до 20. Кращий заголовок чи зрозуміліша сторінка можуть підняти такі запити на 1-шу сторінку.
Тож знайдіть свої ключові слова на позиціях від 11 до 20 і спершу покращте ці сторінки. А потім стежте, як вони піднімаються, у нашому Rank Tracker.
Наш «Аудит сайту» не зміг прочитати жодної сторінки ClinicalTrials.gov, бо тексту досліджень немає у вихідному HTML. Запустіть його для свого сайту й подивіться, що насправді отримують краулери з кожної сторінки.
- Той самий аудит, який ми запускали для ClinicalTrials.gov
- Заголовки, описи й підзаголовки кожної прочитаної сторінки
- План від ШІ, що виправляти насамперед
Що скопіювати не вийде
Спершу про те, чого не повторити: ClinicalTrials.gov належить до офіційних урядових сайтів США, а керує ним National Library of Medicine. Його домен існує ще з 2000 року.
Розширення налічує близько 17,5 млн зворотних посилань на нього. Зворотне посилання (backlink) веде з іншого сайту на ваш, і за такою кількістю стоять роки довіри, яку не купиш.
Проте подивитися, хто посилається на вас і на ваших конкурентів, можна за допомогою нашого Аналізатора беклінків.
Тепер кілька чесних зауважень про цифри.
Дані ми зібрали 4 жовтня 2026 року. Цифра 166 тис. стосується лише пошуку в США.
Розширення дає власну оцінку, і вона інша: близько 237 тис. на місяць. Обидві цифри приблизні, їх розраховують за позиціями в пошуку та частотою запитів, бо ніхто поза командою сайту не може порахувати справжні відвідування.
Наш Website Audit прочитав 0 сторінок, тож тут немає ні звіту аудиту, ні вибірки просканованих сторінок. Натомість того ж дня ми вручну перевірили вихідний HTML.
Ми не перевіряли кожного ШІ-краулера окремо. Ми знаємо лише, що більшість ШІ-краулерів не виконують JavaScript і що у вихідному HTML немає тексту досліджень.
Google його явно виконує, адже окремі дослідження потрапляють у його топ-10. Тож порожній HTML, найімовірніше, шкодить сайту в інструментах ШІ більше, ніж у Google.
Одне число, яке варто запам’ятати
0 слів.
Саме стільки тексту про дослідження отримує краулер зі сторінки ClinicalTrials.gov, поки не запуститься жоден код. У браузері на тій самій сторінці близько 1 700 слів.
Google бере на себе цю додаткову роботу і все одно приводить близько 166 тис. відвідувань на місяць. Більшість ШІ-краулерів цього не роблять.
Це урок для кожного сайту, створеного як застосунок на JavaScript. Якщо ваших слів немає в HTML, деякі читачі їх так і не побачать.
А що каже ваш вихідний HTML? Перевірте його так, як це зробив би краулер.
Кожну з цих перевірок можна запустити для свого сайту й для сайтів конкурентів і побачити ті самі цифри на власні очі.
Часті запитання
Як побачити вихідний HTML моєї сторінки?
У Chrome клацніть правою кнопкою миші на сторінці й виберіть View Page Source (перегляд коду сторінки). Це і є вихідний HTML, і якщо вашого основного тексту там немає, краулери, які не виконують JavaScript, його не побачать.
Чи складно додати рендеринг на сервері?
Залежить від того, як побудовано ваш сайт. Багато сучасних інструментів для створення сайтів вмикають його одним налаштуванням, а для старіших застосунків часто швидше зробити попередній рендеринг ключових сторінок.
Чи карає Google сайти на JavaScript?
Ні. Google може їх читати, але спершу має виконати код, і через цей додатковий крок Google може повільніше читати нові сторінки.
Чим попередній рендеринг відрізняється від рендерингу на сервері?
Рендеринг на сервері збирає кожну сторінку заново, коли її хтось запитує. Попередній рендеринг створює сторінки заздалегідь і віддає збережені копії, а текст в HTML з’являється за обох способів.
Чи виправить файл llms.txt порожню сторінку?
Ні. Він може вказати інструментам ШІ на ваші ключові сторінки, але текст цих сторінок однаково має бути в HTML.
Які структуровані дані підходять для сторінки з дослідженням чи даними?
Для клінічних досліджень підходить MedicalStudy, а Dataset підійде сторінкам, які діляться даними. Заповніть назву, статус, спонсора й дати, які ви вже показуєте на сторінці.
Чи варто закривати від краулерів сторінки результатів пошуку?
Зазвичай так. Їх може бути безкінечно багато, і вони повторюють той самий вміст, тож якщо їх закрити, краулери витрачатимуть час на ваші справжні сторінки.
Як дізнатися, чи можуть інструменти ШІ прочитати мій сайт?
Переконайтеся, що ваш текст є у вихідному HTML і що ваш robots.txt пускає ШІ-краулерів. Потім спитайте інструменти ШІ про вашу тему й подивіться, чи назвуть вони вас.